Как устроено компьютерное зрение?
Мы запускаем камеру на смартфоне, наводим на объект и видим маленькую иконку внизу. Смартфон понимает — что именно мы снимаем. Вы когда-нибудь задумывались, как это работает?
Беспилотные автомобили спокойно объезжают машины и тормозят перед пешеходами, камеры видеонаблюдения на улицах распознают наши лица, а пылесосы отмечают на карте, где лежат тапочки — всё это не чудеса. Это происходит прямо сейчас. И всё благодаря компьютерному зрению.
Поэтому сегодня разберем, как работает компьютерное зрение, чем оно отличается от человеческого и чем может быть полезно нам, людям?
Для того чтобы хорошо ориентироваться в пространстве человеку нужны глаза, чтобы видеть, мозг, чтобы эту информацию обрабатывать, и интеллект, чтобы понимать, что ты видишь. С компьютерным или, даже вернее сказать, машинным зрением, такая же история. Для того, чтобы компьютер понял, что он видит, нужно пройти 3 этапа:
- Нам нужно как-то получить изображение
- Нам нужно его обработать
- И уже только потом проанализировать
Пройдёмся по всем этапам и проверим, как они реализованы. Сегодня мы будем разбираться, как роботы видят этот мир, и поможет нам в этом робот-пылесос, который напичкан современными технологиями компьютерного зрения.
Этап 1. Получение изображения
В начале компьютеру надо что-то увидеть. Для этого нужны разного рода датчики. Насколько много датчиков и насколько они должны быть сложные зависит от задачи. Для простых задач типа детектора движения или распознавания объектов в кадре достаточно простой камеры или даже инфракрасного сенсора.
В нашем пылесосе есть целых две камеры, они находятся спереди. А вот, например, для ориентации в трехмерном пространстве понадобятся дополнительные сенсоры. В частности 3D-сенсор. Тут он тоже есть и расположен сверху. Но что это за сенсор?
LiDAR
Вообще с названиями 3D-сенсоров есть небольшая путаница, одно и тоже часто называют разными словами.
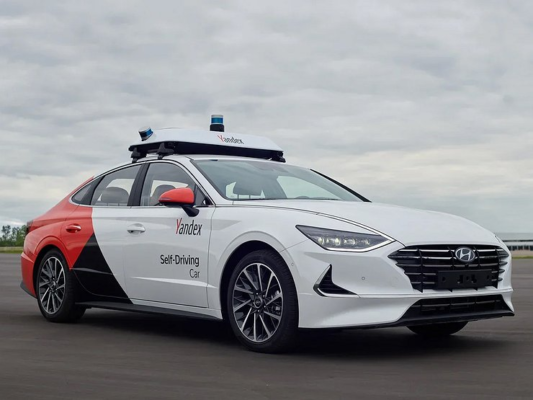
Эта штука сверху — называется LDS или лазерный датчик расстояния, по-английски — Laser Distance Sensor. Подобные датчики вы наверняка могли заметить на крышах беспилотных беспилотных автомобилей. Это не мигалка, это лазерный датчик расстояния, такой же как на роботе пылесосе.
Вот только в мире беспилотников такой сенсор принято называть лидаром — LIDAR — Light Detection and Ranging. Да-да, как в новых iPhone и iPad Pro.

А вот в Android-смартфонах вместо лидаров используется термин ToF-камера: ToF — Time-of-flight.
Но, как ни называй, все эти сенсоры работают по одному принципу. Они испускают свет и замеряет сколько ему понадобится времени, чтобы вернуться обратно. То есть прямо как радар, только вместо радиоволн используется свет.
Есть небольшие нюансы в типах таких сенсоров, но смысл технологии от этого не меняется. Поэтому мне, чисто из-за созвучия с радаром, больше всего нравится название LiDAR, так и будем называть этот сенсор.
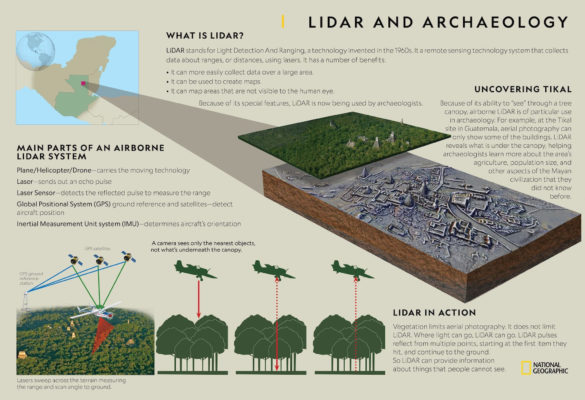
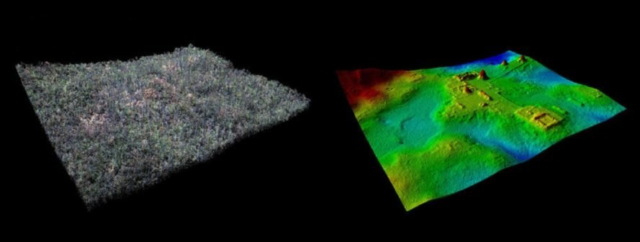
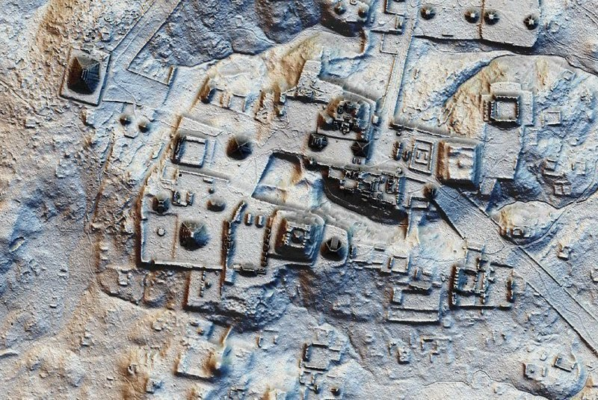
Кстати, лидары использует не только в задачах навигации. Благодаря лидарам сейчас происходит настоящая революция в археологии. Археологи сканируют территорию с самолета при помощи лидара, после чего очищают данные ландшафта от деревьев. И это позволяет находить древние города, скрытые от глаз человека!
Также помимо статических лидаров, направленных в одну сторону, бывают вращающиеся лидары, которые позволяют сканировать пространство вокруг себя на 360 градусов. Такие лидары используется в беспилотных автомобилях, ну и в этом роботе-пылесосе.
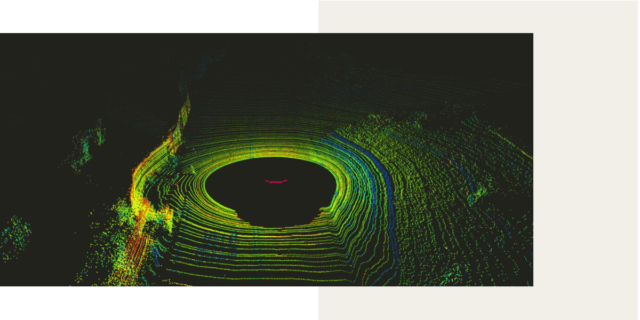
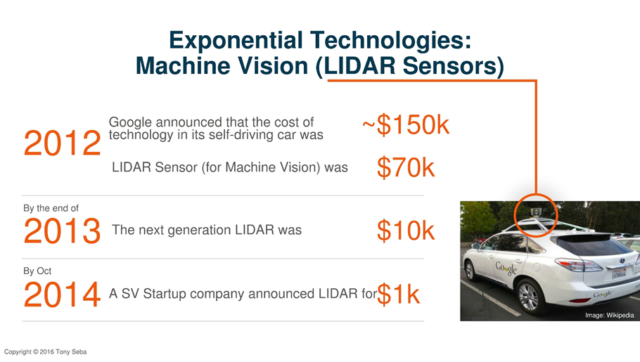
Еще 8 лет назад такие сенсоры стоили каких-то невероятных денег, под 100 тысяч долларов. А теперь у вас по дому может спокойно ездить маленький беспилотник.
Лидар в пылесосе
Окей, тут лидар используется для построения карты помещения и это не новая история. Такую технологию мы видели еще года 3-4 назад.
Благодаря лидару и построенной карте, пылесос ездит не рандомно как скринсейвер в Windows, стукаясь об углы, а аккуратно проезжая всю площадь (модели без лидаров обычно катаются странно).
Но внутри пылесоса стоит, на секундочку, восьмиядерный Qualcomm Snapdragon 625 (Qualcomm APQ8053), поэтому у него хватает мозгов не только построить карту, но и ориентироваться по ней.
Более того пылесос может хранить в памяти до четырёх карт и распознаёт этажи. Это существенно ускоряет уборку. Потому при переносе с этажа на этаж пылесос это может понять и не тратит время, чтобы построить карту заново.
Также каждую из 4 карт можно поделить на 10 специальных зон. Для которых можно настроить свои параметры уборки: мощность всасывания (до 2500 Па), количество проходов и прочее. А куда-то можно вообще запретить ездить. Можно даже выбирать сухую и влажную уборку для разных зон. Правда для этого не нужно подключать/отключать отдельный резервуар с водой. И всё это стало возможно благодаря лидару.
Тем не менее у технологии есть некоторые недостатки — очень разреженные данные. Пространство сканируется линиями. В больших автомобильных радарах разрешение — от 64 до 128 линий. Плюс ко всему у лидар есть мертвая зона. Если лидар стоит на крыше — то он не видит, что творится в достаточно большом радиусе вокруг него.
Также в роботе-пылесосе лидар тут сканирует пространство всего одним лучом. Поэтому, всё что он видит — это тонкая линия на высоте где-то 9-10 сантиметров от пола. Это позволяет определять где стены и мебель, но он не видит того, что валяется на полу.
Две камеры
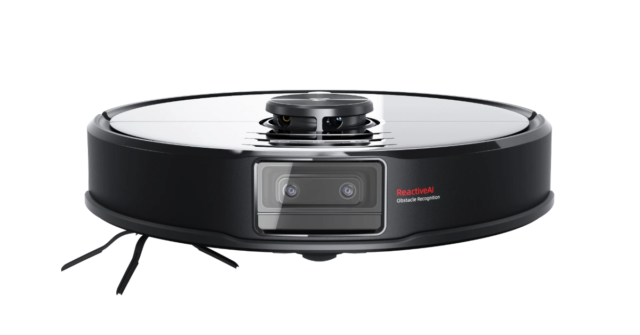
Поэтому, чтобы исправить этот недочет лидаров. как в автомобили, так и в пылесосы ставят дополнительные камеры. Тут камеры сразу две, и они обеспечивают стереоскопическое зрение. Да-да, у пылесоса всё как у людей — два глаза.
Две камеры, во-первых, позволяют убрать мертвую зону впереди пылесоса. А во вторых позволяют достаточно точно определять расстояние до валяющихся на полу предметов.
Это позволяет пылесосу обнаруживать предметы размером не менее 5 см в ширину и 3 см в высоту и объезжать их.
Этап 2. Обработка
Итак, мы получили достаточно данных с различных сенсоров. Поэтому переходим ко второму этапу компьютерного зрения — обработке.
Данные с лидара мы получаем в виде трехмерного облака точек, которые фактически не нуждаются в дополнительной обработке.
Как получить стерео с двух камер тоже понятно — высчитывается разница между изображениями снятыми чуть под разным углом и так строится карта глубины. Это несложно.
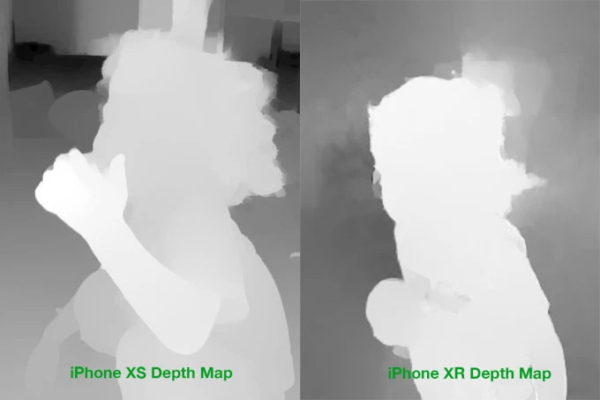
Но вот совместить данные с разных сенсоров — это нетривиальная задача.
Например, пылесос на полу обнаружил какой-то предмет. Дальше ему нужно понять где именно он находится на карте построенной при помощи лидара. А также нужно предположить какие у него габариты по проекции с одной стороны. То есть нам нужно поместить предмет в некий объёмный куб правильного размера.
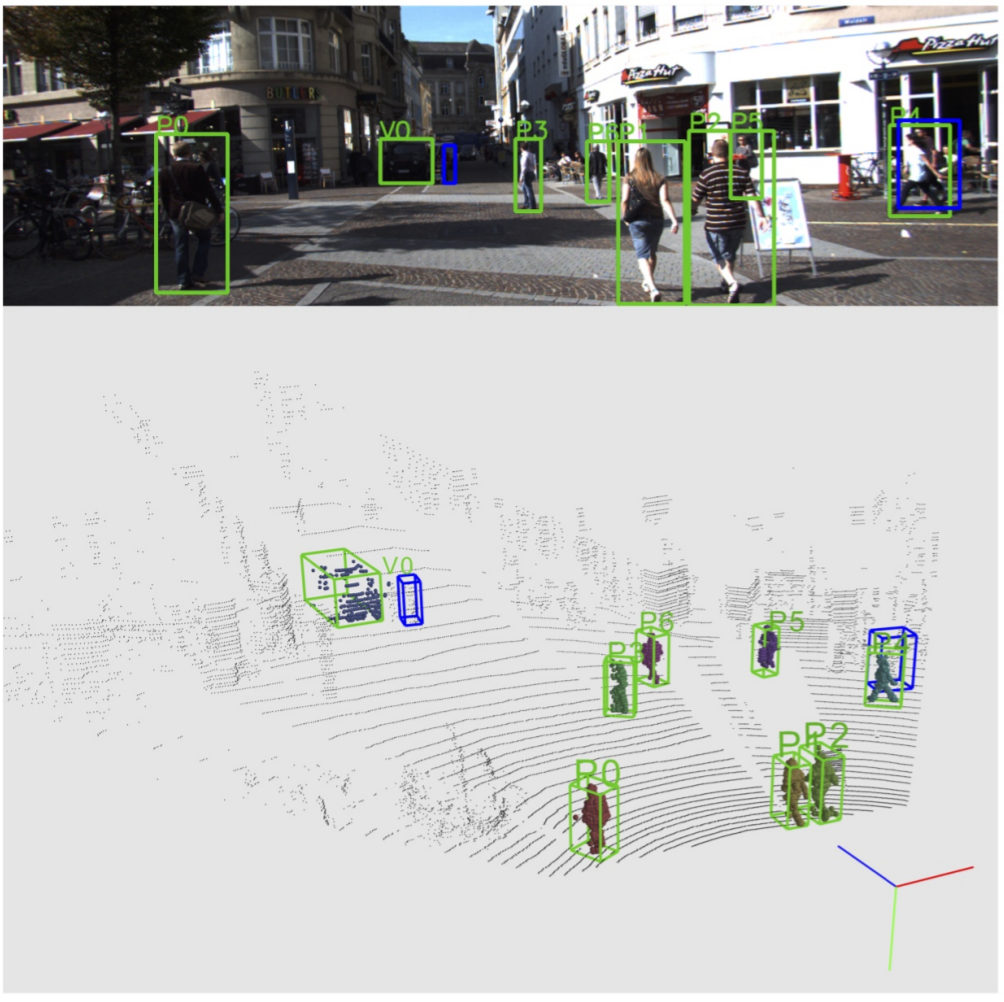

Эту задачу можно решить разными способами. Один из способов называется “усеченная пирамида”. Сначала на камере обнаруживаются предметы. Потом эти предметы помещаются в конус, а объем этого конуса вычисляется нейросетью.

Поэтому даже, казалось бы, такая тривиальная задача требует серьёзных вычислений и решается при помощи нейросетей.
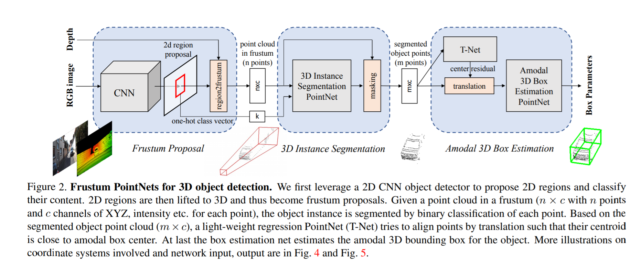
А раз мы заговорили про нейросети, значит мы уже немного зашли на 3-й этап компьютерного зрения — анализ.
Этап 3. Анализ
За распознавание, сегментацию и классификацию объектов на изображении в современном мире в основном отвечают нейросети. Мы даже делали подробный ролик о том как это работает, посмотрите.
Если кратко, нейросеть — это такое большое количество уравнений, связанных между собой. Загружая в нейросеть любые данные — ты обязательно получишь какий-то ответ.
Но, например, если постоянно загружать в нейросеть фотографии кошечек, и указать ей, что ответ должен быть — кошка. В какой-то момент, нейросеть перестает ошибаться на обучающей выборке. И тогда ей начинают показывать новые незнакомые изображения и если на них она тоже безошибочно определяет кошек — нейросеть обучена.
Дальше нейросеть оптимизируется для того, чтобы она стала меньше, быстро работала и не жрала много ресурсов. После этого она готова к использованию.
Что-то похожее происходит с нейронными связями в человеческом мозге. Когда мы чему-то учимся или запоминаем, мы повторяем одно и то же действие несколько раз. Нейронные связи в мозге постепенно укрепляются и потом нам это легко даётся!
Например, в данном пылесосе за работу нейросети отвечает встроенный NPU-модуль. Всё-таки внутри Snapdragon, пылесос может себе такое позволить.
Нейронка предобучена определять различные предметы домашнего обихода: игрушки, тапочки, носки, всякие удлинители, зарядки и даже неожиданности от домашних животных.
Распознавание предметов происходит при помощи гугловской библиотеке Tensorflow. Алгоритм самообучается и умнеет от уборки к уборке.
Практика
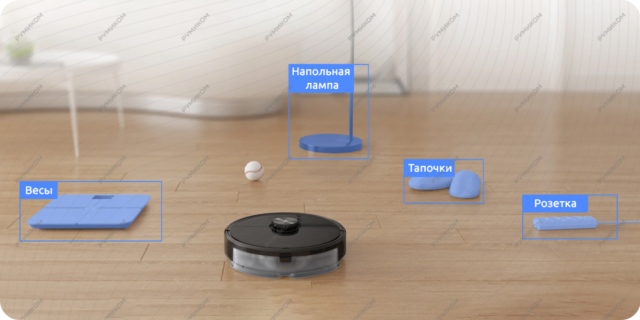
В нашем роботе-пылесосе технология распознавания называется Reactive AI. Мы протестировали насколько она хорошо работает на практике.
Кайфовая штука, что все найденные предметы пылесос отмечает не карте. Поэтому теперь, я не обещаю, но такое возможно, вы всё-таки обнаружите логово пропавших носков.
Проследить за тем, что видит пылесос всегда можно через фирменное приложение или Mi Home от Xiaomi. Можно даже просто кататься по дому управляя пылесосом слать на него голосовые сообщения. Управлять пылесосом можно также через Google Ассистента или Алису. Всё на русском языке.
С недавних пор бренд начал официально продаётся в России, поэтому устройства полностью локализованные.
Внутри кстати стоит батарейка на 5200 мАч, которая способна выдержать до 3 часов уборки.
Итоги
Ребят, ну вы сами всё видели. Правда, стоит обратить внимание, что пока корректное распознавание предметов работает только если запускать пылесос через специальное приложение. И это нюанс, поскольку оно пока недоступно в Play Market Россия. Но в течение нескольких месяцев оно появится.
1. Overview:

In layman’s term, Computer vision (CV)is a branch of computer science which aims to replicate the way how a human’s vision works to a computer. Giving a computer/ a robot/ a machine the sense of vision.
Computer Vision allows computers to identify and extract data/ information from the objects found in images, videos, and real-life. Visual data can be very difficult for computers to understand. Humans make sense of what we see based on our experiences and memories. We’ve been training our brains since the day we were born, which puts computers at a disadvantage when it comes to interpreting visual information. And that’s where the genius of computer vision comes in. With support from artificial intelligence, neural networks, deep learning, parallel computing, and machine learning, computer vision helping to bridge the gap between computers seeing and computers comprehending what they see.
2. So How does Computer vision works?
What computer vision does is simple, it is understanding the image. This also implies videos, as it is technically a collection of images (frames). Understanding an image is a quite a complex and lengthy problem. Rather people identify certain tasks in the image understanding requirements, and only do that.
There are several tasks in image understanding; some are low level tasks that are used in various others, while some are high level tasks. Some of the low level tasks are:
- Image cleaning
- Image segmentation
- Histogram analysis
- Image color space translation
- Image transformation
- Image edge detection and contours, lines approximation & etc.
Some of the high level tasks (that usually uses the low level ones) are:
- Object detection
- Object recognition
- Object segmentation and localization
- Object tracking
- Feature extraction
- Feature, color correction
- Feature reconstruction, approximation & etc.
All the computer vision problem has a similar approach of understanding what is in the scene. We do this by looking into different colors, then shadows, stoke, etc to recognize different images and what’s inside it, we still use the same approach but with a much efficient technique. So various methods were chosen eg: In CCTV footage you need to track the moving objects then you just need to compare each of the frames and see what pixel value is changing. Now the CCTV are still cameras, the background always remains constant the pixel value remains the same, the only moving object will have a variable pixel value. This is recognized as the object.
But how does the modern approach work? currently, this is done with a type of neural network called a convolutional neural network. This is a specific type of network which could recognize the features in an image. These networks are a sequential arrangement of something called conventional layers.
3. Applications of Computer Vision:
There are a lot of industries & areas where CV can be implemented. Here I have mentioned few important and successful areas where CV is being used extensively.
- Google Lens.
- Robotics.
- Manufacturing Industries( Defect detection, assembly line, etc)
- Security Systems.
- VR/AR
- Smartphones
- Automated Vehicles.
- Medical Imaging ( MRI reconstruction, automatic pathology, robots aided surgery etc)
These are only a very tiny part of the whole amount of applications that computer vision has.
4. Math behind Computer Vision
Getting started with computer vision requires that you are comfortable with maths such as:
- Linear algebra : Matrices, Vectors, Singular value decomposition (SVD). Especially how to use it.
- Numerical optimization : First order optimization methods, Second order optimization methods.
- Probability and statistics : Random variables, Probability distribution functions, Bayes theorem.
5. How to learn CV — What I did….
The first step is I understood the basics of computer vision and the maths behind that.
Started with simple object detection, features filtration, face detection, animating the faces, art with Machine learning projects.
First, downloaded OpenCV and tried out some sample code such as static image matching, object detection and classification etc to get hands on with the code. There was an article in internet sorry unfortunately I did not save it, But with little effort you could find it easily. It was about an intriguing project using a cam (can be your phone’s, lap’s or any cam) It detects the faces of the people and checks out in the database for their face features, once successfully matched then it’ll automatically register the attendance in the excel sheet. This was my first coolest project with CV.
Irrespective of what subject you learn, Once you get hands-on experience you will get confidence, you’ll get more innovative ideas, you’ll get cool and good feel.
A quick & effective path :
1.Take online courses in order to gain domain expertise or improve knowledge.
2.Understand programming patterns and principles, such as object orientated programming.
3. Use machine libraries and framework.
4. Read practical ML/DL books
5. Be aware of cloud services such as GCP, AWS etc
6. Understand Deep Learning fundamentals
7. Practice makes the man perfect : Experiment & Play with it.
Feel Free to contact me for guidance and help in Robotics, CV & ML. Looking forward to learn along with you.
Thanks for reading,
Что такое компьютерное зрение и где его применяют

Об эксперте: Роман Коновалов, президент группы компаний «СиДиСи».
Компьютерное зрение (Computer Vision, CV) — это область искусственного интеллекта, связанная с анализом изображений и видео. Она включает в себя набор методов, которые наделяют компьютер способностью «видеть» и извлекать информацию из увиденного.
Системы состоят из фото- или видеокамеры и специализированного программного обеспечения, которое идентифицирует и классифицирует объекты. Они способны анализировать образы (фотографии, картинки, видео, штрих-коды), а также лица и эмоции.
Чтобы научить компьютер «видеть», используются технологии машинного обучения. Собирается множество данных, которые позволяют выделить признаки и комбинации признаков для дальнейшей идентификации похожих объектов.
По данным исследования TAdviser, с 2018 по 2023 год объем отечественного рынка решений в этой сфере увеличится в пять раз до 38 млрд рублей. Наибольшую долю в нем занимают решения в области видеонаблюдения и безопасности — 32%, промышленности — 17%, медицины — 14%, торговли — 10%.
Для чего бизнесу компьютерное зрение?
- Безопасность. Практически во всех сферах применимы системы контроля доступа на основе распознавания лиц: от бизнес-центров и офисов компаний до банков и ресторанов.
- Сервис. За счет быстрой идентификации по лицу можно сократить время обслуживания клиента и предложить персональные услуги.
- Усиление человеческих возможностей. Компьютерное зрение позволяет увидеть то, что человек может не заметить. Особенно актуально это в медицине (анализ рентгеновских и других снимков) и промышленности (обнаружение брака).
- Сокращение времени на рутинные задачи. Распознавание, как правило, занимает несколько секунд.Человек будет рассматривать полку в магазине на предмет правильности выкладки товаров намного дольше.
- Автономность. Без компьютерного зрения невозможно развитие беспилотного транспорта и роботов.
В чем проблема?
Для дальнейшего распространения систем компьютерного зрения в бизнес-среде разработчики решают проблему быстродействия и стабильности систем.
Сейчас камеры передают данные на сервер, где с помощью специального ПО происходит распознавание. Системе нужен постоянный доступ к высокоскоростному интернету. Передача данных на сервер замедляет процесс. Проблемы с Сетью вообще останавливают его.
Поэтому появляются автономные решения. Например, резидент «Сколково», компания «ИРЦЭ», совместно с ГК «СиДиСи» разработали «ядро», способное распознавать образы прямо в мобильном устройстве без обмена информацией с серверами. При этом точность распознавания доведена до 98%. На основе этого «движка» может быть создано решение для разных отраслей и целей.
Главные тренды последних лет в компьютерном зрении
На конференции OpenTalks AI, посвященной искусственному интеллекту, эксперты обозначили главные тренды в CV:
- На первый план выходят генеративно-состязательные модели нейросетей. Такие, как GAN — это генеративно-состязательная нейросеть, которая состоит из генератора и дискриминатора. Ян Лекун, директор Facebook по исследованиям искусственного интеллекта, назвал ее «самой интересной идеей в машинном обучении за последние десять лет». Генераторы в GAN генерирует входные данные, а дискриминаторы оценивают их подлинность и классифицируют по категориям, используя определенный набор признаков.
- Развитие генеративно-состязательных сетей позволило совершить качественный скачок в распознавании и генерации человеческих лиц. Те же GAN создают максимально реалистичные изображения, которые неотличимы от реальных фото или живописи. Правда, с изображениями животных дела пока обстоят намного хуже.
- Помимо статичных изображений все большее распространение получают нейроаватары — движущиеся изображения на основе 1-32 фото, таймплампсы на основе фото пейзажа и моделирование 3D-сцен на основе панорамных фотографий. Следующий шаг — анимирование фотографий с помощью специальных алгоритмов.
Что такое моделирование 3D сцен?
Еще в 2009 году Дэвид Маккиннон из Технологического университета в Квинсленде (Австралия) разработал программу 3DSee, которая генерирует 3D-модели на основе 5-15 фотографий. Важное условие: все фотографии должны пересекаться как минимум на 80-90%. На разработку у Маккиннона ушло восемь лет. Следующий шаг — автоматическая генерация 3D-моделей в высоком разрешении, как в сцене с пулями из «Матрицы».
Создание 3D-сцен востребовано в строительстве, дизайне интерьера, военном деле, анимации. В Голливуде уже используют эту технологию, чтобы с точностью воспроизвести освещение, расположение актеров и декораций — для экономии средств на технически сложных съемках. Производители обучают на таких 3D-моделях роботов, которым нужно передвигаться в пространстве по определенному маршруту и преодолевать препятствия. 3D-сканеры подходят для аутентификации личности, виртуальной примерки одежды и многих других вещей. Уже сейчас с помощью смартфона можно отснять человека с разных ракурсов и получить 3D-аватар.
Виктор Лемпицкий, глава Samsung AI Center, профессор Skoltech, в своем докладе на OpenTalks AI отметил, что именно моделирование 3D-сцен было в центре внимания специалистов по CV в 2020 году. Пока что нейросетям сложно в деталях воспроизводить некоторые текстуры — такие, как листва деревьев или прическа — и создавать полноценные модели в 360°. Но в ближайшем будущем они заменят 3D-дизайнеров и аниматоров: смогут сами создавать рендеры зданий и интерьеров, анимированные презентации и VR-симуляции объектов. К примеру, технология NeRF от Google уже генерирует реалистичные объемные изображения, которые используют для создания AR и VR-среды.
Поиск плагиата при помощи компьютерного зрения
С помощью алгоритма Eora Mage можно за пять секунд найти похожий логотип. Это удобно, если вы только выбираете изображение и не хотите: чтобы кто-то из конкурентов подал на вас в суд.
Технологию использует в своей работе патентное бюро «Интэлс», которое регистрирует логотипы и товарные знаки. На этапе регистрации специалистам нужно убедиться, что такой товарный знак еще не регистрировали, и у клиента не будет юридических проблем. Раньше патентовед почти месяц вручную перебирал всю базу и готовил отчет, куда включал до 100 похожих изображений. Теперь на это уходят секунды, а точность алгоритма — от 80%.

Компьютерное зрение в ретейле: умные весы и оплата улыбкой
Поставщики товаров в крупные торговые сети начали снабжать мерчендайзеров планшетами со специальным ПО для распознавания фотографий. Вместо того чтобы проверять наличие товаров, его расстановку и актуальность ценников вручную, торговый представитель просто фотографирует полку. Система сравнивает ее с планограммой и выдает рекомендации: какого товара не хватает, что стоит не на своем месте, где перепутаны ценники или не указана текущая акция. Анализируя полки конкурентов, система мониторит долю полки в динамике.
Например, корпорация Mars реализовала пилотный проект внедрения такой системы в своем подразделении в Казахстане. По итогам пилота принято решение о масштабировании проекта еще в десяти странах присутствия компании.
Запущены пилотные проекты в России, когда системы распознавания и видеоаналитики используются для анализа посещаемости торговых точек, перемещения покупателей, среднего времени пребывания в очереди. Это позволяет оптимизировать рабочий график персонала и сделать пребывание в магазине более комфортным, а обслуживание — быстрым.
В апреле этого года X5 Retail Group объявила о разработке «умных весов», которые с помощью технологии компьютерного зрения идентифицируют товар при взвешивании на кассе. Ритейлер планирует установить 500 таких весов в 100 магазинах сети «Пятерочка». Инновация должна ускорить обслуживание покупателей на кассах.
Платить за покупку улыбкой, выявлять недовольных обслуживанием клиентов, таргетировать рекламу в торговом зале исходя из возраста и пола человека, примерять вещи в виртуальной примерочной — такие проекты уже есть. Пока единичные, но в перспективе пяти-десяти лет они станут повсеместными.
Например, платежная система Alipay начала тестировать систему оплаты на основе компьютерного зрения в 2017 году, реализовав пилотный проект в одном из китайских ресторанов KFC. И теперь в Китае оплата «улыбкой» не является чем-то сверхъестественным, а в борьбу за этот рынок вступила платежная система WeChat Pay. Оплатить покупки, просто улыбнувшись в камеру у кассы, можно в супермаркетах CP Lotus в Пекине и сотнях других магазинов по всей стране.
Международная сеть WalMart тестировала систему, которая при обнаружении покупателя с несчастным лицом оповещала об этом сотрудников магазина. Два года назад эксперимент с распознаванием эмоций покупателей провели в «ДоДо-Пицца». Это позволило компании оценить качество работы сотрудников, мотивировать их «собирать улыбки».
Компьютерное зрение в промышленности: надень каску!
Кроме систем контроля доступа технологии распознавания используются для обеспечения безопасности работников. Например, системы видеоаналитики следят за ношением средств индивидуальной защиты на опасных производствах: если на человеке нет каски, маски, перчаток, яркого жилета, он получает уведомление. Сигнал отправляется и его руководству.
На пультах центрального управления, где важно соблюдать высокий уровень концентрации и не отвлекаться, системы распознавания лиц следят за состоянием специалистов. Если у человека снижается внимание или он засыпает, пользуется телефоном или отходит от своего поста, он и вся команда получают предупреждение.
CV-технологии начинают применяться для контроля качества производимых изделий: видят дефекты, помогая на ранней стадии отсеять брак, проверяют размеры, определяют верные расстояния, считывают маркировку компонентов при сборке на конвейере. Экономия достигается за счет минимизации ошибок и брака.

Компьютерное зрение в финансах: получить кредит лицом
Благодаря компьютерному зрению лицо становится новым ID человека. В том числе для получения финансовых услуг. Пока бумажный паспорт никто не отменял, но идентификация по лицу позволяет обеспечить 100% защиты от мошенников, предъявляющих чужой документ.
Развивается технология подтверждения лицом операций в мобильном приложении. Системами распознавания скоро будут оборудованы и банкоматы.
Компьютерное зрение в медицине: окровавленные губки
Компьютерное зрение становится виртуальным помощником врача. Технологии анализируют медицинские изображения — рентгеновские снимки, МРТ и УЗИ, помогая повысить точность диагностики заболеваний. Например, проект Microsoft InnerEye помогает быстро и точно найти опухоли на снимках МРТ. Компания из Калифорнии Gauss Surgical разработала систему, позволяющую принимать решения о необходимости переливания крови: она анализируют ее потерю по наполняемости хирургических губок во время операции или во время родов. Разработка также ведет учет губок для того, чтобы врач случайно не забыл их внутри (такое происходит в одной из 5,5 тыс. операций, по данным компании).
Без компьютерного зрения не смогут «работать» и роботы-хирурги, которые скоро выйдут во многие операционные. Эпидемия коронавируса уже стала толчком для развития телемедицины. Здесь системы распознавания помогут провести первичную диагностику некоторых заболеваний по фотографии.
Нейросетевые алгоритмы также помогают улучшить качество снимков рентгена и КТ, убрав лишние шумы и искажения. Это позволяет пациентам меньше времени находиться в аппарате и снизить дозу облучения до 25% от обычной. В будущем компьютеры на базе ИИ смогут полностью заменить КТ и рентген-аппараты, чтобы сразу получать высококачественные снимки с минимальной дозой облучения. Для так называемого НДКТ-скрининга достаточно и 10% данных от КТ. Такие технологии применяют в Philips и компании «Третье Мнение» при разработке ИИ-решений для медицины.
Компьютерное зрение в смартфонах
В современных моделях смартфонов используют технологии, которые помогают обрабатывать изображение еще в процессе съемки. Среди них — LiDAR в iPhone, суперзум в Huawei или Pixel в Google. Специальные алгоритмы делают несколько снимков, сопоставляют их и выводят идеальное по цвету и качеству изображение. При этом они рассчитывают световые потоки, строят объемные модели и производят другие вычисления на базе компьютерного зрения. С помощью камеры смартфона можно даже создать 3D-модель пространства, предмета или человека.
Однако это не единственное, на что способно CV. В Google создали приложение для смартфона Project Guideline, позволяющее слепым заниматься бегом. Оно работает на Android и iOS, озвучивает подсказки, текст и изображения, а также поддерживает голосовой ввод. Так приложение помогает бегуну понять, что за объекты его окружают и как ему строить свой маршрут. Оно даже распознает эмоции на лицах людей, которые встречаются на пути.
Компьютерное зрение OpenCV: где применяется и как работает в Python
Рассказываем, как компьютеры анализируют изображения, и учим их распознавать лица.

Иллюстрация: Оля Ежак для Skillbox Media
Обучая маленьких детей, родители показывают им книжки с яркими цветными картинками: вот кошечка, вот цветочек, а вот машинка. И дети учатся отличать объекты друг от друга.
Компьютеры обучают распознавать изображения похожим образом — только изображений показывают в тысячи раз больше. Эта технология называется компьютерным зрением.к
Как устроено компьютерное зрение
Компьютерное зрение — область искусственного интеллекта, связанная с получением, обработкой и анализом визуальной информации: изображений и видео.
Разберём определение на примере. Взгляните на эту картинку и опишите, что на ней изображено:
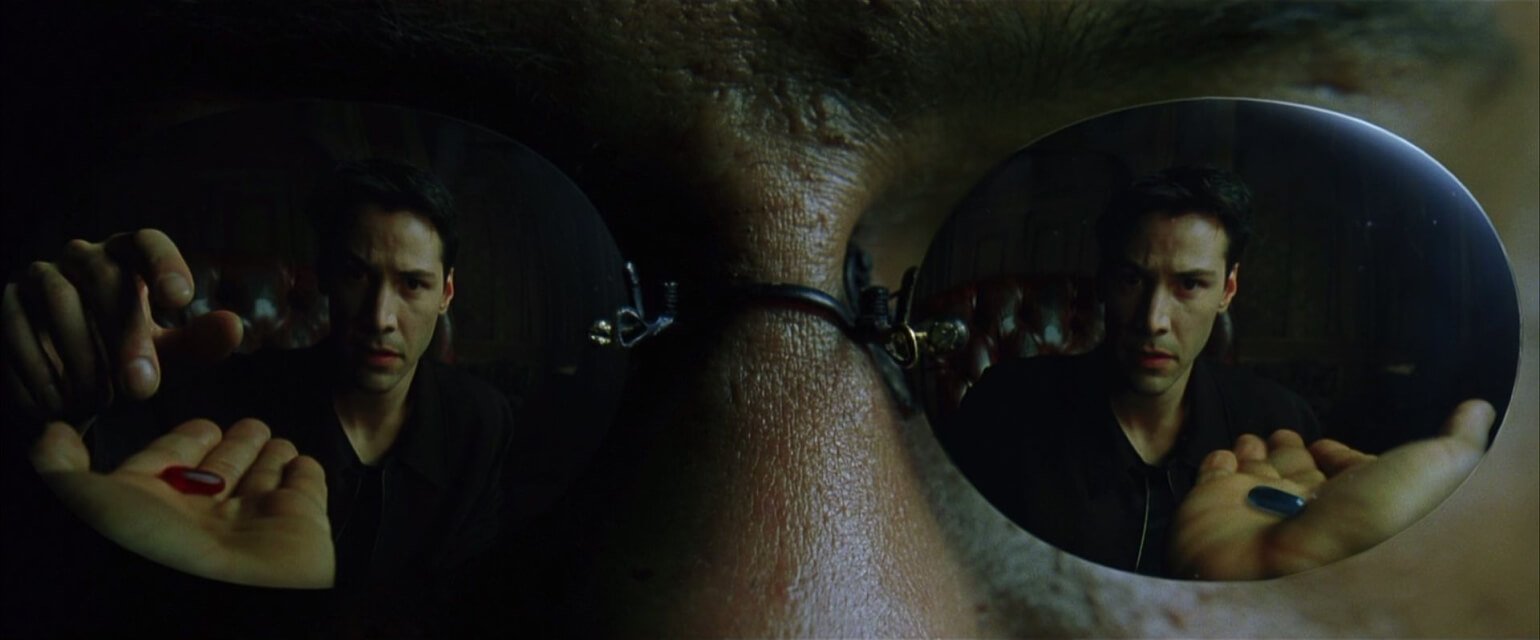
Взгляд сразу выхватывает отдельные объекты. Тёмные очки, в одной линзе отражается человек, ладонь, красная таблетка, в другой — тот же человек, другая ладонь, синяя таблетка.
Если человек смотрел «Матрицу», он назовёт фильм, узнает персонажей и, возможно, даже вспомнит имена актёров — в зависимости от того, насколько он любит кинематограф и как много смотрел фильмов.
Что на этом изображении увидит программа, зависит от её бэкграунда, то есть от информации, которая у неё есть, и уровня сложности кода:
- Простенькая программа сможет только распознать, что это файл с расширением .jpg — то есть изображение.
- Программа посложнее откроет файл и поймёт, что он состоит из набора пикселей разного цвета. Она сможет вывести изображение на экран и, возможно, даже отредактировать: изменит цвет части пикселей на другой, обрежет картинку и так далее.
- Если программа работает с помощью нейронных сетей, то она проанализирует изображение и извлечёт из него дополнительную информацию, помимо технической: определит, где на картинке очки, руки, таблетки, лица, найдёт похожие изображения, узнает, из какого фильма кадр и какие актёры в нём играют. Это и есть компьютерное зрение. Набор извлечённой информации будет зависеть от того, чему программу учили.
Чтобы программа умела смотреть на изображение не как на набор пикселей, а как на набор известных ей объектов, используют машинное обучение.
Помимо компьютерного зрения, есть также машинное зрение. По сути, это то же компьютерное зрение, но применяется оно для решения конкретной прикладной задачи. Например, на производстве ставят камеру, которая следит за качеством продукции на конвейере. Если такая камера увидит брак, то она предупредит об этом человека-оператора — и это единственная её задача. В этом случае компьютерное зрение можно назвать машинным зрением.
Что такое OpenCV
OpenCV (Open Source Computer Vision Library) — это библиотека с открытым исходным кодом для работы с компьютерным зрением. Изначально она была написана на C++, но адаптирована для использования на Python, С, Java и MATLAB.
В OpenCV есть встроенные алгоритмы компьютерного зрения на основе машинного обучения в виде отдельных модулей с разной функциональностью. Вот некоторые из них:
- Core Functionality (основная функциональность) — определяет основные структуры данных и функции библиотеки, которые используются в других модулях.
- Image Processing (обработка изображений) — позволяет работать со статичными изображениями: простыми картинками в форматах PNG, JPG и других.
- Video Analysis (анализ видео) — используется для отслеживания движений объектов и работы с фоном.
- Camera Calibration and 3D Reconstruction (калибровка камеры и 3D-реконструкция) — работает с геометрией объектов, позволяя создавать их 3D-модели на основе нескольких изображений или видео.
- 2D Features Framework (фреймворк двумерных особенностей) — определяет фрагменты изображения, которые отличаются от других, запоминая их контуры, и может находить похожие среди них.
- Object Detection (обнаружение объектов) — находит объекты, например лица, автомобили, птиц и другое.
- High-level GUI (высокоуровневый графический интерфейс) — позволяет рисовать графические интерфейсы для выполнения простых операций.
- Video I/O (ввод и вывод видео) — позволяет считывать и обрабатывать видеофайлы.
Это только часть модулей OpenCV. Подробнее о них и о других возможностях библиотеки можно прочитать в документации.
Где применяют компьютерное зрение и OpenCV
Компьютерное зрение уже повсюду в нашей жизни: роботы-пылесосы и автомобили объезжают препятствия, а соцсети находят фотографии с вами и спрашивают, вы ли это.
Компьютерное зрение используют для решения разных задач.
Распознавать текст. Например, чтобы перевести этикетку, можно включить на телефоне приложение-переводчик и навести его на текст. Приложение распознает его и переведёт на нужный язык.
Искать по изображениям. Можно сфотографировать незнакомый цветок и узнать его название, загрузив фотографию в поисковик Google или «Яндекс».
Модерировать контент. Многие форумы и соцсети анализируют контент и автоматически удаляют его, если он нарушает правила платформы.
Использовать биометрию. Чтобы вы могли разблокировать телефон или войти в сервис по отпечатку пальца или лицу, ваши данные обрабатываются алгоритмами компьютерного зрения.
Создавать 3D-модели. Компьютерное зрение позволяет на основе нескольких фотографий или видео создать 3D-модель объекта или пространства. Это используется для восстановления облика объектов и ландшафта, а в робототехнике — чтобы робот мог ориентироваться в помещениях.
Развивать сельское хозяйство. С помощью компьютерного зрения можно считать поголовье скота и следить за посевами: оценивать их состояние, обнаруживать вредителей и болезни до того, как их заметил бы человек.
Управлять производством. Вместо того чтобы полагаться в выполнении рутинных задач на людей, компьютерное зрение может анализировать продукцию и процессы самостоятельно. Например, можно установить камеру, которая будет прямо на конвейере выявлять бракованную продукцию. В отличие от человека, такая система не устанет и не отвлечётся.
Для создания систем с компьютерным зрением подходят разные инструменты. Один из самых популярных — OpenCV. Его используют Google, Yahoo, Microsoft, Intel, IBM, Sony, Honda, Toyota и другие технологические компании для решения разнообразных задач.
Например, с помощью OpenCV в Китае следят за состоянием оборудования в шахтах, а в Японии распознают лица людей. Написать программу, распознающую лица, вы можете и сами. О том, как сделать это, рассказываем ниже.
Как работать с OpenCV в Python
Библиотека OpenCV бесплатна и доступна для использования в личных, образовательных и коммерческих целях. Рассмотрим её базовые функции на примере Python и в итоге напишем скрипт, распознающий лица людей.
Установка OpenCV
Чтобы запустить OpenCV, у вас должен быть установлен поддерживаемый ею язык программирования. В нашем случае это Python. Если у вас он ещё не установлен, можете воспользоваться нашим руководством.
Скачать библиотеку можно с помощью инструментов вашей IDE или с помощью командной строки:
Теперь можно импортировать модуль и приступать к работе:
Как OpenCV видит изображения
Перед тем как переходить к практике, остановимся на том, как OpenCV воспринимает изображения. Библиотека работает с ними как с NumPy-массивами.
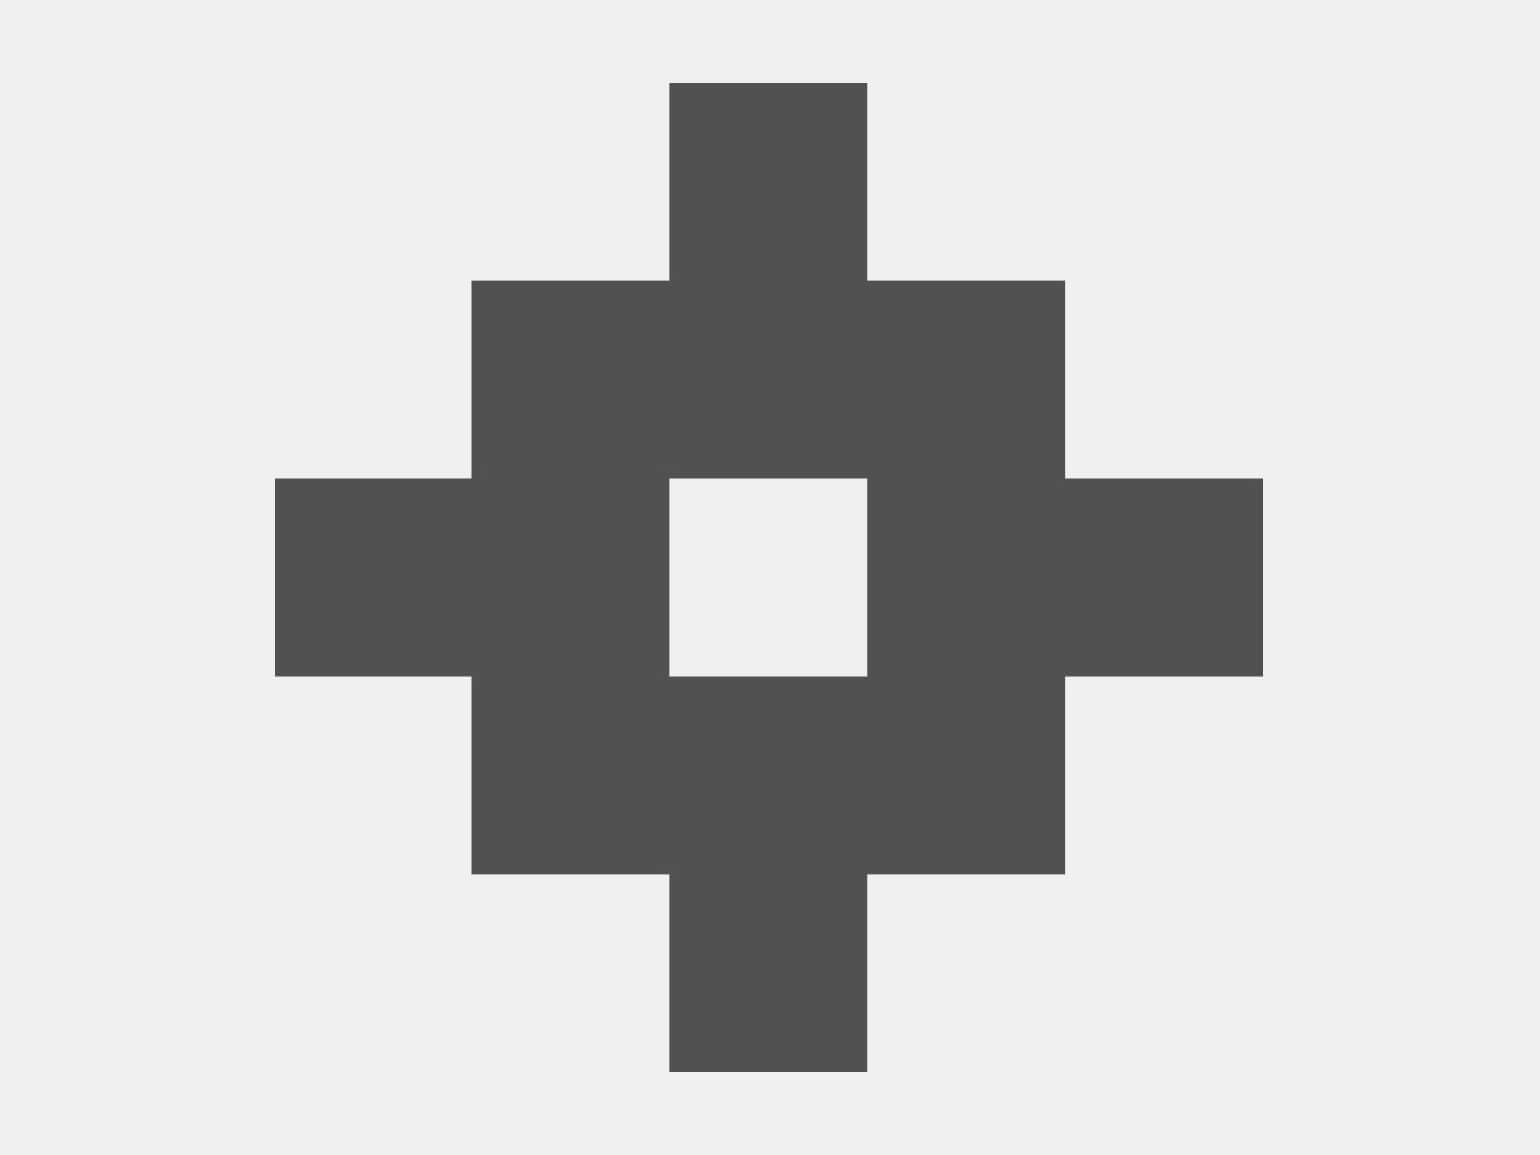
Если изображение в оттенках серого, то массив этот двумерный. Каждый пиксель в изображении представлен в виде числа 0 до 255, где 0 — чёрный, 255 — белый, а всё остальное — оттенки серого между ними.
Каждая пиксельная строка объединена в одномерный массив. Например, [255, 255, 77, 77, 77, 255, 255]. Это строка из семи пикселей: двух белых, трёх серых и ещё двух белых.
Каждая такая пиксельная строка объединена в массив второго уровня. Например:
В итоге получается вот такое изображение, только в 100 раз меньше:
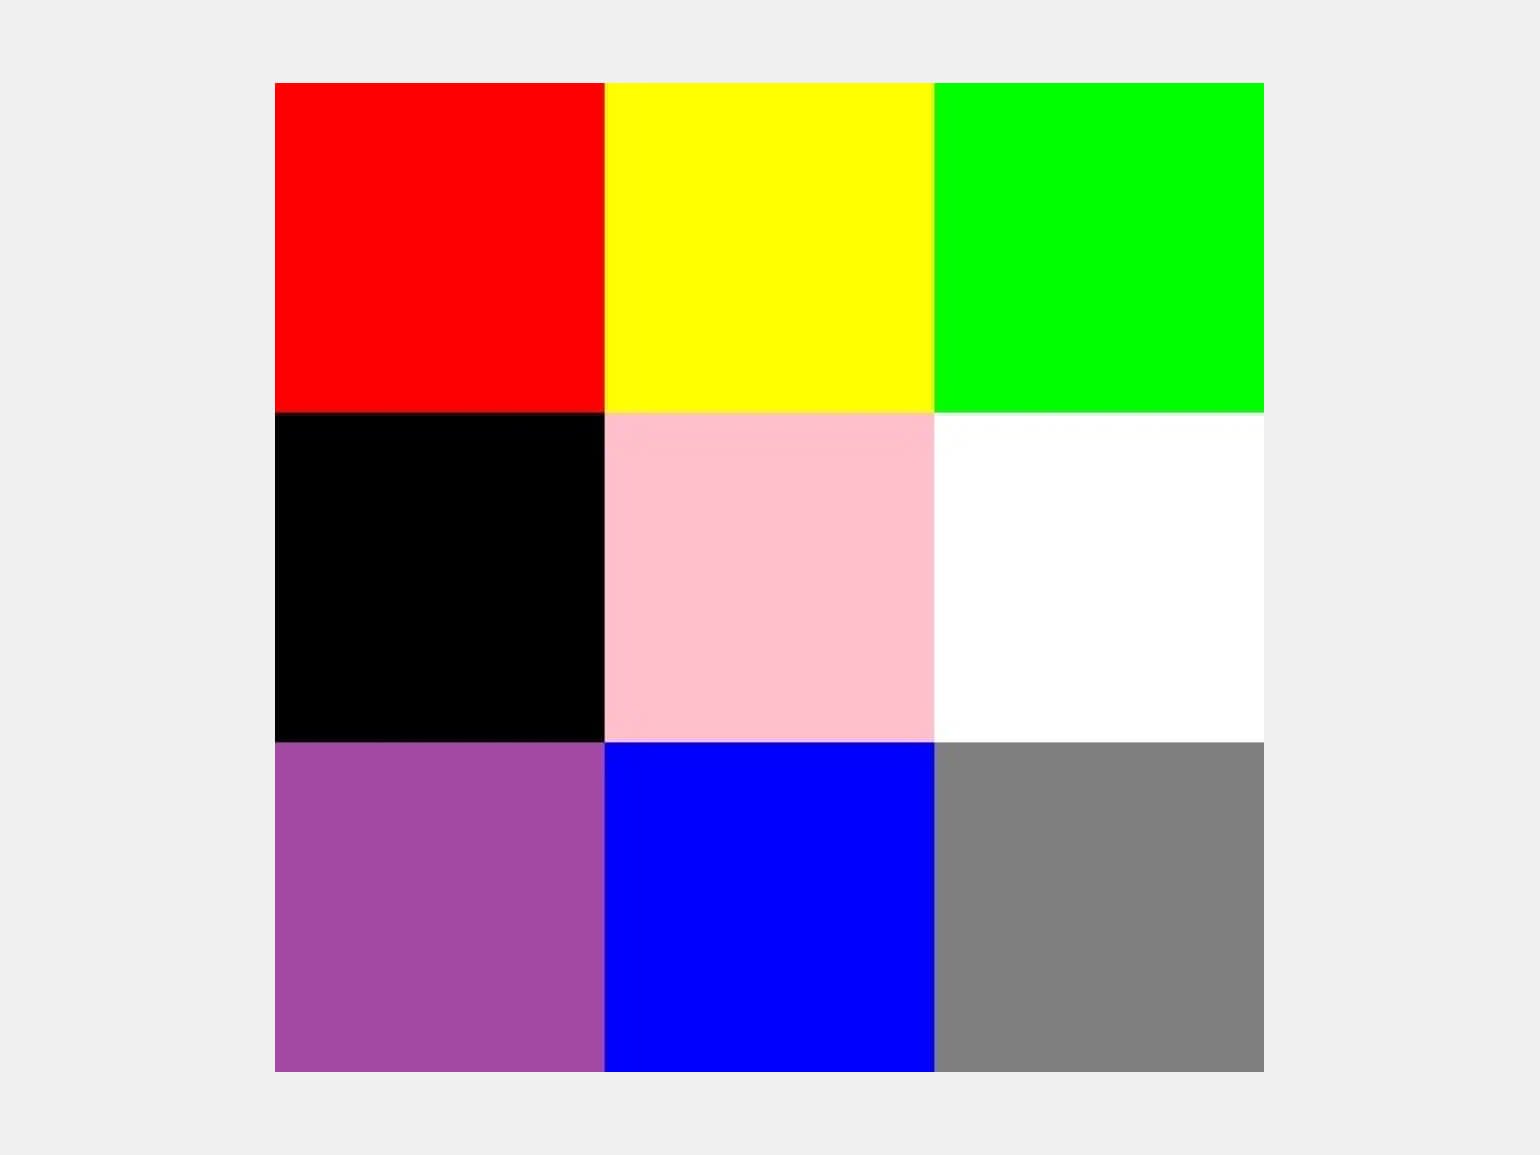
Если изображение цветное, то потребуется трёхмерный массив. Цвет каждого пикселя описывает не одно, а сразу три числа от 0 до 255 — в соответствии с моделью RGB. Только красный и синий цвет переставлены местами, так что первое число отвечает за синий цвет, второе — за зелёный, третье — за красный: получается BGR.
Вот примеры пикселей разного цвета на языке OpenCV:
- [0, 0, 0] — чёрный.
- [255, 255, 255] — белый.
- [255, 0, 0] — синий.
- [0, 255, 0] — зелёный.
- [0, 0, 255] — красный.
- [0, 255, 255] — жёлтый.
- [203, 192, 255] — розовый.
Таблицу распространённых цветов в RGB можно посмотреть здесь. Только помните, что в OpenCV первый и третий цвета переставлены местами.
Как и в случае с изображениями в оттенках серого, массив следующего уровня объединяет строки пикселей, а верхнеуровневый массив — всё изображение.
Вот так в OpenCV будет выглядеть массив для изображения из девяти цветных пикселей:
И само изображение, увеличенное для удобства:
Чтение, режимы отображения и запись
Скачаем любое изображение (желательно яркое и контрастное) и откроем его в нашем коде.
Например, вот такое изображение:
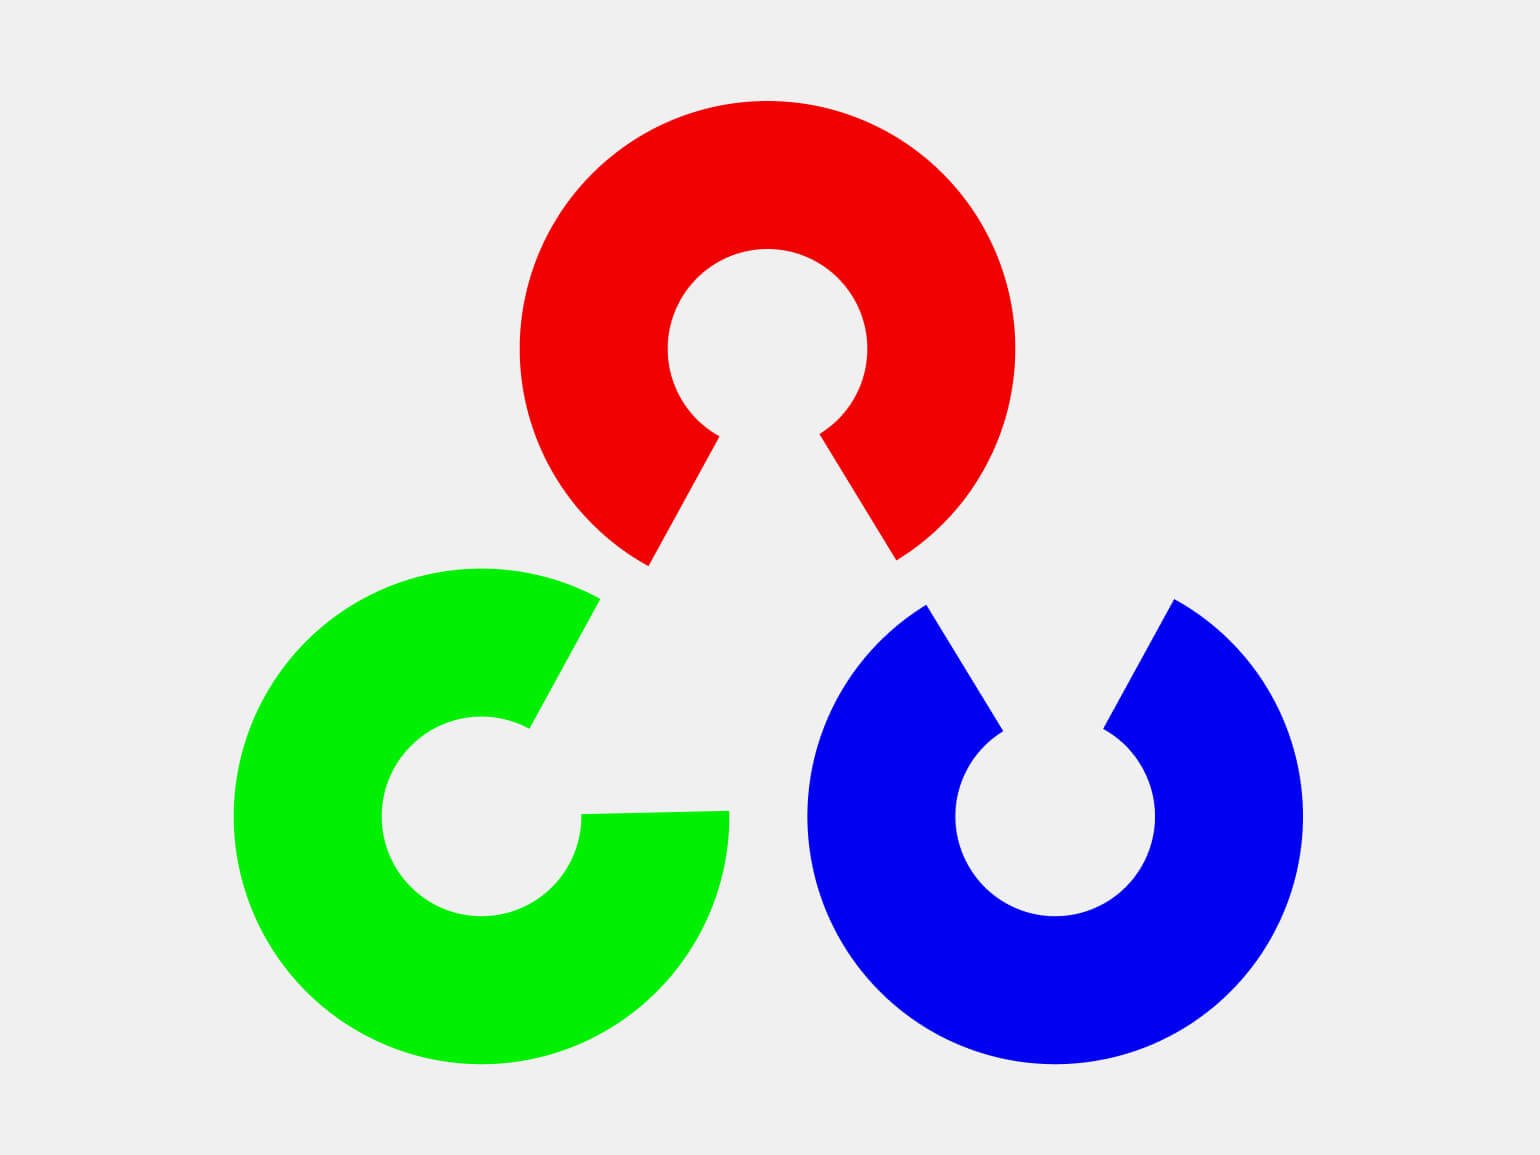
Прочитайте изображение и откройте его в отдельном окне:
- cv2.imread — «читает» изображение и возвращает NumPy-массив, с которым библиотека может работать. В качестве аргумента получает полный или относительный путь к изображению.
- cv2.imshow — открывает изображение в отдельном окне операционной системы. Первым аргументом получает название окна, вторым — NumPy-массив, в нашем случае он хранится в переменной image.
- cv2.waitKey — если не указать эту функцию, то открытое окно тут же закроется. В качестве аргумента получает кнопку, которую нужно нажать, чтобы закрыть окно. Если указать 0, то окно закроется при нажатии любой кнопки.
Можно передать функции cv2.imread необязательный второй аргумент и выбрать режим отображения:
- cv2.IMREAD_COLOR (по умолчанию) — цветное отображение в формате RGB.
- cv2.IMREAD_GRAYSCALE — отображение в оттенках серого.
Таким образом, функцию cv2.imread можно использовать, чтобы обесцветить цветное изображение:
Вот что получится:
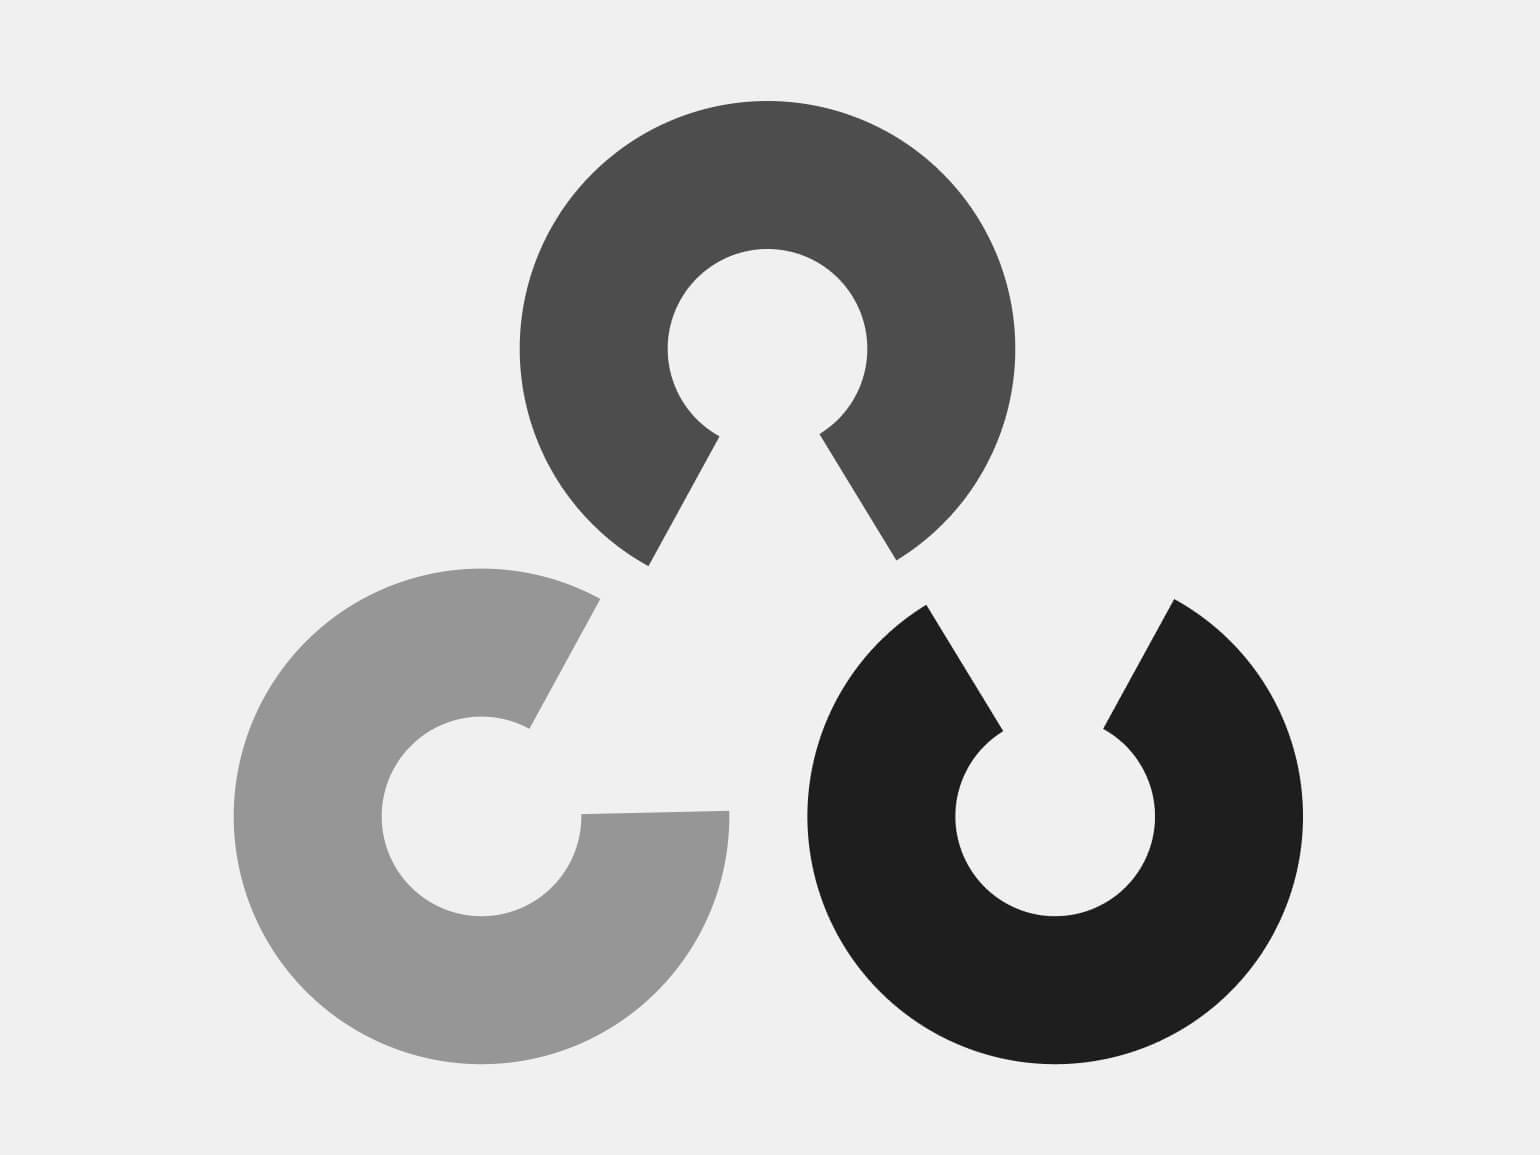
Чтобы сохранить новое изображение в отдельный файл, используйте функцию cv2.imwrite:
Первым аргументом функция принимает название нового файла с картинкой, вторым — NumPy-массив с данными изображения.
Изменение цвета пикселей
OpenCV позволяет обращаться к пикселям по их записи в NumPy-массиве. Так мы можем менять изображение.
Для начала получим доступ к пикселю. Для этого обратимся к нему по координатам. Сначала указываем координаты ширины, потом — высоты. Например:
Теперь изменим цвет пикселя. Для этого обратитесь к нему по координатам и сделайте его синим. Помните, что синий и красный переставлены местами:
Если открыть изменённое изображение, то в правом верхнем углу вы увидите чёрную точку размером с один пиксель.
При ручной замене полезно знать размеры изображения. Для этого воспользуйтесь функцией image.shape:
- image.shape[0] — высота изображения в пикселях.
- image.shape[1] — ширина изображения в пикселях.
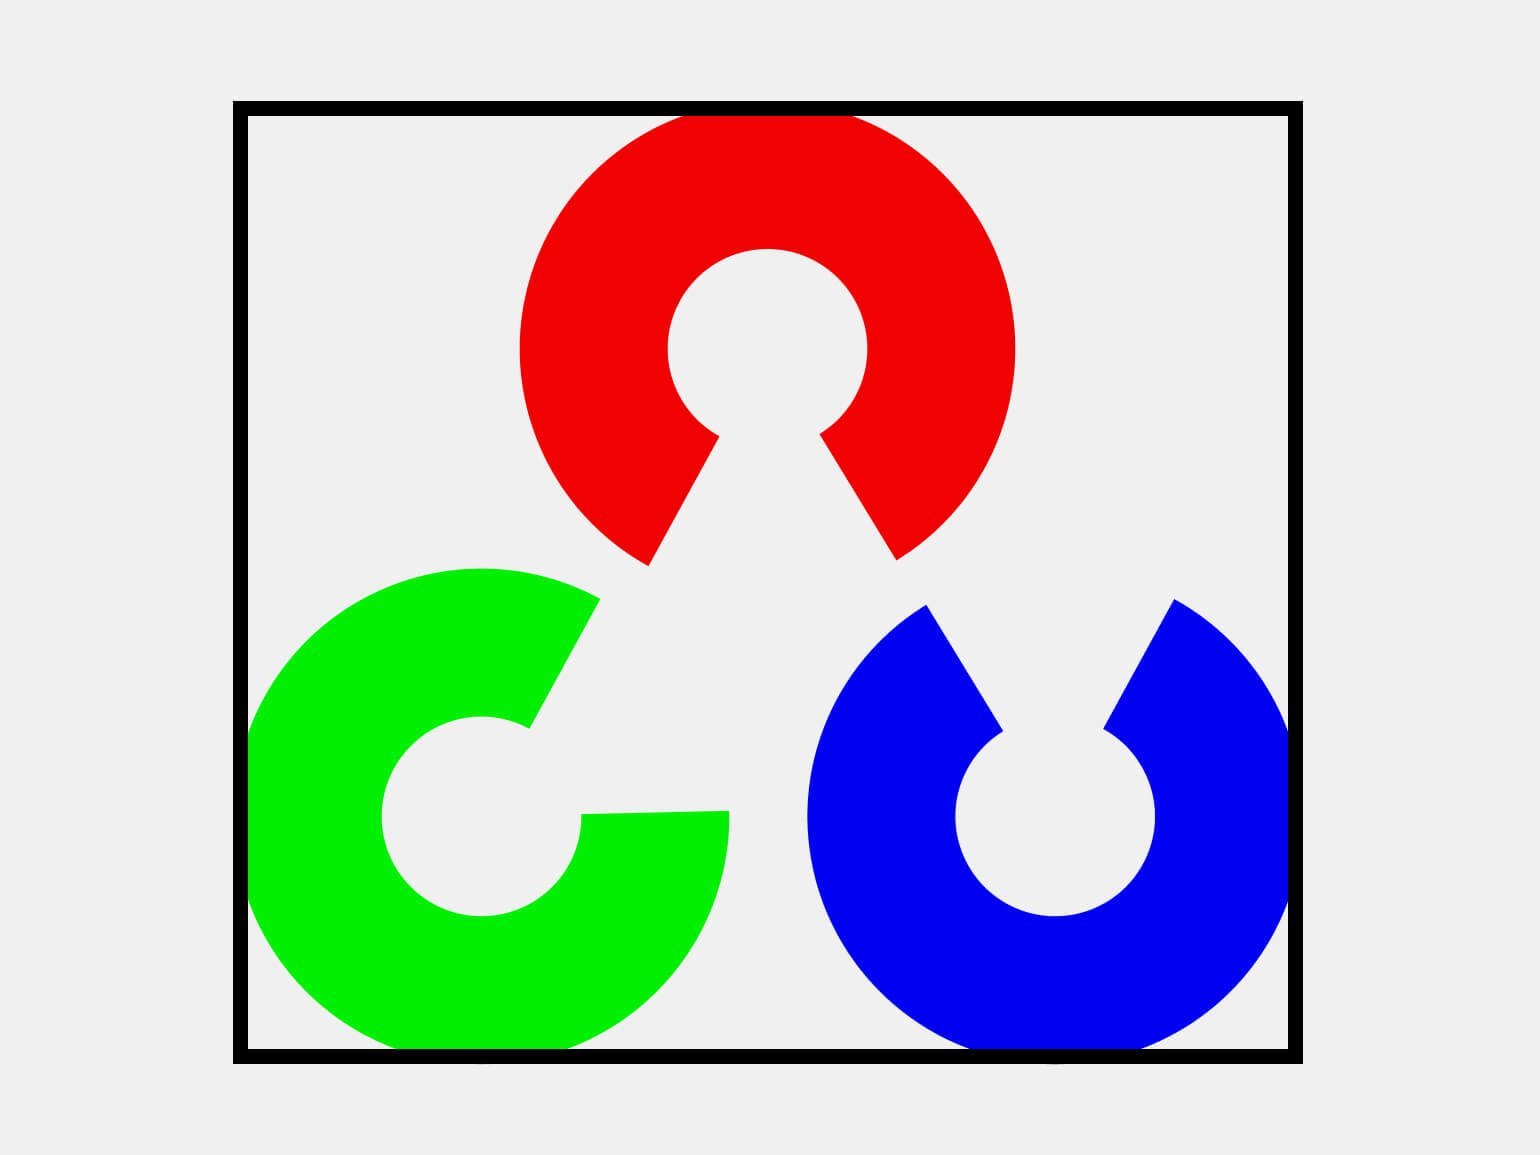
Используя циклы, можно изменять цвет сразу множества пикселей. Например, нарисовать для картинки чёрную рамку шириной 10 пикселей.
Внешние циклы перебирают каждый пиксель по горизонтали (первый) и вертикали (второй), а внутренние циклы идут от краёв к центру изображения и на каждом витке перекрашивают в чёрный по пикселю.
В итоге получается такое изображение:
Изменение размера изображения
Чтобы изменить размер изображения, используйте функцию cv2.resize. Уменьшим нашу картинку в два раза:
- image — NumPy-массив изображения, размер которого мы изменяем.
- (399, 368) — ширина и высота нового изображения.
- cv2.INTER_AREA — метод интерполяции, то есть алгоритм, по которому OpenVC выбирает, в какие цвета красить пиксели.
Есть несколько методов интерполяции , но в большинстве случаев достаточно двух из них:
- cv2.INTER_LINEAR — для увеличения изображения. Используется по умолчанию, если не указано иное.
- cv2.INTER_AREA — для уменьшения картинки.
Чтобы сохранять пропорции изображения и каждый раз не высчитывать их вручную, используйте данные, полученные с помощью метода shape:
В обоих случаях результат одинаковый:
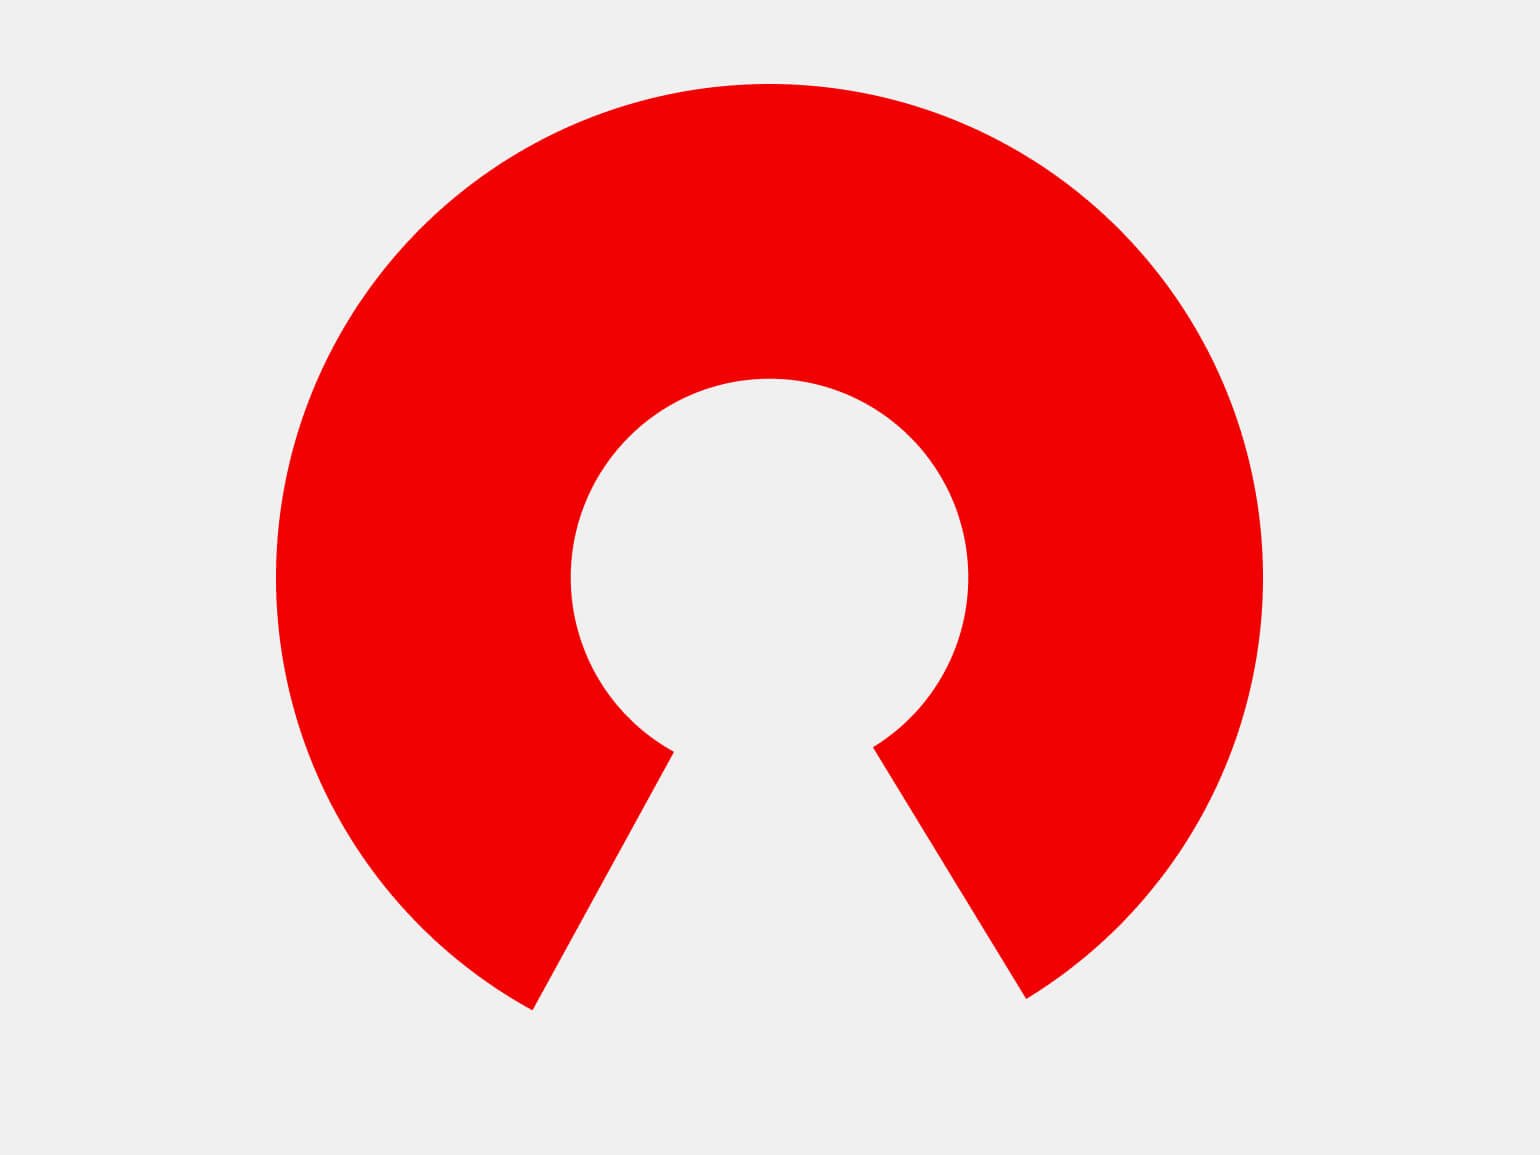
Обрезка
Чтобы обрезать изображение, укажите диапазоны координат, в которых хотите оставить изображение, — сначала высоту, потом ширину. Например:
Поворот
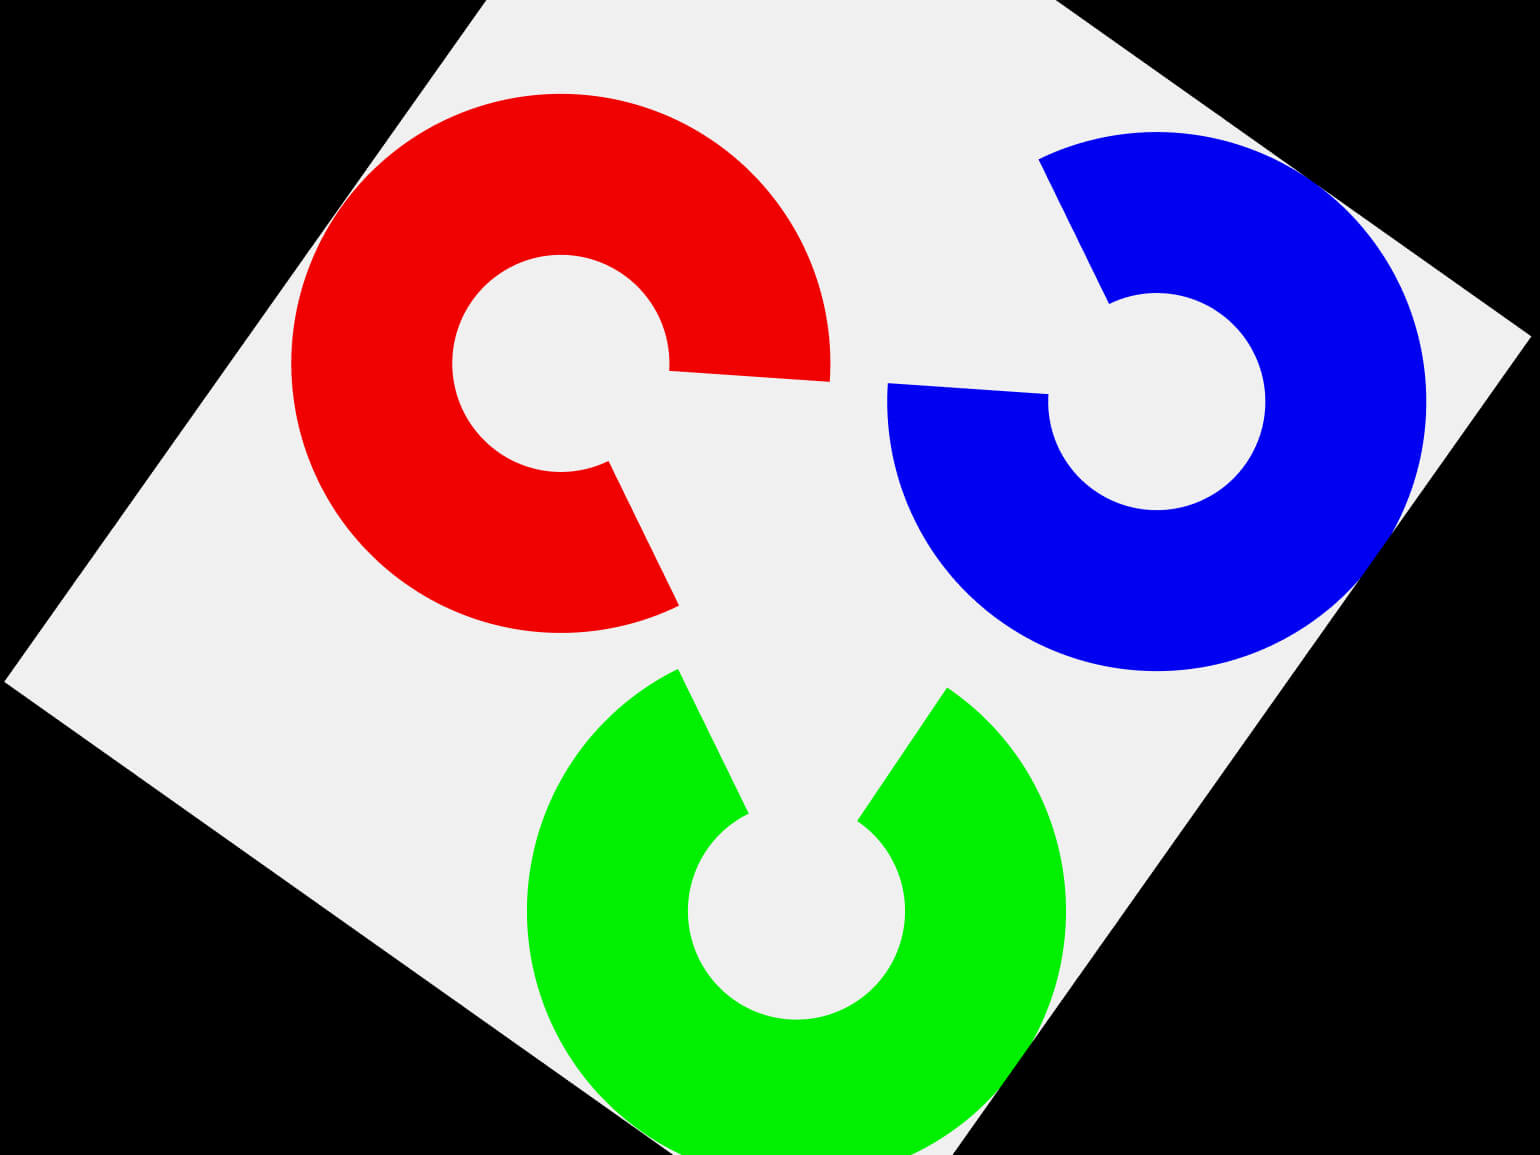
Чтобы повернуть картинку, используйте сразу две функции:
Функция cv2.getRotationMatrix2D задаёт матрицу, по которой будет повёрнуто изображение. Она получает следующие аргументы:
- (399, 368) — координаты точки, вокруг которой происходит поворот.
- 60 — угол поворота в градусах.
- 0.8 — коэффициент масштабирования. В нашем случае мы уменьшаем изображение, чтобы части логотипа не вышли за край.
Функция cv2.warpAffine непосредственно поворачивает изображение. Она получает следующие аргументы:
- image — само изображение.
- matrix — матрица, созданная функцией cv2.getRotationMatrix2D.
- (image.shape[1], image.shape[0]) — размеры итогового изображения. В нашем случае мы оставляем те же, что были.
Примеры скриптов OpenCV
Напишем пару простых скриптов для работы с изображениями, используя библиотеку OpenCV для Python.
Отображение координат точки
OpenCV умеет работать с нажатиями на открытое в окне изображение. Сделаем так, чтобы при нажатии на картинку программа выводила в терминал координаты точки и её цветовой код в формате BGR.
Дополнительно будем рисовать данные о точке, на которую нажали, прямо на изображении. Если нажали левую кнопку мыши — координаты, если правую — BGR-код.
Напишите функцию click_event, которая будет реагировать на нажатие на картинку:
Функция click_event принимает пять аргументов:
- event — произошедшее событие (в нашем случае нажатие кнопки мыши).
- x и y — координаты точки, на которую нажали.
- flags и params — служебные аргументы, нужные методу, с помощью которого мы будем вызывать эту функцию.
При нажатии любой кнопки мыши мы хотим выводить в терминал координаты и BGR-код точки. Пропишите это:
Дополните первое условие кодом, который будет рисовать координаты точки прямо на изображении, если нажата левая кнопка мыши:
Функция cv2.putText принимает следующие аргументы:
- img — изображение, на которое добавляется надпись.
- f’
, — надпись, которая добавляется на изображение.‘ - (x, y) — координаты точки, из которой выходит надпись.
- font — шрифт надписи.
- 1 — масштабирование размера текста.
- (0, 0, 0) — цвет текста.
- 2 — толщина линий.
По аналогии дополните второе условие кодом, который будет рисовать на изображении BGR-код, если нажата правая кнопка мыши:
Наша функция готова. Остаётся только передать изображение и воспользоваться встроенной OpenCV-функцией cv2.setMouseCallback:
Опробуйте код. Откройте изображение, нажмите правой кнопкой мыши на каждую из фигур и левой — на пространство между ними. Получится вот такой результат:
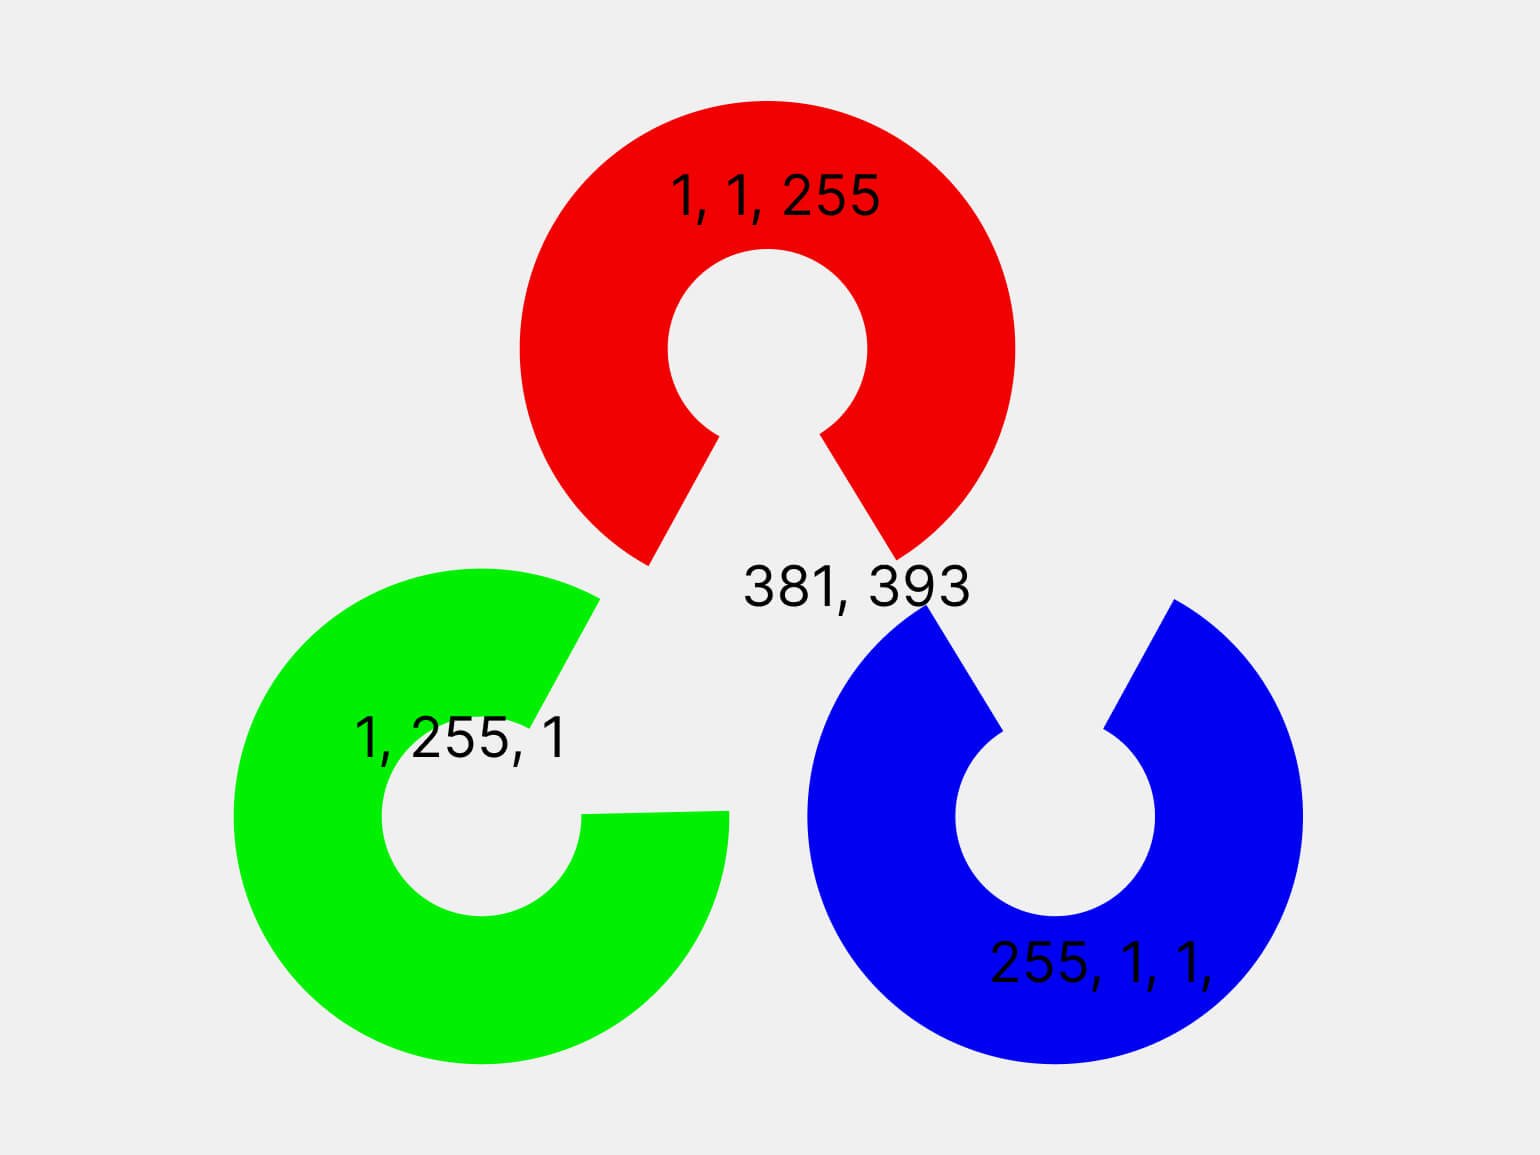
При этом в терминале выводится следующий текст:
Распознавание лиц
В OpenCV есть и более «умные» инструменты, использующие машинное обучение. Один из них — модель Haar, которая умеет распознавать лица.
Чтобы воспользоваться ей, скачайте файл haarcascade_frontalface_default.xml, выложенный OpenCV на GitHub.
Также вам понадобится любое изображение с лицами людей. Мы воспользуемся кадром из «Матрицы», который уже показывали в начале этой статьи.
Сохраните эти файлы в папку с вашим скриптом, и тогда к ним можно будет обращаться по имени.
Импортируйте OpenCV и создайте по переменной для модели Haar и изображения:
При работе с распознаванием и сравнением объектов используют обесцвеченные версии изображений. Обесцветим и наше:
Чтобы обнаружить на картинке лица, используйте метод detectMultiScale, который применим к модели Haar.
Мы передаём методу следующие аргументы:
- gray_image — обесцвеченное изображение;
- scaleFactor=1.1 — шаг масштабирования изображения. Дело в том, что в модели хранятся данные о лицах определённого размера. Если лица на изображении больше или меньше, то алгоритм не обнаружит их. Поэтому при анализе размер изображения меняется: чтобы лица на нём в какой-то момент стали того же размера, что и в модели. Чем меньше scaleFactor, тем точнее распознавание, но тем медленнее оно работает;
- minNeighbors=5 — какое минимальное число совпадений с моделью должно быть на изображении, чтобы признать объект лицом. Чем больше этот аргумент, тем меньше лиц алгоритм будет обнаруживать, но вместе с тем уменьшается шанс принять за лицо какой-либо другой объект.
Метод detectMultiScale возвращает координаты полученных объектов. Используйте эти координаты и функцию cv2.rectangle, чтобы нарисовать вокруг лиц квадраты:
В переменной faces хранится список из четырёх элементов. Каждый из них — список с данными всех найденных объектов:
- x — координаты верхнего левого угла объекта по горизонтали.
- y — координаты верхнего левого угла объекта по вертикали.
- w — ширина объекта.
- h — высота объекта.
Функция cv2.rectangle получает следующие аргументы:
- image — цветное изображение, на котором мы рисуем квадрат.
- (x, y) — координаты верхнего левого угла квадрата.
- (x+w, y+h) — координаты нижнего правого угла квадрата.
- (0, 0, 255) — цвет квадрата в формате BGR.
- 2 — толщина линии квадрата в пикселях.
Посмотрим на получившееся изображение:
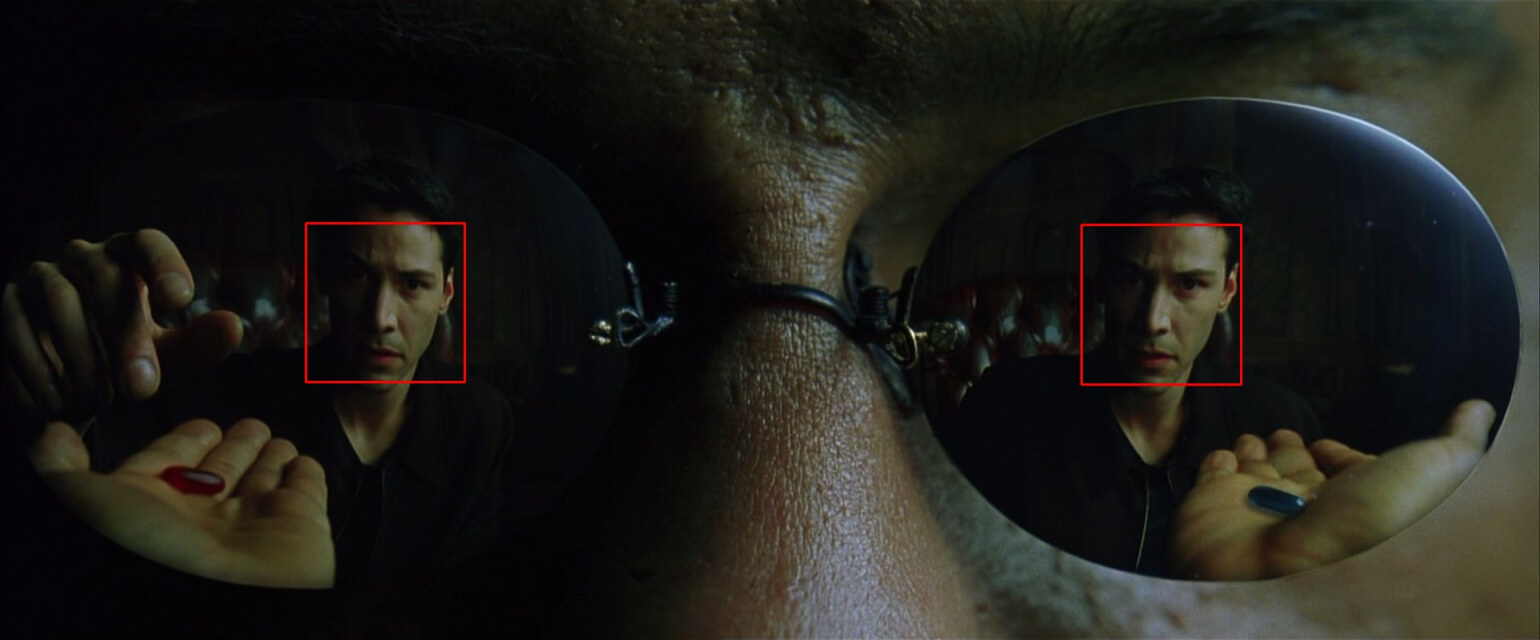
Всё получилось — лица в отражении обведены рамками.
Что дальше
Чтобы глубже погрузиться в тему компьютерного зрения и OpenCV, вы также можете изучить:
-
(английский); от платформы GeeksforGeeks (английский);
- Анирад Коул, Мехер Казам, Сиддха Ганджу. «Искусственный интеллект и компьютерное зрение»;
- Эдуард Шакирьянов. «Компьютерное зрение на Python»; (видео, есть английские субтитры).
Читайте также:
Больше интересного про код — в нашем телеграм-канале. Подписывайтесь!
Интерполяция — нахождение промежуточного значения между несколькими известными величинами.