AI в 2023 году: как развивается искусственный интеллект
Есть мнение, что мир стоит на пороге создания общего искусственного интеллекта (от англ. Artificial General Intelligence), способного мыслить и действовать как обычный человек. По данным агрегатора прогнозов Metaculus, эта технология может появиться уже в 2034 году.
Выпускник курса «Копирайтер» Нетологии Дмитрий Магонин разобрался, действительно ли мы близки к появлению сознательных машин, где проходит граница искусственного интеллекта и чего нам ждать от AI в 2023 году.
За помощь в подготовке материала благодарим Ивана Родина, постдок-исследователя университета Катании и эксперта Нетологии.
Дмитрий Магонин
Выпускник курса «Копирайтер» Нетологии
Что такое искусственный интеллект и какие компоненты его составляют
Искусственный интеллект — это способность компьютерных систем выполнять интеллектуальные и творческие функции, которые традиционно считаются человеческими.
Это определение, как и сам термин ИИ, было впервые озвучено в 1956 году на летнем семинаре в Дартмутском колледже, который организовали четверо американских учёных: Джон Маккарти, Марвин Ли Минский, Натаниэль Рочестер и Клод Шеннон. С тех пор понятие стало настолько популярным, что редко можно встретить человека, который о нём не слышал.
Сегодня технологии искусственного интеллекта используют в смартфонах, системах умных домов, медицине, образовании и промышленности. Однако эти разработки не могут в полной мере заменить человека: ИИ не обладает той же многозадачностью, в которой может работать человеческий мозг.
Чтобы понять, как устроен искусственный интеллект, рассмотрим элементы, которые необходимы для его создания ↓
Большие данные (от англ. Big Data) нужны для развития ИИ. Это база для глубокого обучения нейросетей.
Анализ больших данных (от англ. Data Mining) позволяет находить полезные и доступные решения в различных сферах человеческой деятельности. Мобильные устройства, облачные вычисления и интернет вещей расширяют экосистему больших данных, давая новые возможности для извлечения полезных знаний, выявления тенденций и настройки алгоритмов.
Искусственная нейронная сеть (ИНС) — система соединённых и взаимодействующих между собой простых блоков математических операций, моделирующих искусственные нейроны. В целом модель искусственной нейросети имитирует принципы сетей нервных клеток мозга живого организма. Такие системы не программируются в привычном смысле этого слова — они обучаются. Наибольшее применение нейронные сети нашли в программных приложениях, которые трудно выразить традиционным компьютерным алгоритмом, написанным на основе правил. Например, для работы с изображениями, видео, текстом и звуком.
Принцип работы нейросети можно рассмотреть на примере обучения простой модели, которая имеет архитектуру перцептрона.
Перцептрон — математическая или компьютерная модель восприятия информации мозгом.
Перед нами задача классификации изображений, когда нейросеть присваивает метки картинкам после идентификации изображённых на них объектов. Такие примеры решаются по принципу «обучение с учителем»: для тренировки модели нужно собрать полный набор размеченных изображений.
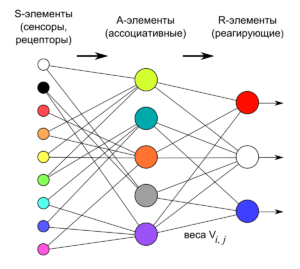
В процессе обучения с S-элементов нейросети на А-элементы из обучающего датасета поступает изображение объекта — например, кошки. Сигнал преобразуется и передаётся дальше на R-элементы нейросети — те, что, по сути, делают предсказание. Полученное предсказание сравнивается с разметкой эталона.
Все элементы перцептрона связаны между собой, и у каждой связи есть вес — число, отвечающее за то, каким образом сигнал будет преобразован. Если в процессе обучения предсказание нейросети будет отличаться от эталонной разметки, веса нейросети изменятся так, чтобы в следующий раз предсказание для этой картинки было корректным. Соответственно, во время обучения веса нейронов автоматически меняются и балансируются по особым алгоритмам. Впоследствии, если обучение прошло хорошо, полученную нейросеть с выученным набором весов можно будет использовать для классификации новых изображений, которые не вошли в обучающий датасет.
Этот пример — сильно упрощённая модель как искусственной нейронной сети, так и биологической нейросети человека или животного. Архитектуры и топологии современных глубинных ИНС гораздо сложнее и масштабнее. Они имеют множественные слои ассоциативных элементов, способных структурировать и ранжировать информацию. Эти сети создают многоуровневые композиции из примитивных данных, которые позволяют моделировать сложные, нелинейные отношения.
Комбинируя различные виды архитектур ИНС, инженеры создают многокомпонентные системы для различных задач. Быстрее всего развиваются такие области, как компьютерное зрение, распознавание речи и аудио, обработка естественного языка, биоинформатика, генерация изображений, текстов и машинного кода.
Методы машинного обучения помогают компьютеру учиться решать задачи на основе множества примеров. После обучения машина способна решать те же задачи на новых данных, которые не видела в процессе анализа.
Например, чтобы научить систему распознавать изображения, специалисты используют большой массив изображений — датасет, с описанием, или разметкой, представленных на них объектов: человек, кошка, автомобиль и так далее. После загрузки массива картинок, по мере анализа полученной информации, программа учится самостоятельно идентифицировать объекты. Связь между нейронами, которые привели к правильному ответу, усиливается, а к неправильному — ослабляется. После многократных итераций сеть создаёт правильные нейронные соединения — в этот момент можно сказать, что система научилась верно решать задачу.
Насколько искусственный интеллект приблизился к человеческому
Искусственный интеллект уже решает множество задач, на выполнение которых у людей ушли бы тысячи часов: обыгрывает шахматных гроссмейстеров, выявляет переломы на рентгеновских снимках, выбирает самый быстрый маршрут для грузовика доставки, проводит тестирование компьютерных программ с экрана. При этом у ИИ из-за отсутствия какой-либо субъектности нет понимания того, как он выполняет эти задачи.
Чтобы понять, на каком уровне сознания сейчас находится ИИ, нужно рассмотреть принцип работы интеллекта человека. Здесь можно выделить основные этапы:
Получение информации и первичная обработка данных.
Сортировка информации по блокам и обобщение.
Построение выводов и прогнозирование будущего.
Построение общей картины мира.
Субъектность, рефлексия, мотивировка принятия решений.
Если взять систему ИИ для беспилотных авто, каждый из этапов можно было бы охарактеризовать следующим образом:
Первичная обработка видео и лидар-сигналов (от англ. LiDAR — Light Detection and Ranging, «обнаружение и определение дальности с помощью света»), определение расстояния до ближайших объектов.
Выделение и распознание объектов: пешеходов, автомобилей, дорожных знаков.
Предсказание поведения других участников дорожного движения.
Моделирование нестандартных ситуаций: например, если у светофора горят все три секции, нужно понять, что тот неисправен, и принять все меры предосторожности на перекрёстке.
Осознание собственного я: «Зачем я еду из пункта А в пункт Б?», «Почему между вариантами „наехать на пешехода“ и „поцарапать машину о столб“ надо выбрать второе?»
Сегодня ИИ полностью освоил пункты 1 и 2 и частично реализовал пункт 3, усиленно развиваясь в этом направлении.
С пунктами 4 и 5 всё гораздо сложнее, поскольку их реализация выходит за границы бесхитростной логики машины. Здесь начинают играть такие понятия, как осознание своей личности и эго, бессознательное, эмоции, чувства. Та удивительная смесь индивидуальной биохимии, личного жизненного опыта и его интерпретации, которая делает нас теми, кем мы являемся — людьми в полном понимании этого слова.
Компьютерный интеллект, в отличие от человеческого мышления, не связан с эмоциями и особенностями личности. Да, системы на основе ИИ способны понимать и синтезировать речь, решать и действовать. Однако эти решения и действия не имеют никакой эмоциональной окраски — они основаны только на результатах обработки информации.
Можно с уверенностью сказать, что сегодня ИИ — это всего лишь множество интеллектуальных систем и их комбинаций, способных решать конкретные задачи: рисовать, водить автомобиль, проводить тестирование компьютерной программы или даже писать довольно крупные фрагменты кода. Однако о появлении общего искусственного интеллекта, обладающего разумом и самосознанием, пока говорить рано. Поэтому в противовес термину «общий ИИ» используется «слабый ИИ», чтобы обозначить технологию, которая пусть и может справляться с отдельными задачами лучше человека, но не обладает сознанием и не способна сравниться с интеллектом человека на широком спектре задач.
Технически современная наука может создать модель ИНС, которая по количеству нейронов будет сравнима с нейронной сетью кошки. Но мозг — это не просто массив отдельных нейронов, имеющих связь друг с другом. Это сложная динамическая система — её рабочие процессы до сих пор изучены далеко не полностью. Это же можно сказать и про сознание, многие принципы которого до сих пор неизвестны. Так что даже сознание кошки — цель для современного ИИ пока недостижимая. И выступает он сегодня только в качестве помощника, которые берёт на себя множество рутинных задач, требующих обработки больших массивов данных.
Одно из перспективных направлений в области развития ИИ — метод, согласно которому нейронная сеть самостоятельно исследует процесс создания искусственного интеллекта и вносит изменения в алгоритмы кода. Это позволяет ей не только изучать, но и улучшать свою топологию и архитектуру.
Один из ярких примеров этого способа — AutoML, проект компании Google, который использует автоматическое машинное обучение своих нейросетей. В процессе обучения ИНС сама подбирает алгоритмы, наиболее подходящие для выполнения той или иной задачи. Одновременно с этим алгоритмы-подборщики проходят обучение с людьми. Благодаря тому, что машина в единицу времени способна обработать огромные массивы информации и проанализировать миллионы различных вариантов написания кода, процесс обучения и развития ИИ идёт гораздо быстрее, чем если бы это делала группа программистов.
Учёные предполагают, что с учётом видимого роста производительности машин и совершенствования архитектуры нейронных сетей, систему, которая будет наиболее полно имитировать работу человеческого мозга, получится создать в 2030–2035 годах. Такой отдалённый прогноз имеет много условностей — погрешность в сроках довольно велика. Однако и ближайшее будущее ИИ несёт нам много интересных событий.
 Профессия
Data Scientist
с нуля до middle
Узнать больше
- Построите карьеру в анализе данных и обучении нейронных сетей
- Добавите более 14 проектов в портфолио
- Сможете искать работу в новой сфере уже через 8 месяцев обучения
В каких областях развивается искусственный интеллект в 2023 году
В 2023 году правительства и корпорации по всему миру планируют потратить более 500 млрд долларов на развитие искусственного интеллекта. Рассмотрим самые интересные области использования ИИ, на которые стоит обратить внимание.
Генеративный искусственный интеллект
Это направление удивляло нас весь 2022 год. Внезапно оно перевернуло все представления о возможностях ИИ в различных областях: от искусства и поэзии до публицистики и кодинга.
ChatGPT достиг миллиона пользователей всего за неделю. Для сравнения Facebook* потребовалось 10 месяцев, а Instagram* — 2,5 месяца, чтобы прийти к такому результату. По данным OpenAI, около 1,5 млн пользователей используют нейросеть DALL-E для создания 2 млн изображений в день. У Stable Diffusion более 10 млн пользователей, а у MidJourney — 2 млн.
* Facebook и Instagram принадлежат компании Meta, которая признана экстремистской организацией и запрещена в РФ.
Член открытой исследовательской группы Knives and Paintbrushes Майк Кук считает, что генеративный ИИ по-прежнему будет главной движущей силой перемен. Его привлекательность — в способности генерировать новый контент: картины, новости, стихи, фрагменты машинного кода. Нейросети могут генерировать текст, который выглядит и читается так, будто написан человеком.
Ожидается, что в 2023 году генеративный ИИ научится создавать email-рассылки, помогать в разработке маркетинговых концепций, слоганов и брендов, создавать чертежи, концепты промышленных моделей, рекламные материалы. Это позволит людям творить и не тратить годы на приобретение нужных навыков.
Голосовой и языковой искусственный интеллект
Эволюция этого направления ожидается в том числе за счёт больших языковых моделей (от англ. Large Language Models): GPT-3 и GPT-4 от OpenAI, LaMDA от Google и BLOOM от независимого сообщества, в которое входят более тысячи исследователей из 70 стран. Причём бóльший фокус в развитии получат открытые языковые модели, такие как BLOOM. Исследователи и разработчики охотно делятся подробностями о данных, на которых обучалась эта нейросеть, рассказывают о проблемах в её разработке и о том, как они оценивали производительность. OpenAI и Google не делились своим кодом и не делали свои модели общедоступными. Поэтому для сторонних исследователей они остаются неизвестными, поскольку никто не может вывести точные алгоритмы, по которым эти модели обучаются, кроме самих разработчиков.
Объяснимый искусственный интеллект
Это система искусственного интеллекта, действия которой люди могут с лёгкостью понять. Развитие объяснимого ИИ особенно важно в здравоохранении, поскольку большинство современных нейросетей не дают ясного объяснения, почему и каким образом они принимают те или иные решения. Нельзя быть уверенным, что диагностика пациентов будет верной, если алгоритм искусственного интеллекта не обучен надлежащим образом и нет понимания принципов, на основе которых он принимает решение.
Кроме того, для объяснимого ИИ требуется разработать инструменты и методики, позволяющие визуализировать процессы принятия решений ИИ. В медицине такие визуализации помогут врачам понять, как ИИ-системы пришли к своим рекомендациям.
Этика искусственного интеллекта
Роль этики искусственного интеллекта также станет более важным фактором. Искусственный интеллект постоянно тестируют в процессах, связанных с принятием решений. В таких действиях, как обработка резюме, постановка диагнозов, вынесение приговоров, практика показала, что ошибки в обучении нейросети могут приводить к неправильным выводам. За этим следует дискриминация и некорректное обращение с людьми. И это совсем неприемлемо в ситуациях, где ИИ играет роль судьи в вопросах трудоустройства, правосудия или здравоохранения.
Возникает острая необходимость в разработке надёжных этических основ ИИ.Приоритетными принципами должны стать:
- Стремление к справедливости. Крайне важно устранить предвзятость как в обучающих данных, так и в алгоритмах.
- Прозрачность — ещё один основополагающий аспект этики ИИ. Чтобы ИИ был этичным, он должен быть прозрачным. Пользователи и заинтересованные стороны должны иметь доступ к информации о том, как системы ИИ принимают решения. Такая прозрачность не только способствует подотчётности, но и позволяет людям при необходимости оспаривать и подвергать тщательной проверке решения, принимаемые ИИ.
- Подотчётность — при возникновении ошибок или несправедливых результатов в работе систем ИИ должны быть предусмотрены механизмы для выявления виновных и исправления ситуации. Эта ответственность распространяется не только на разработчиков; организации и учреждения, внедряющие системы ИИ, также должны нести ответственность за этические последствия применения ИИ.
Кибербезопасность на основе искусственного интеллекта
По прогнозам экспертов, в 2023 всё больше компаний будут увеличивать затраты на использование искусственного интеллекта в проектах по защите от киберугроз. Нейросети будут анализировать кибератаки, выявляя подозрительные тенденции и закономерности. Этот процесс обещает стать увлекательной и нескончаемой игрой в кошки-мышки, так как киберпреступники тоже будут использовать ИИ для противоправных действий.
Внедрение ИИ в кибербезопасность означает существенные изменения в способах борьбы организаций с киберугрозами. Традиционные меры безопасности часто не успевают за постоянно меняющейся тактикой киберпреступников. В отличие от них, системы на базе искусственного интеллекта демонстрируют впечатляющую способность адаптироваться и учиться на возникающих угрозах, обеспечивая проактивную защиту от потенциальных кибератак.
Виртуальные помощники
Распространение виртуальных помощников уже существенно повлияло на нашу повседневную жизнь. Эти компаньоны, работающие на основе искусственного интеллекта, произвели революцию во взаимодействии с техникой — от смартфонов до устройств типа умного дома.
Можно ожидать, что внедрение виртуальных ассистентов в различные производственные и бизнес-сферы приобретёт ещё больший масштаб. Также планируется активно развивать это направление на горячих линиях в области государственных услуг, муниципального управления, системы здравоохранения.
По данным Statista, в 2023 году прирост голосовых помощников к 2019 составит почти 60%. Предполагается, что боты смогут различать эмоции людей и подстраивать свои алгоритмы под настроение пользователя. Также, вероятнее всего, мы наконец сможем видеть ботов в формате голограммы или умного экрана.
Периферийный ИИ
Периферийный искусственный интеллект также окажется в трендах 2023 года, особенно в области интернета вещей. Это значит, что алгоритмы машинного обучения будут работать непосредственно на наших устройствах: пылесосах, зубных щётках, смартфонах, автомобилях.
Развитие периферийного ИИ позволит обрабатывать данные в течение нескольких миллисекунд, обеспечивая обратную связь в реальном времени. При этом не придётся расходовать время и трафик на пересылку информации в облако и обратно — так, как это было ранее. Конечно, обмен данными между аппаратными устройствами и материнской моделью ИИ необходим: головную модель нужно регулярно обучать с использованием обратной связи от конечных гаджетов. И глубокий анализ этой информации можно провести только в мощной нейросети. Но, по крайней мере, автономность этих устройств вырастет значительно, поскольку теперь речь идёт не о постоянном соединении и обмене данными, а о периодических сеансах связи, которые можно проводить при наличии качественного трафика.
ChatGPT и другие сервисы с нейросетями: смотрим, пробуем и читаем
Резюмируем
Искусственный интеллект — способность компьютерных систем имитировать деятельность человеческого мозга. Технологии на его основе всё глубже проникают в нашу жизнь: их применяют в образовательной, медицинской, промышленной, транспортной, бытовой и других сферах.
Для создания искусственного интеллекта необходимы большие данные, их качественная обработка, методы машинного обучения и ИНС.
Системы с ИИ могут решать конкретные задачи: генерировать изображения, водить автомобиль, тестировать компьютерные программы. Однако об искусственном интеллекте, обладающем разумом и самосознанием, говорить пока рано.
В 2023 году особенно быстрое развитие ожидается в сферах генеративного, голосового и языкового, объяснимого и периферийного ИИ. Также в трендах будет вопрос этики искусственного интеллекта и применение технологий на его основе в кибербезопасности.
Читать также
Продлить жизнь и побороть смерть — на что способен искусственный интеллект
Как искусственный интеллект помогает создавать аудиоконтент и экономить ресурсы: кейс Smart Reading и Speechki
Искусственный интеллект, машинное обучение и глубокое обучение: в чём различия
Мнение автора и редакции может не совпадать. Хотите написать колонку для Нетологии? Читайте наши условия публикации. Чтобы быть в курсе всех новостей и читать новые статьи, присоединяйтесь к Телеграм-каналу Нетологии.
К чему подготовить бизнес перед использованием AI и ML
Искусственный интеллект (AI) и машинное обучение (ML) важны, когда у компании много данных и нужно упростить работу с ними или больше зарабатывать с их помощью. Такой сценарий актуален, к примеру, для маркетинга, IT- и банковской сфер.
Ак Барс Банк, чтобы поделиться опытом в обработке клиентских сведений, организовал на Kazan Digital Week 2021 секцию «AI&ML для монетизации данных». Здесь обсудили, чем AI и ML полезны бизнесу, как их внедрить и какие сложности могут из-за них появиться.
AI (artificial intelligence) — это искусственный интеллект. То есть машина выполняет задачи, с которыми раньше мог справиться только человек. AI-системы способны запускать мыслительный процесс: рассуждают, ищут смысл, обобщают, учатся на своих ошибках и делают выводы.
Чуть более узкое понятие — ML (machine learning) — машинное обучение. Это один из методов искусственного интеллекта, и он как раз отвечает за передачу необходимых «знаний» AI-системе.
С помощью искусственного интеллекта компании:
- создают персонализированные предложения, изображения, видео, тексты;
- выстраивают общение с потенциальными и реальными клиентами (чат-боты — это тот же AI);
- подбирают персональные продукты и проценты от банков и банковских карт;
- показывают подходящие вакансии на Headhunter;
- разрабатывают мобильные приложения;
- распознают речь и создают голосовые помощники.
В обычной жизни люди сталкиваются с Al и ML, сами того не замечая. Например, вы на рабочем ноутбуке читали про новую модель iPhone, и уже по дороге домой в Instagram вам то и дело предлагают рекламные объявления в духе «новый iPhone в рассрочку».
Еще один пример. Вам нужно срочно заполнить сайт текстом, и вы обращаетесь в контент-агентство в надежде, что за вашу задачу быстро возьмутся. Свободных копирайтеров нет, зато агентство использует технологии искусственного интеллекта — и вы тут же получаете готовые тексты для сайта.
Сейчас AI и ML наиболее широко используют в шести направлениях:
- Аналитика, управление проектами и принятие решений.
- Обработка естественной речи.
- Персонализация маркетинга и обслуживания.
- Интернет вещей и цифровые двойники.
- Автономные устройства (например, роботы-пылесосы).
- AI-разработка (например, разработка бизнес-решений без привлечения консультантов).
Чтобы использовать искусственный интеллект и машинное обучение в компании, нужно собрать данные о клиентах. Весь этот объем информации называется Big Data — база данных, которые компании получают из внешних и внутренних источников: отчетов, данных службы поддержки и отдела продаж, систем аналитики и действий самих клиентов.
Самый простой пример — опросы в чат-ботах или по электронной почте. Клиент отвечает на вопросы, его ответы переносятся в базу, после чего можно подключить к работе AI и ML и создать для него персональное предложение.
Условно все компании можно разделить на 3 группы:
- We have nothing: не используют данные, потому что не понимают или не видят в этом смысла. Как правило, у них большой дефицит в специалистах, очень дорогие облачные или коробочные решения, сложный процесс внедрения новых технологий. Начать работу с данными здесь сложнее и дольше всего.
- We have data: только начинают использовать данные в работе, собирают аналитику, чтобы понимать, как работает их бизнес. У них, как и в первой группе, могут быть дорогие облачные или коробочные решения, постоянный дефицит кадров, устаревший набор технологий.
- Data-Driven Company: хорошо выстроили data-driven-процессы. Они уже умеют собирать и применять данные в бизнесе. Именно в таких компаниях новые технологии быстро приживаются и развиваются.
Условная классификация компаний по уровню работы с данными
На работу с данными перешли еще не все компании, потому что data-бизнес, включая AI и ML, очень молод, ему 10 лет. Он все еще развивается, и технологии быстро сменяют друг друга. Если компания хочет успевать за обновлениями, в штате нужен хотя бы один человек, который разбирается в данных, готов изучать новые AI-решения и внедрять их в бизнес. Но специалистов, разбирающихся в данных, на рынке не хватает.
Увы, дефицит специалистов — не единственная проблема. Есть другие препятствия для использования данных в бизнесе:
- Колоссальные ограничения с точки зрения информационной и юридической безопасности.
- Слабая нормативно-правовая база на территории РФ/СНГ.
- Применимые в России методы и подходы не подойдут для Европы и США из-за того, что у них свои регламенты и очень жесткие.
Если вышеперечисленные проблемы удастся миновать, и компания начинает работу с данными, появляются новые сложности на этапе внедрения данных в продукты:
- Рынок не знает, что хочет.
- Рынок не знает, что можно.
- В некоторых областях слишком высокая конкуренция.
- Разработка продуктов иногда нерентабельна.
- Компания не хочет или не может обогащать данные.
Все новые технологии, связанные с обработкой входящей информации вроде распознавания речи или чат-ботов, еще только развиваются и дорого стоят. Компания, которая хочет их внедрить, должна запастись временем и большим бюджетом.
Разработка новшества и его внедрение могут обойтись дороже старых бизнес-процессов. Например, решили уволить всех продавцов, разместить по всему периметру магазина камеры и установить кассы самообслуживания. При таком сценарии покупка, установка и обслуживание нового оборудования будут дороже оплаты труда реальных продавцов.
По статистике, 87% data-science-проектов остаются на пилотной стадии и никем не используются. Для реализации технологий в любом случае придется много экспериментировать и тратиться.
Получить AI-решение в некоторых случаях очень сложно, а в некоторых — невозможно вообще.
Пример 1. Водитель грузовика, работающий в компании, часто нарушает правила: курит в кабине, подвозит попутчиков. Его снимают камеры, но просматривать камеры некому — нет времени. Тогда разработали AI-решение с камерами, автоматически фиксирующими нарушения. Но коробка с этими камерами просто не влезла в грузовик .
Пример 2. В станок на заводе внедрили камеру, которая фотографирует готовые детали и при обнаружении брака уничтожает их. Со временем в партиях стали появляться бракованные детали, потому что светодиод в камере износился и перестал фиксировать дефекты.
В процессе AI-разработки и внедрения можно выделить 3 основных проблемы:
- AI-решения не универсальны.
- Требуются специализированные AI-решения.
- Для поддержки AI-решения необходимо переобучение или повышение квалификации специалистов.
Специалисты, которые принимают участие в создании AI-решения: Data Engineer, ML Engineer, Data Analyst
Можно выделить 3 работающих способа, чтобы получить хорошее AI-решение:
- Взять готовый AI-продукт.
- Создать свою AI-команду.
- Заказать AI-разработку.
Это уже существующий или разрабатывающийся продукт, который, вероятно, будут использовать несколько компаний.
- не надо долго ждать;
- от компании требуется только заключить договор и платить лицензионную плату.
- нет гарантии развития;
- лицензионная плата хоть и меньше стоимости разработки решения с нуля, но все-таки есть;
- возможно, продукт еще не разработан и все равно придется подождать;
- возможно, продукт не будет решать задачи компании.
Компания нанимает специалистов, которые разрабатывают AI-решение под особенности ее бизнеса.
- разработка точно решает задачи бизнеса;
- нет проблем с поддержкой функционирования AI-решения;
- продукт (без обслуживания) имеет доступную стоимость.
- неравномерная нагрузка: для создания продукта нужен целый штат специалистов, для поддержки — 1-2 человека;
- дефицит специалистов и их дороговизна.
Компания обращается к специалистам, которые разрабатывают AI-продукт, но не числятся в штате.
- AI-решение заточено под бизнес;
- равномерная нагрузка.
- сложно выбрать компанию/специалиста;
- разработчики могут указать высокую стоимость поддержки AI-решения, потому что никто, кроме него, не может этого сделать;
- решение может работать некоторое время, а затем — перестать работать, потому что специалист не следит постоянно за вашей компанией и вашими изменениями.
При разработке AI-решения важно, чтобы в компании были люди, которые разбираются в AI. Для этого можно либо обучить основам руководителей, либо найти посредника между AI-разработчиком и менеджментом. Обученные специалисты внутри компании сильно пригодятся, когда AI-решение будет готово: его предстоит не только внедрять, но и развивать.
Что такое искусственный интеллект?

Искусственный интеллект – раздел информатики, который занимается решением когнитивных задач, обычно отведенных человеку. К таким задачам относятся обучение, создание и распознавание образов. Современные организации собирают большие объемы данных из различных источников – интеллектуальных датчиков, инструментов мониторинга, системных журналов и контента, созданного человеком. Задача искусственного интеллекта заключается в создании самообучающихся систем, которые извлекают смысл из данных. Затем искусственный интеллект может применять эти знания для решения новых задач подобно человеку. Например, технология искусственного интеллекта может эффективно реагировать на человеческую речь, создавать оригинальные изображения и текст и принимать решения на основе данных, получаемых в реальном времени. Ваша организация может интегрировать возможности искусственного интеллекта в свои приложения, тем самым оптимизируя бизнес-процессы, улучшая качество обслуживания клиентов и ускоряя внедрение инноваций.
Как развивалась технология искусственного интеллекта?
В своей фундаментальной работе 1950 года «Вычислительные машины и разум» Алан Тьюринг рассматривал вероятность того, могут ли машины мыслить. В ней Тьюринг впервые ввел термин искусственный интеллект и представил его как теоретическую и философскую концепцию.
В период с 1957 по 1974 год достижения в области вычислительной техники обеспечили компьютерам возможность хранить больше данных и быстрее их обрабатывать. В течение этого времени ученые продолжали разрабатывать алгоритмы машинного обучения. Прогресс в этой области побудил такие агентства, как Управление перспективных исследовательских проектов Министерства обороны США (DARPA), создать фонд для исследований в области ИИ. Поначалу ученые пытались выяснить, могут ли компьютеры расшифровывать и переводить разговорную речь.
В 1980-е годы благодаря увеличению финансирования и расширению алгоритмического инструментария, используемого в области ИИ, удалось упростить развитие компьютеров. Дэвид Румельхарт и Джон Хопфилд опубликовали свои работы о методах глубокого обучения, в которых показали, что компьютеры могут обучаться на основе накопленного опыта.
В период с 1990 по начало 2000-х годов ученые достигли многих основных целей в сфере ИИ – например, победили действующего чемпиона мира по шахматам. Поскольку вычислительных данных и мощностей сегодня больше, чем в предыдущие десятилетия, исследования в области ИИ стали более распространенными и доступными. Он быстро превращается в общий искусственный интеллект, поэтому программное обеспечение может выполнять сложные задачи – самостоятельно разрабатывать и принимать решения, а также обучаться. Раньше это было по силам только человеку.
Преимущества искусственного интеллекта
Искусственный интеллект может предложить ряд преимуществ в различных отраслях.
Решение сложных проблем
Технология искусственного интеллекта может использовать машинное и глубокое обучение и решать сложные задачи подобно тому, как это делает человек. Искусственный интеллект может обрабатывать большие объемы данных, выявлять закономерности, идентифицировать информацию и давать ответы. Также с его помощью можно решать проблемы в различных областях, например, обнаруживать мошенничество, проводить медицинскую диагностику и бизнес-анализ.
Повышение эффективности бизнеса
В отличие от людей, искусственный интеллект может работать круглосуточно и без снижения производительности. Другими словами, он может выполнять ручные задачи без ошибок. Вы можете поручить ИИ выполнение повторяющихся утомительных задач, чтобы использовать человеческие ресурсы на других направлениях бизнеса, снизить рабочую нагрузку сотрудников и оптимизировать все задачи, связанные с организацией.
Более разумные решения
Искусственный интеллект может использовать машинное обучение, чтобы анализировать большие объемы данных быстрее, чем любой человек. Платформы искусственного интеллекта могут выявлять тенденции, анализировать данные и давать рекомендации, а благодаря прогнозированию данных ИИ помогает выбрать оптимальный вариант дальнейших действий.
Автоматизация бизнес-процессов
С помощью машинного обучения можно обучить искусственный интеллект точному и быстрому выполнению задач, чтобы повысить эффективность бизнеса за счет автоматизации тех его областей, с которыми сотрудникам тяжело или скучно работать. Кроме того, с помощью автоматизации ИИ можно освободить ресурсы сотрудников для выполнения более сложной и творческой работы.

Как искусственный интеллект можно использовать на практике?
Искусственный интеллект применяется в самых разных областях. Ниже приведен перечень примеров, подчеркивающих разнообразие вариантов использования ИИ. Этот список не является исчерпывающим.
Интеллектуальная обработка документов
Интеллектуальная обработка документов (IDP) преобразует неструктурированные форматы документов в полезные данные. Эта технология конвертирует деловые документы, например электронные письма, изображения и PDF-файлы, в структурированную информацию. IDP использует технологии искусственного интеллекта, такие как обработка естественного языка (NLP), глубокое обучение и машинное зрение, для извлечения, классификации и проверки данных.
Например, в Земельном кадастре Ее Величества (HMLR) обрабатываются права собственности на более чем 87 процентов земель Англии и Уэльса. Сотрудники HMLR сравнивают и изучают сложные юридические документы, связанные со сделками с недвижимостью. Организация внедрила приложение с искусственным интеллектом для автоматизации сравнения документов, что позволило сократить время проверки на 50 процентов и ускорить процесс утверждения передачи имущества. Подробнее см. в статье, как HMLR использует Amazon Textract.
Мониторинг производительности приложений (APM)
Мониторинг производительности приложений (APM) – это процесс использования программных инструментов и телеметрических данных для отслеживания производительности критически важных для бизнеса приложений. Инструменты APM на основе искусственного интеллекта используют исторические данные для прогнозирования проблем до того, как они возникнут. Кроме того, они могут помочь разработчикам эффективно решать проблемы в реальном времени. Эта стратегия обеспечивает эффективную работу приложений и устраняет сложности.
Например, компания Atlassian выпускает продукты для оптимизации командной работы и взаимодействия. Atlassian использует инструменты APM на основе ИИ для непрерывного мониторинга приложений, выявления потенциальных проблем и определения степени их серьезности. Благодаря этой функции команды могут быстро реагировать на рекомендации, разработанные с применением машинного обучения, и решать проблемы, связанные со снижением производительности.
Профилактическое обслуживание
Техническое обслуживание по текущему состоянию с помощью ИИ – это процесс использования больших объемов данных для выявления проблем, которые могут привести к простоям операций, систем или сервисов. Техническое обслуживание по текущему состоянию позволяет компаниям устранять потенциальные неполадки до их возникновения, что сокращает время простоев и предотвращает сбои.
Например, компания Baxter задействует 70 производственных площадок по всему миру и работает круглосуточно, обеспечивая поставки медицинского оборудования. Компания Baxter использует техническое обслуживание по текущему состоянию для автоматического выявления аномалий в промышленном оборудовании. Пользователи могут заблаговременно внедрять эффективные решения, чтобы сокращать период простоя оборудования и повышать его эффективность. Чтобы узнать больше, прочитайте, как компания Baxter использует Amazon Monitron.
Медицинские исследования
В медицинских исследованиях ИИ используется для оптимизации процессов, автоматизации повторяющихся задач и обработки огромных объемов данных. Технологии искусственного интеллекта можно использовать в медицинских исследованиях для того, чтобы упростить процесс разработки и создания фармацевтических препаратов, расшифровать медицинские записи и сократить время вывода новых продуктов на рынок.
В качестве примера можно назвать компанию C2i Genomics, которая использует искусственный интеллект для запуска высокомасштабных настраиваемых геномных конвейеров и клинических обследований. Благодаря тому, что вычислительные решения не требуются, исследователи могут сосредоточиться на разработке методов и клинической эффективности. Инженеры также используют ИИ для снижения потребности в ресурсах, сокращения затрат на инженерное обслуживание и невозмещаемых расходов (NRE). Подробнее см. в этой статье.
Бизнес-аналитика
В сфере бизнес-аналитики искусственный интеллект используется для сбора, обработки и анализа сложных наборов данных. Аналитику искусственного интеллекта можно использовать для прогнозирования будущих значений, анализа первопричин данных и сокращения трудоемких процессов.
Например, компания Foxconn использует бизнес-аналитику на основе ИИ для повышения точности прогнозирования. Они добились повышения точности прогнозирования на 8 %, что позволило сэкономить 533 000 USD в год. Компания также использует бизнес-аналитику для сокращения затрат на оплату труда и повышения уровня обслуживания клиентов за счет принятия решений на основе данных.
Каковы основные технологии искусственного интеллекта?
Нейронные сети глубокого обучения – основа технологий искусственного интеллекта. Они повторяют процессы, происходящие в человеческом мозге. В мозге содержатся миллионы нейронов, которые обрабатывают и анализируют информацию. Нейронные сети глубокого обучения состоят из искусственных нейронов, которые обрабатывают информацию. Каждый искусственный нейрон или узел использует математические расчеты для обработки информации и решения сложных задач. Подход глубокого обучения позволяет решать проблемы или автоматизировать задачи, которые обычно требуют человеческого интеллекта.

Вы можете разрабатывать различные технологии искусственного интеллекта, по-разному обучая нейронные сети глубокого обучения. Далее представлены некоторые ключевые технологии на основе нейронных сетей.
Обработка естественного языка
При обработке естественного языка (NLP) используются алгоритмы глубокого обучения для интерпретации, понимания и извлечения смысла из текстовых данных. Технология NLP позволяет обрабатывать тексты, созданные человеком. Она полезна для формирования сводок документов, автоматизации чат-ботов и анализа тональности текстов.
Машинное зрение
Машинное зрение использует методы глубокого обучения для извлечения информации и аналитических данных из видео и изображений. С помощью машинного зрения компьютер может воспринимать изображения, как человек. С помощью машинного зрения можно фильтровать неприемлемый контент в сети, распознавать лица и классифицировать детали изображений. В автомобилях и грузовиках с автопилотом оно необходимо для мониторинга окружающей обстановки и принятия решений за доли секунды.
Генеративный искусственный интеллект
Генеративный ИИ – это системы искусственного интеллекта, способные создавать новый контент и артефакты, такие как изображения, видео, текст и аудио, из простых подсказок. В отличие от прежнего ИИ, который ограничивался анализом данных, генеративный ИИ использует глубокое обучение и обрабатывает большие объемы информации для создания высококачественных творческих решений, похожих на человеческие. Несмотря на то, что технология позволяет создавать интересные творческие приложения, существуют опасения, связанные с предвзятостью, вредоносным контентом и интеллектуальной собственностью. В целом генеративный ИИ имеет более широкие возможности по созданию нового контента и артефактов в стиле, близком к человеческому.
Распознавание речи
Программное обеспечение для распознавания речи использует модели глубокого обучения для интерпретации человеческой речи, идентификации слов и определения смысла. Нейронные сети могут преобразовывать речь в текст и определять тональность голоса. Распознавание речи можно использовать при создании виртуальных помощников и программного обеспечения для колл-центров, чтобы облегчить выполнение поставленных задач и определять смысл сказанного.
Какие проблемы возникают при внедрении ИИ?
Существует ряд проблем, которые усложняют внедрение искусственного интеллекта. Ниже перечислены наиболее распространенные трудности, связанные с внедрением и использованием ИИ.
Управление данными
Политики управления данными должны соответствовать нормативным ограничениям и законам о конфиденциальности. Чтобы внедрить искусственный интеллект, необходимо управлять качеством, конфиденциальностью и безопасностью данных. Вы несете ответственность за данные клиентов и защиту их конфиденциальности. Чтобы управлять безопасностью данных, в вашей организации должны знать, как модели искусственного интеллекта используют эти данные и взаимодействуют с ними на каждом уровне.
Технические трудности
Машинное обучение ИИ требует огромных ресурсов, а для функционирования технологий глубокого обучения необходим высокий порог вычислительной мощности. Необходимо использовать надежную вычислительную инфраструктуру для запуска приложений ИИ и обучения моделей. Вычислительные мощности могут быть дорогостоящими, тем самым ограничивая масштабируемость систем ИИ.
Ограничения данных
Чтобы обучить системы искусственного интеллекта непредвзятому подходу, необходимо ввести огромные объемы данных. Вам потребуется достаточный объем памяти для хранения и обработки обучающих материалов. Кроме того, необходимо внедрить эффективное управление и контроль качества данных, чтобы обеспечить их точность в обучении.
Каковы основные компоненты приложений искусственного интеллекта?
Структура искусственного интеллекта состоит из четырех основных уровней. На каждом из этих уровней каждая отдельная технология выполняет свои задачи. Что же происходит на каждом из уровней?
Уровень 1. Данные
Искусственный интеллект основан на различных технологиях, таких как машинное обучение, обработка естественного языка и распознавание изображений. Центральное место в этих технологиях отводится данным, которые являются основным уровнем ИИ. На этом уровне основное внимание уделяется подготовке данных для приложений искусственного интеллекта. Современные алгоритмы, особенно алгоритмы глубокого обучения, требуют огромных вычислительных ресурсов. Итак, в этот уровень входят аппаратные средства, выполняющие роль подуровня и обеспечивающего необходимую инфраструктуру для обучения моделей ИИ. Вы можете получить доступ к этому уровню как к полностью управляемому сервису от стороннего поставщика облачных услуг.
Уровень 2. Платформы машинного обучения и алгоритмы
Инженеры и специалисты по исследованию данных создают платформы машинного обучения для решения конкретных бизнес-задач. Затем разработчики могут легко создавать и обучать модели, используя готовые функции и классы. Примеры таких платформ – TensorFlow, PyTorch и scikit-learn. Эти платформы являются жизненно важными компонентами архитектуры приложения и предлагают необходимые функции для простого создания и обучения моделей искусственного интеллекта.
Уровень 3. Модели
На уровне моделей разработчик приложения реализует модель искусственного интеллекта и обучает ее, используя данные и алгоритмы предыдущего уровня. От этого уровня зависят возможности искусственного интеллекта по принятию решений.
Ниже приведены некоторые из основных компонентов этого уровня.
Структура модели
Эта структура определяет мощность модели и включает уровни, нейроны и функции активации. В зависимости от проблемы и ресурсов можно выбрать нейронные сети прямого распространения, сверточные нейронные сети (CNN) или другие.
Параметры и функции модели
Для прогнозирования решающее значение имеют полученные в процессе обучения значения, например вес связи нейронов и узлы смещения нейронной сети. Функция потерь оценивает эффективность модели и предназначена для минимизации расхождений между прогнозируемым и реальным результатами.
Оптимизатор
Этот компонент регулирует параметры модели для уменьшения функции потерь. Различные оптимизаторы, такие как градиентный спуск и алгоритм адаптивного градиента (AdaGrad), служат разным целям.
Уровень 4. Прикладной уровень
Четвертый уровень – это прикладной уровень, который представляет собой часть архитектуры ИИ, ориентированную на клиента. Вы можете запрашивать у систем ИИ выполнение определенных задач, генерирование информации, предоставление сведений или принятие решений на основе данных. Благодаря прикладному уровню конечные пользователи могут взаимодействовать с системами искусственного интеллекта.
Как AWS может удовлетворить ваши требования к искусственному интеллекту?
Amazon Web Services (AWS) предоставляет самый полный набор сервисов, инструментов и ресурсов, отвечающих вашим требованиям к технологиям искусственного интеллекта. Благодаря AWS искусственный интеллект становится доступным для организаций любого масштаба и дает возможность разрабатывать инновационные технологии, не заботясь об инфраструктурных ресурсах.
Машинное обучение и искусственный интеллект AWS предлагают сотни сервисов для создания и масштабирования универсальных приложений искусственного интеллекта. Примеры сервисов, которые вы можете использовать, приведены ниже.
-
– обнаруживайте, отслеживайте и устраняйте уязвимости безопасности кода. – улучшайте модели обнаружения мошенничества в Интернете и боритесь с ним на высшем уровне. – выявляйте проблемы с инфраструктурой до их возникновения. – автоматизируйте, оптимизируйте и масштабируйте распознавание изображений и анализ видео. – извлекайте печатный текст и анализируйте рукописный, а также собирайте данные из любого документа. – преобразовывайте речь в текст, извлекайте ключевую бизнес-информацию из видеофайлов и улучшайте бизнес-результаты.
Начните использовать искусственный интеллект на AWS, создав аккаунт уже сегодня.
Al проект что это

While a number of definitions of artificial intelligence (AI) have surfaced over the last few decades, John McCarthy offers the following definition in this 2004 paper (link resides outside ibm.com), " It is the science and engineering of making intelligent machines, especially intelligent computer programs. It is related to the similar task of using computers to understand human intelligence, but AI does not have to confine itself to methods that are biologically observable."
However, decades before this definition, the birth of the artificial intelligence conversation was denoted by Alan Turing’s seminal work, "Computing Machinery and Intelligence"(link resides outside ibm.com), which was published in 1950. In this paper, Turing, often referred to as the "father of computer science", asks the following question, "Can machines think?" From there, he offers a test, now famously known as the "Turing Test", where a human interrogator would try to distinguish between a computer and human text response. While this test has undergone much scrutiny since its publish, it remains an important part of the history of AI as well as an ongoing concept within philosophy as it utilizes ideas around linguistics.
Stuart Russell and Peter Norvig then proceeded to publish, Artificial Intelligence: A Modern Approach (link resides outside ibm.com), becoming one of the leading textbooks in the study of AI. In it, they delve into four potential goals or definitions of AI, which differentiates computer systems on the basis of rationality and thinking vs. acting:
- Systems that think like humans
- Systems that act like humans
- Systems that think rationally
- Systems that act rationally
Alan Turing’s definition would have fallen under the category of “systems that act like humans.”
At its simplest form, artificial intelligence is a field, which combines computer science and robust datasets, to enable problem-solving. It also encompasses sub-fields of machine learning and deep learning, which are frequently mentioned in conjunction with artificial intelligence. These disciplines are comprised of AI algorithms which seek to create expert systems which make predictions or classifications based on input data.
Over the years, artificial intelligence has gone through many cycles of hype, but even to
skeptics, the release of OpenAI’s ChatGPT seems to mark a turning point. The last time generative AI loomed this large, the breakthroughs were in computer vision, but now the leap forward is in natural language processing. And it’s not just language: Generative models can also learn the grammar of software code, molecules, natural images, and a variety of other data types.
The applications for this technology are growing every day, and we’re just starting to
explore the possibilities. But as the hype around the use of AI in business takes off,
conversations around ethics become critically important. To read more on where IBM stands within the conversation around AI ethics, read more here.
Multiply the power of AI for your enterprise with IBM’s next-generation AI and data platform.