Storage
Prometheus includes a local on-disk time series database, but also optionally integrates with remote storage systems.
Local storage
Prometheus’s local time series database stores data in a custom, highly efficient format on local storage.
On-disk layout
Ingested samples are grouped into blocks of two hours. Each two-hour block consists of a directory containing a chunks subdirectory containing all the time series samples for that window of time, a metadata file, and an index file (which indexes metric names and labels to time series in the chunks directory). The samples in the chunks directory are grouped together into one or more segment files of up to 512MB each by default. When series are deleted via the API, deletion records are stored in separate tombstone files (instead of deleting the data immediately from the chunk segments).
The current block for incoming samples is kept in memory and is not fully persisted. It is secured against crashes by a write-ahead log (WAL) that can be replayed when the Prometheus server restarts. Write-ahead log files are stored in the wal directory in 128MB segments. These files contain raw data that has not yet been compacted; thus they are significantly larger than regular block files. Prometheus will retain a minimum of three write-ahead log files. High-traffic servers may retain more than three WAL files in order to keep at least two hours of raw data.
A Prometheus server’s data directory looks something like this:
Note that a limitation of local storage is that it is not clustered or replicated. Thus, it is not arbitrarily scalable or durable in the face of drive or node outages and should be managed like any other single node database. The use of RAID is suggested for storage availability, and snapshots are recommended for backups. With proper architecture, it is possible to retain years of data in local storage.
Alternatively, external storage may be used via the remote read/write APIs. Careful evaluation is required for these systems as they vary greatly in durability, performance, and efficiency.
For further details on file format, see TSDB format.
Compaction
The initial two-hour blocks are eventually compacted into longer blocks in the background.
Compaction will create larger blocks containing data spanning up to 10% of the retention time, or 31 days, whichever is smaller.
Operational aspects
Prometheus has several flags that configure local storage. The most important are:
- —storage.tsdb.path : Where Prometheus writes its database. Defaults to data/ .
- —storage.tsdb.retention.time : When to remove old data. Defaults to 15d . Overrides storage.tsdb.retention if this flag is set to anything other than default.
- —storage.tsdb.retention.size : The maximum number of bytes of storage blocks to retain. The oldest data will be removed first. Defaults to 0 or disabled. Units supported: B, KB, MB, GB, TB, PB, EB. Ex: «512MB». Based on powers-of-2, so 1KB is 1024B. Only the persistent blocks are deleted to honor this retention although WAL and m-mapped chunks are counted in the total size. So the minimum requirement for the disk is the peak space taken by the wal (the WAL and Checkpoint) and chunks_head (m-mapped Head chunks) directory combined (peaks every 2 hours).
- —storage.tsdb.retention : Deprecated in favor of storage.tsdb.retention.time .
- —storage.tsdb.wal-compression : Enables compression of the write-ahead log (WAL). Depending on your data, you can expect the WAL size to be halved with little extra cpu load. This flag was introduced in 2.11.0 and enabled by default in 2.20.0. Note that once enabled, downgrading Prometheus to a version below 2.11.0 will require deleting the WAL.
Prometheus stores an average of only 1-2 bytes per sample. Thus, to plan the capacity of a Prometheus server, you can use the rough formula:
To lower the rate of ingested samples, you can either reduce the number of time series you scrape (fewer targets or fewer series per target), or you can increase the scrape interval. However, reducing the number of series is likely more effective, due to compression of samples within a series.
If your local storage becomes corrupted for whatever reason, the best strategy to address the problem is to shut down Prometheus then remove the entire storage directory. You can also try removing individual block directories, or the WAL directory to resolve the problem. Note that this means losing approximately two hours data per block directory. Again, Prometheus’s local storage is not intended to be durable long-term storage; external solutions offer extended retention and data durability.
If both time and size retention policies are specified, whichever triggers first will be used.
Expired block cleanup happens in the background. It may take up to two hours to remove expired blocks. Blocks must be fully expired before they are removed.
Remote storage integrations
Prometheus’s local storage is limited to a single node’s scalability and durability. Instead of trying to solve clustered storage in Prometheus itself, Prometheus offers a set of interfaces that allow integrating with remote storage systems.
Overview
Prometheus integrates with remote storage systems in three ways:
- Prometheus can write samples that it ingests to a remote URL in a standardized format.
- Prometheus can receive samples from other Prometheus servers in a standardized format.
- Prometheus can read (back) sample data from a remote URL in a standardized format.
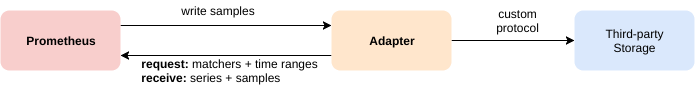
The read and write protocols both use a snappy-compressed protocol buffer encoding over HTTP. The protocols are not considered as stable APIs yet and may change to use gRPC over HTTP/2 in the future, when all hops between Prometheus and the remote storage can safely be assumed to support HTTP/2.
For details on configuring remote storage integrations in Prometheus, see the remote write and remote read sections of the Prometheus configuration documentation.
The built-in remote write receiver can be enabled by setting the —web.enable-remote-write-receiver command line flag. When enabled, the remote write receiver endpoint is /api/v1/write .
For details on the request and response messages, see the remote storage protocol buffer definitions.
Note that on the read path, Prometheus only fetches raw series data for a set of label selectors and time ranges from the remote end. All PromQL evaluation on the raw data still happens in Prometheus itself. This means that remote read queries have some scalability limit, since all necessary data needs to be loaded into the querying Prometheus server first and then processed there. However, supporting fully distributed evaluation of PromQL was deemed infeasible for the time being.
Existing integrations
To learn more about existing integrations with remote storage systems, see the Integrations documentation.
Backfilling from OpenMetrics format
Overview
If a user wants to create blocks into the TSDB from data that is in OpenMetrics format, they can do so using backfilling. However, they should be careful and note that it is not safe to backfill data from the last 3 hours (the current head block) as this time range may overlap with the current head block Prometheus is still mutating. Backfilling will create new TSDB blocks, each containing two hours of metrics data. This limits the memory requirements of block creation. Compacting the two hour blocks into larger blocks is later done by the Prometheus server itself.
A typical use case is to migrate metrics data from a different monitoring system or time-series database to Prometheus. To do so, the user must first convert the source data into OpenMetrics format, which is the input format for the backfilling as described below.
Usage
Backfilling can be used via the Promtool command line. Promtool will write the blocks to a directory. By default this output directory is ./data/, you can change it by using the name of the desired output directory as an optional argument in the sub-command.
After the creation of the blocks, move it to the data directory of Prometheus. If there is an overlap with the existing blocks in Prometheus, the flag —storage.tsdb.allow-overlapping-blocks needs to be set for Prometheus versions v2.38 and below. Note that any backfilled data is subject to the retention configured for your Prometheus server (by time or size).
Longer Block Durations
By default, the promtool will use the default block duration (2h) for the blocks; this behavior is the most generally applicable and correct. However, when backfilling data over a long range of times, it may be advantageous to use a larger value for the block duration to backfill faster and prevent additional compactions by TSDB later.
The —max-block-duration flag allows the user to configure a maximum duration of blocks. The backfilling tool will pick a suitable block duration no larger than this.
While larger blocks may improve the performance of backfilling large datasets, drawbacks exist as well. Time-based retention policies must keep the entire block around if even one sample of the (potentially large) block is still within the retention policy. Conversely, size-based retention policies will remove the entire block even if the TSDB only goes over the size limit in a minor way.
Therefore, backfilling with few blocks, thereby choosing a larger block duration, must be done with care and is not recommended for any production instances.
Backfilling for Recording Rules
Overview
When a new recording rule is created, there is no historical data for it. Recording rule data only exists from the creation time on. promtool makes it possible to create historical recording rule data.
Usage
To see all options, use: $ promtool tsdb create-blocks-from rules —help .
The recording rule files provided should be a normal Prometheus rules file.
Prometheus storage
Prometheus by default stores data in local storage tsdb. But remote storage can be configured.
Let’s explain the most commonly used technical terms in Prometheus.
High Cardinality
The number of unique time series stored in the TSDB is called cardinality. “High cardinality” means high number of series. Prometheus tsdb storage is optimized for working with relatively low number of time series.
High cardinality for Prometheus starts from a few millions of time series.
Prometheus exposes the information about high cardinality time series at /status
Active time series
A time series is considered active if Prometheus scraped new data for it recently.Prometheus holds recently added samples for active time series in RAM, so its RAM usage highly depends on the number of active time series.
Churn rate
Active time series becomes inactive if it stops receiving new samples. New time series can substitute old time series on label value change.
The rate at which old time series are substituted by new time series is called churn rate. Obviously, high churn rate increases the cardinality. This may lead to performance degradation, high RAM usage and out of memory errors aka OOM.
Ingestion rate
The ingestion rate is per-second number of data points put into the tsdb storage.
Scrape interval
Prometheus scrapes targets with the configured interval, which is named scrape interval. By default it equals to 1 minute for all the scrape targets. It can be overridden via global->scrape_interval option in Prometheus config.
Lower scrape interval results in higher ingestion rate and in higher RAM usage for Prometheus, since more data points must be kept in RAM before they are flushed to disk.
Retention
Prometheus provides —storage.tsdb.retention.time command-line flag for configuring the lifetime for the stored data — see these docs for more info. The data outside the retention is automatically deleted. By default the retention is configured to 15 days. The amounts of data stored on disk depends on retention — higher retention means more data on disk.
The lowest supported retention in Prometheus is 2 hours (2h). Such a retention could be useful when configuring remote storage for Prometheus. In this case Prometheus simultaneously replicates all the scraped data into local storage and all the configured remote storage backends. This means that the retention for local storage can be minimal, since all the data is already replicated to remote storage and the remote storage can be used for querying from Grafana and any other clients with Prometheus querying API support.
Remote Storage
By default Prometheus stores data to local tsdb, but it can be configured to replicate the scraped data to remote storage backends. This can be useful in the following cases:
- Collecting data from many Prometheus instances to a single remote storage, so all the data could be queried and analyzed. This is sometimes called global query view .
- Storing long-term data into remote storage, so local tsdb in Prometheus could be configured with low retention in order to occupy low amounts of disk space.
- Overcoming scalability issues for Prometheus, which cannot automatically scale to multiple nodes.
Certain remote storage solutions such as VictoriaMetrics can scale both vertically (i.e. on a single computer) and horizontally (i.e. clustering over multiple computers).
And Thanos is a solution that solves this problem: it is an open-source, highly available Prometheus setup with long-term storage capabilities, focusing on long-term storage.
Долгосрочное хранение метрик Prometheus (Алексей Палажченко, Percona)
За короткое время Prometheus стал одним из самых популярных средств для мониторинга. Благодаря, в том числе, и высокой скорости своей работы. Его локальное хранилище отлично подходит для краткосрочного хранения метрик и работы с ними. Иногда хочется хранить метрики распределённо месяцы и годы, автоматически разрежая старые данные, но не меняя интерфейса работы с ними.
Как раз об этом расшифровка доклада Алексей Палажченко на RootConf 2018. В докладе: Prometheus, Local Storage TSDB, Remote Storage Prometheus, PromQL, TSDB, Сlickhouse, PromHouse, немного InfluxDB.
Кому интересно, прошу под кат.
Друзья! Всем привет! Меня зовут Алексей Палажченко. Я работаю в компании Percona. Я хотел бы вам рассказать про долгосрочное хранение метрик в Prometheus.
Я работаю в компании Percona и делаю продукт, который называется percona monitoring and management. Это коробочное решение, которое наши клиенты ставят себе. PMM полностью open source. Он состоит из Prometheus, Grafana для рисования графиков, custom софта query analytics и нашей собственной обертки, которая позволяет вам делать некоторое управление. Например, вы можете добавить scrape target в Prometheus. Это новые источники, откуда он будет брать метрики без того, чтобы руками заходить в контейнер или виртуальную машину и править файл конфигурации.
Важно понимать, что это не SaaS. У нас нет production’а. Наш production находится у наших клиентов. На нем экспериментировать не очень хорошо. У нас есть ближайшая вещь, которую можно было бы назвать production — это https://pmmdemo.percona.com/. На момент доклада pmmdemo.percona.com пришлось выключить из-за GDPR.
Мы ставим PMM клиентам — коробочное решение: docker-контейнер или виртуальная машина. Им всем нравится Prometheus. Некоторые люди, которые первый раз смотрят на Prometheus, сталкиваются с pull моделью. Для новичков это неудобно. Вообще отдельный большой разговор. Можно спорить о pull или push методах. В среднем это примерно одно и то же.
Некоторые вещи в Prometheus очень крутые.
Prometheus query language — это действительно крутая вещь, которой нет аналога практически нигде.
Второе, что нравится, — это service discovery. Если у вас какая-то динамическая инфраструктура, kubernetes, то автоматически не нужно добавлять руками все target’ы для мониторинга. Если статическое — это тоже можно сделать довольно просто. Нужно использовать файл конфигурации.
Клиентам Prometheus нравится. Они хотят хранить метрики дольше и больше. Кто-то использует Prometheus только для оперативного мониторинга. Но кто-то хочет хранить метрики дольше, смотреть динамику, сравнивать с графиками год назад. При этом цель долгосрочного хранения метрик не является целью для проекта Prometheus. Изначально он создавался для того, чтобы хранить метрики недолго. SoundCloud хранит метрики буквально несколько дней. В Prometheus есть механизмы, которые позволяют это делать дольше, но они устроены немножко сбоку. Поэтому мы можем сделать решение для экосистемы Prometheus, не меняя само ядро системы. Мы на основе них можем сделать свое собственное решение в рамках этой же экосистемы.

Это не доклад про готовые решения. Это доклад про наш опыт, про нашу боль, про наши попытки. Если вы рассчитывали, что после этого доклада вы скачаете репозиторий или docker-контейнер, запустите и все заработает, то это не так. Но при этом это достаточно близко к тому, чтобы быть так. У нас есть наработки. Они все opensource. Вы можете взять попробовать. Они не готовы к production пока еще. Но с той информацией, которая есть в этом докладе, вы сможете понять почему так, что можно сделать лучше. Вы можете сделать свое решение, которое будет хорошо подходить вам.
Как метрики хранится в Prometheus? Есть local storage. Есть remote storage. Это фактически два разных мира. Они слабо пересекаются. Поэтому и доклад тоже разделен на 2 части.
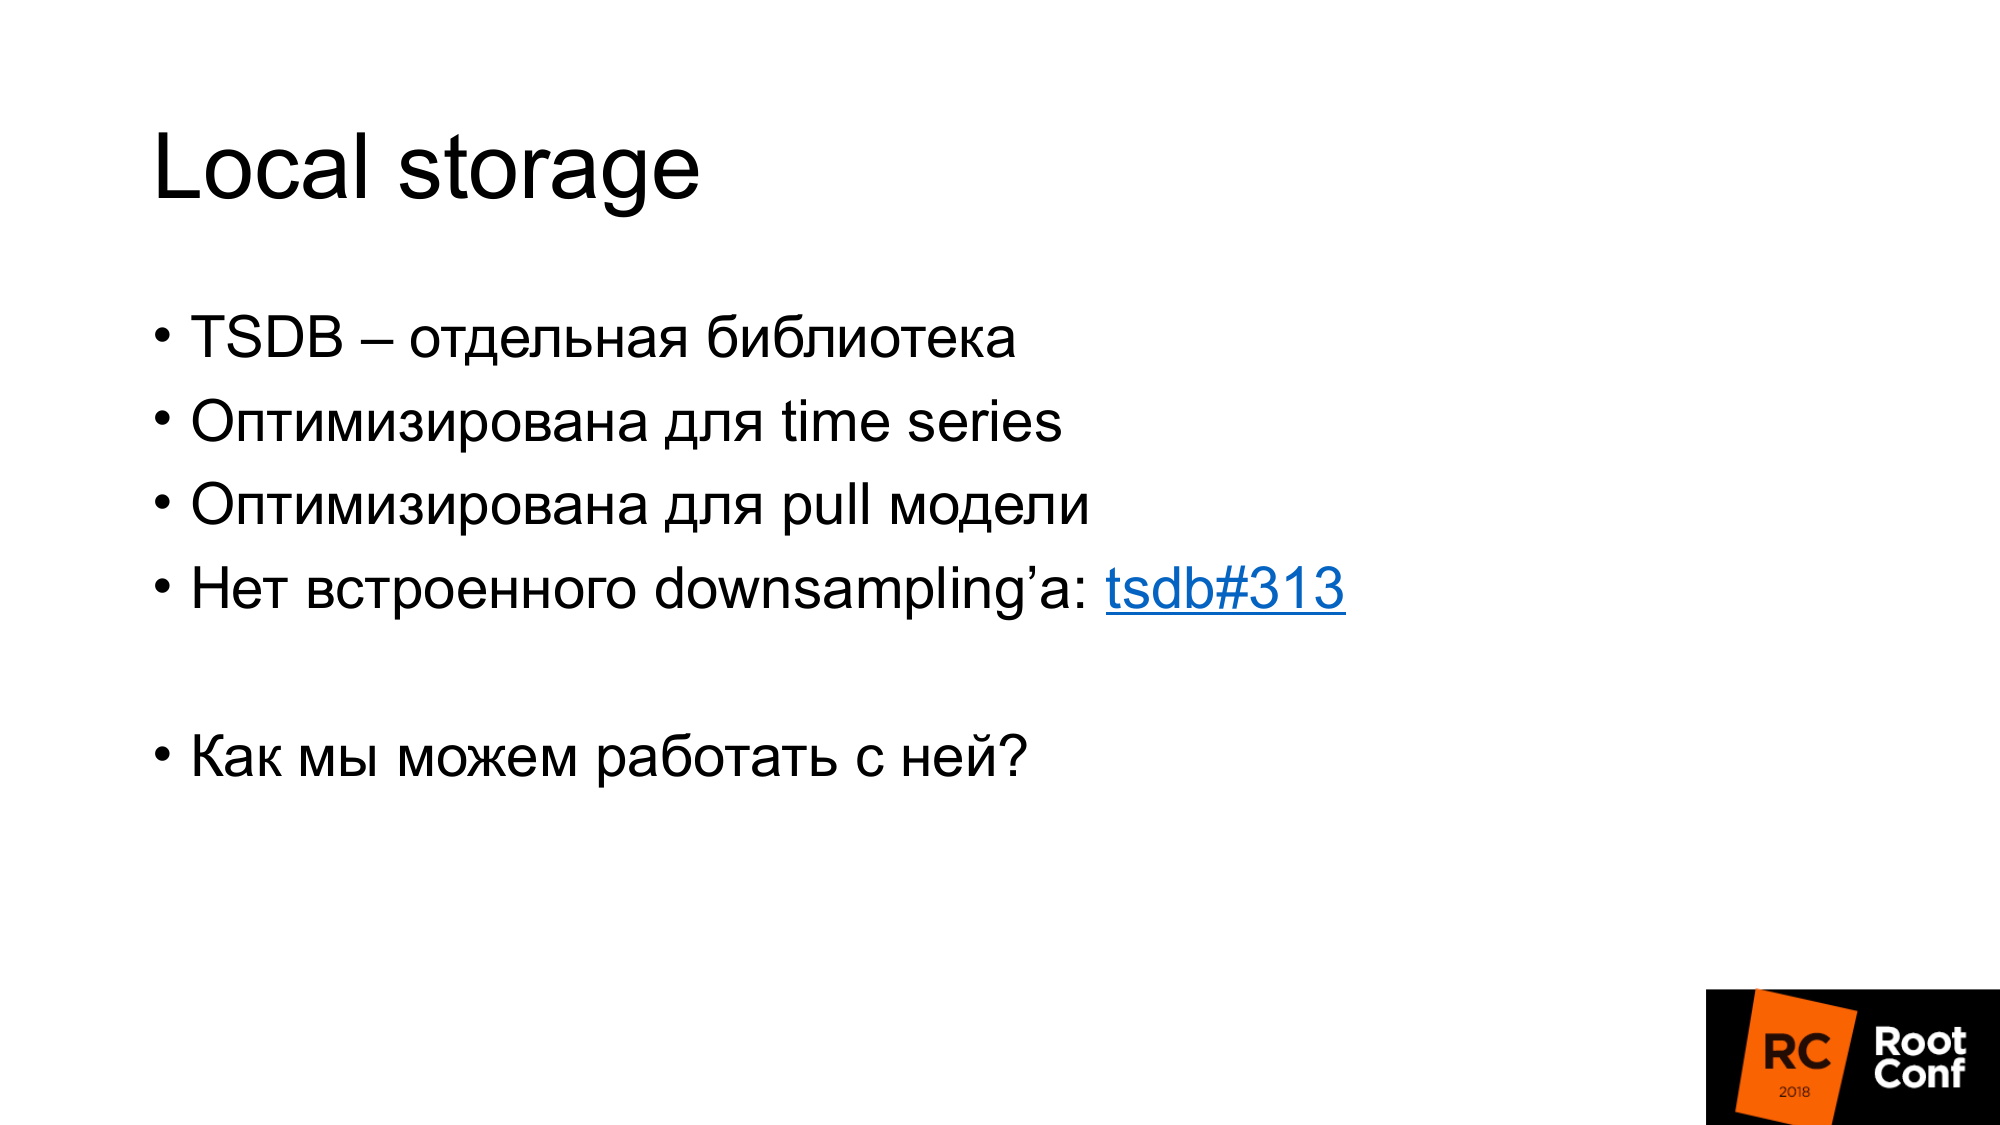
Если вы были на предыдущем докладе в главном зале, где как раз было хорошее интро в Prometheus, вы знаете что локальный storage — это отдельная библиотека, которая называется TSDB. TSDB не имеет ничего общего с OpenTSDB. TSDB — это отдельный Go пакет, который можно использовать из своей программы на Go. На уровне библиотеки TSDB нет никакого клиента и сервера.
Эта библиотека оптимизирована для работы именно с time series данными. Например, в TSDB есть delta encoding, который позволяет вам хранить не сами числа, а именно изменения между этими числами. Это позволяет вам вместо того чтобы хранить 16 байт — хранить 1 байт. 1 байт под время и 1 байт под значение. То есть вы храните в среднем 1 или 2 байта именно за счет этого хорошего сжатия.
TSDB оптимизирован для pull модели. Данные туда только добавляются. В Prometheus нельзя записать исторические данные. Для этого нет API. Максимальная дельта примерно 5 минут. Если данные более старые, они не будут приниматься.
В TSDB нет никакого встроенного downsampling tsdb#313. Есть открытый issue, в котором была дискуссия на тему того, что в целом есть проекты, которые вокруг Prometheus что-то делают и там есть downsampling. Пока что решение такое, что в TSDB не будут добавлять downsampling.
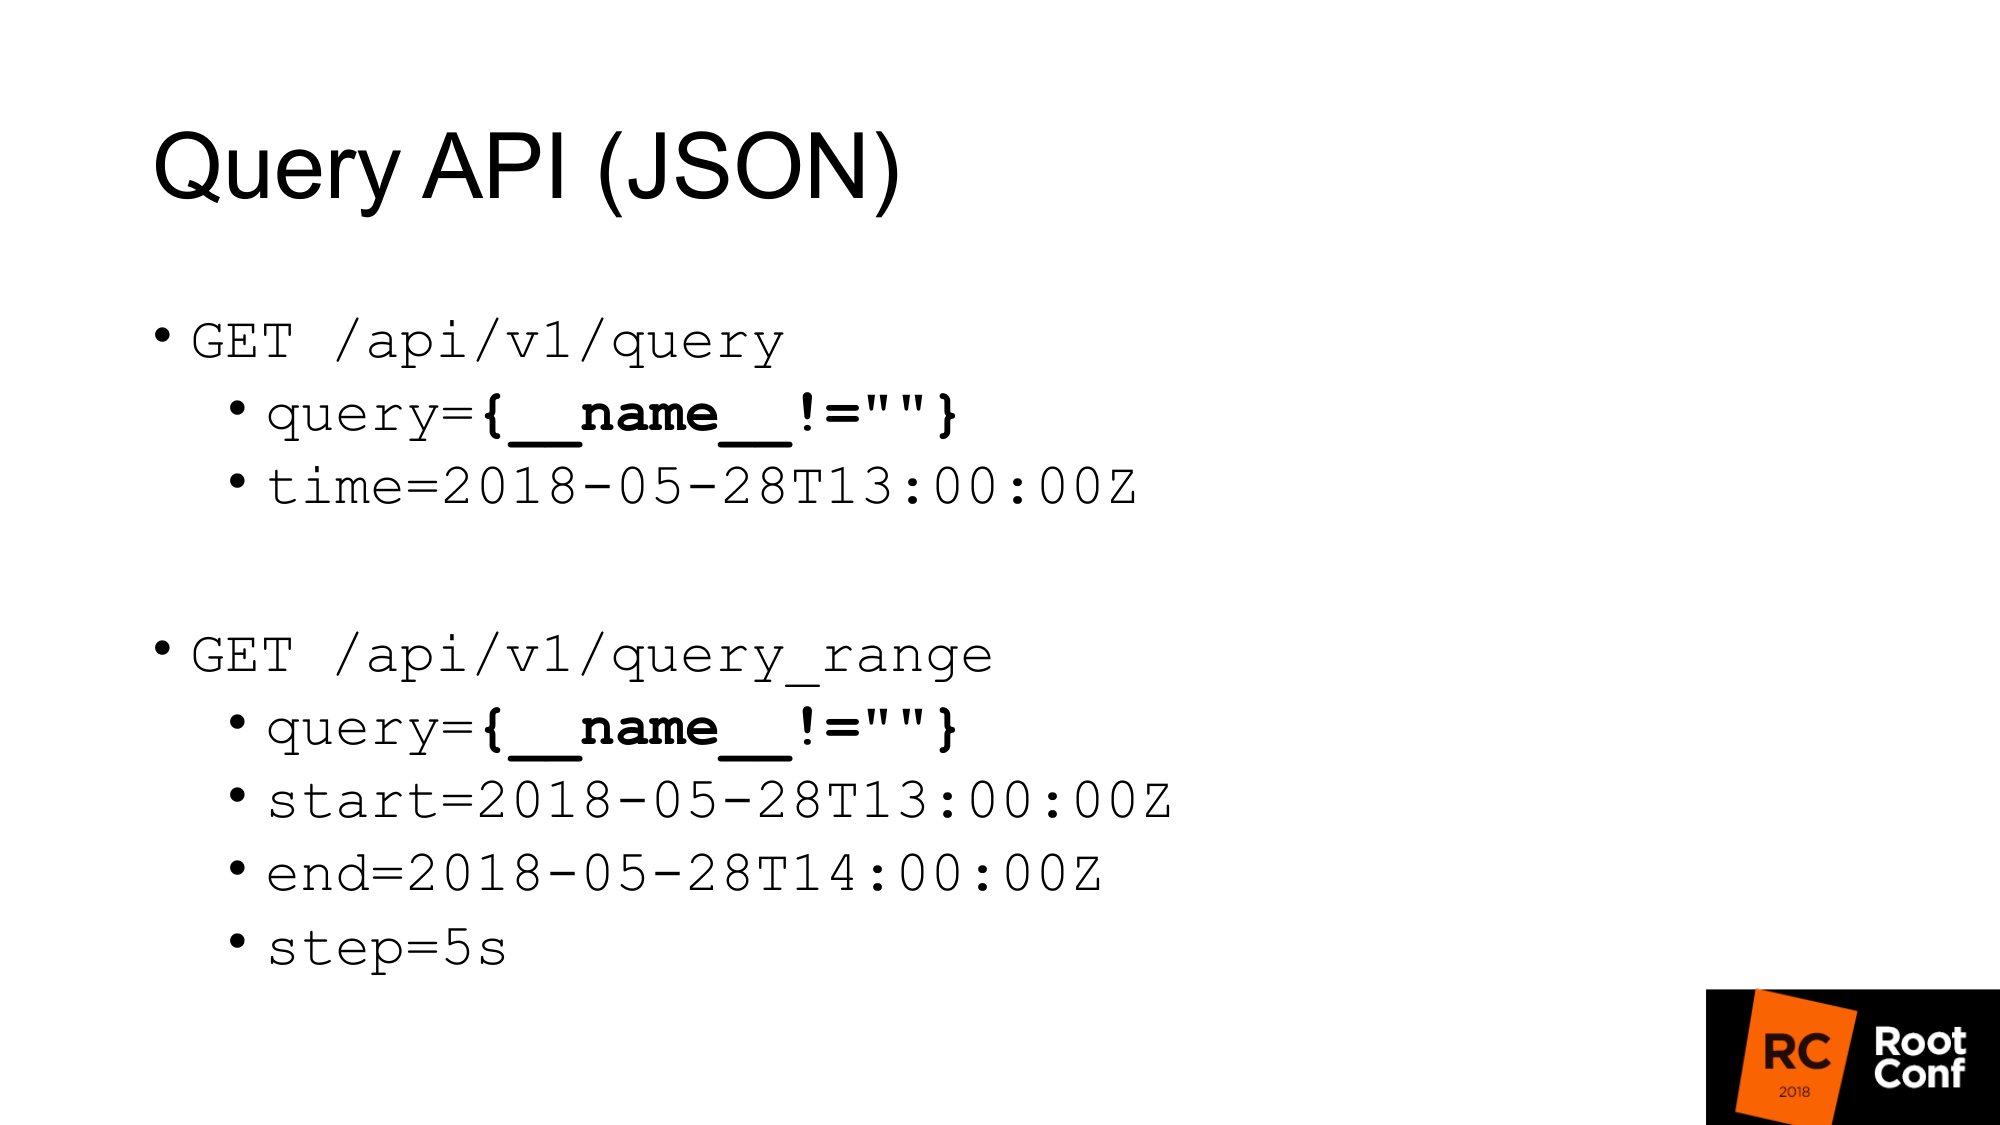
Как бы нам получить данные с TSDB? TSDB — это база данных на диске. Работать с ней можно, если вы пишете Go программу. Но если вы не пишите программу на Go, то есть JSON API, который позволяет вам сделать query запросы. Если вы хоть раз пользовались Prometheus и хоть раз строили какой-нибудь график, вы знаете стандартный Query API, в котором есть параметр query, в котором можно выполнить любой PromQL запрос и опционально время. Если время отсутствует, то берется текущее время.
На слайде выделено специфический query, который в реальной жизни вы редко увидите. Это хак. Это позволяет нам вытащить все метрики, которые есть в Prometheus. Как это работает? На уровне PromQL говорится что нельзя написать такое выражение, которое бы заматчило все time seriers. Это прямо в правилах написано. Еще одно правило говорит о том, что нельзя сделать такой matcher, в котором все значения пустые. Если вы напишете просто фигурные скобочки это не будет работать. Если вы напишите name не равно чему-нибудь (не пустое значение), то не будет работать. А вот это реальный хак, который позволяет это сделать. При этом он даже не особо документирован. В самом коде есть комментарии о том, что это работает.
Второй запрос — это query_range, который делает то же самое, но возращает вам данные в диапазоне и с неким шагом. Он по сути делает query несколько раз для каждой step начиная с начала и до конца. Это тот API, который используется для того чтобы рисовать графики. Первый API использует для получения моментальных значений.
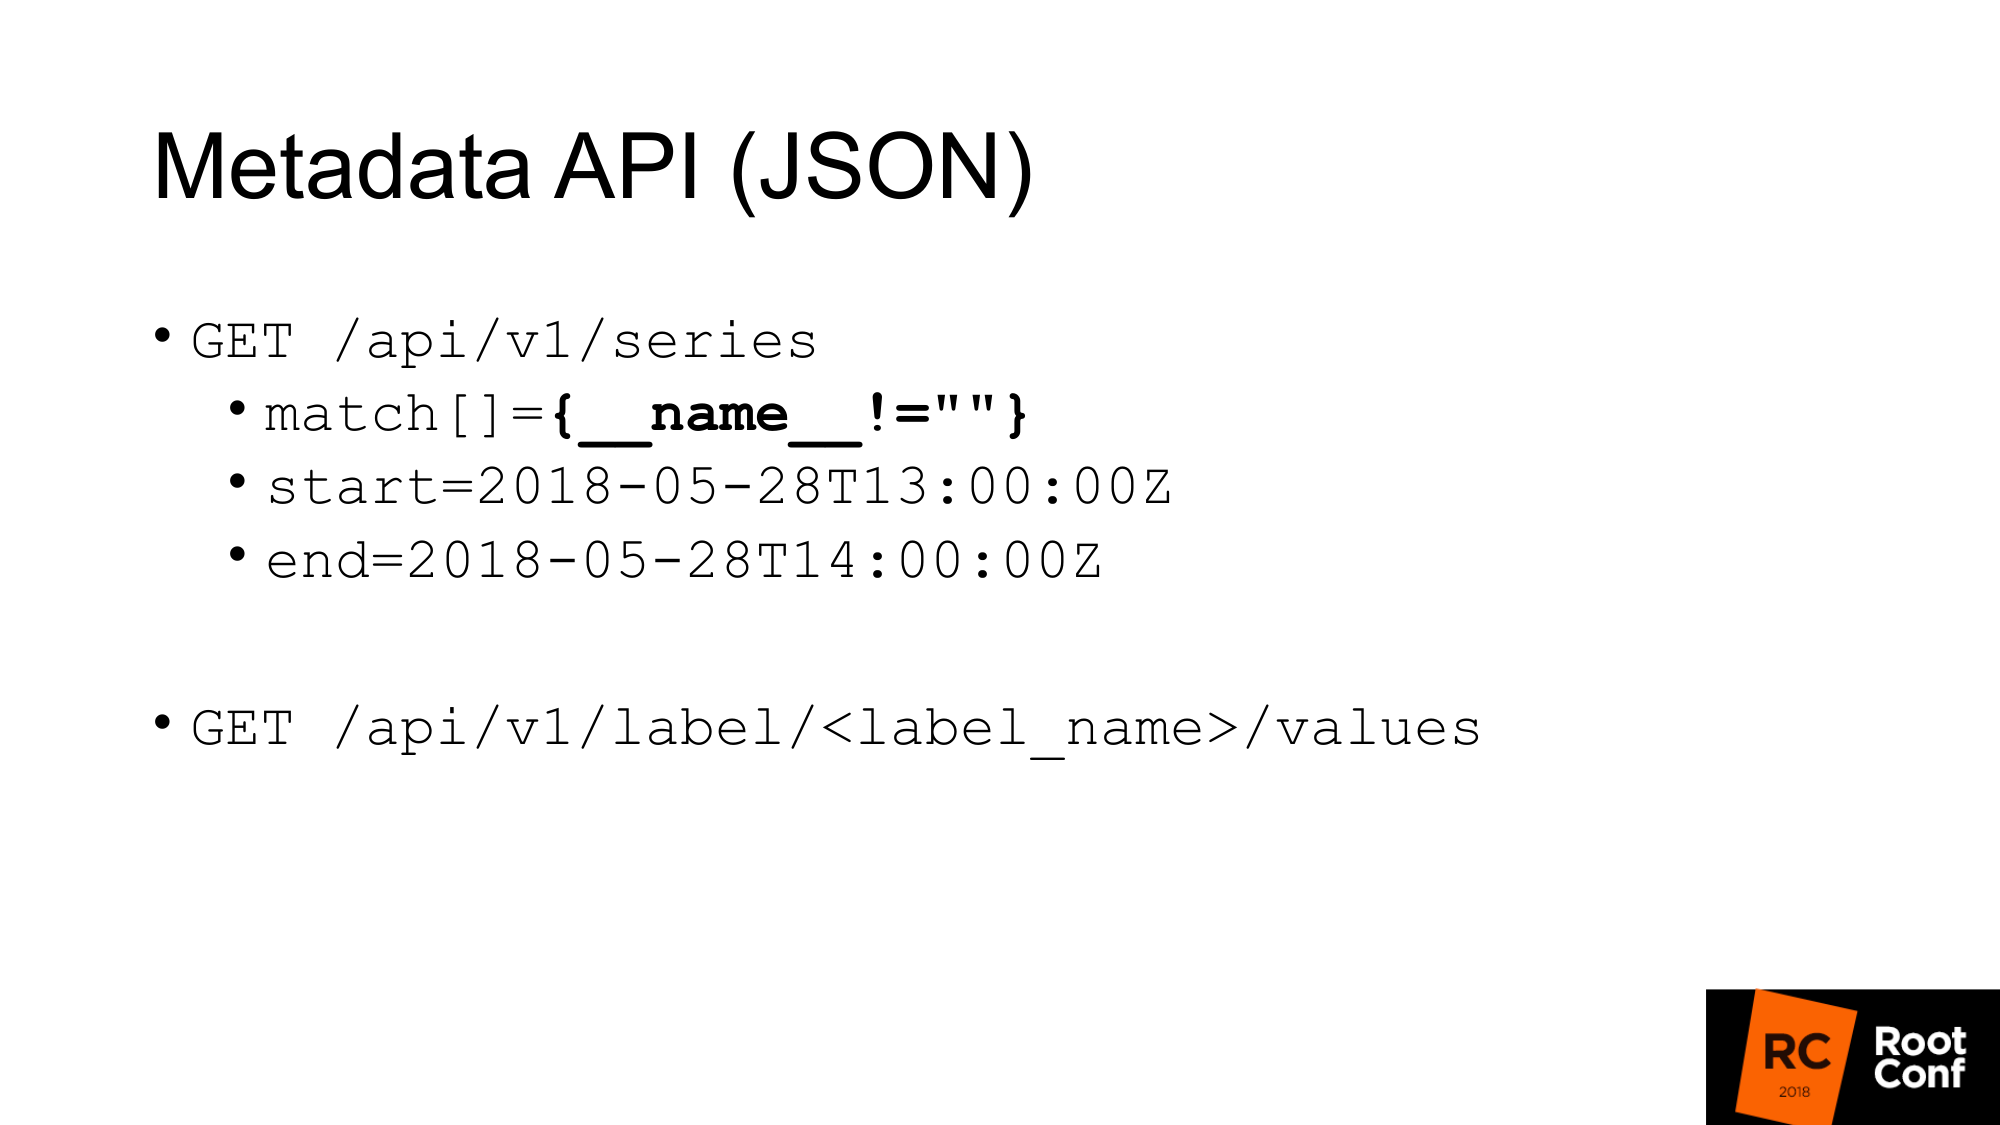
У нас есть API для получения метаданных. Если мы хотим получить все названия метрик, мы делаем вот такой запрос, где match это массив метрик. Их может быть несколько аргументов, но в данном случае мы передаем тот же самый match, который нам возвращает всё.
Второй мета API, который возвращает нам значение всех лейблов. Если мы хотим увидеть список всех job, мы вместо label_name пишем job и получаем этот список. Эти API возвращают нам JSON.
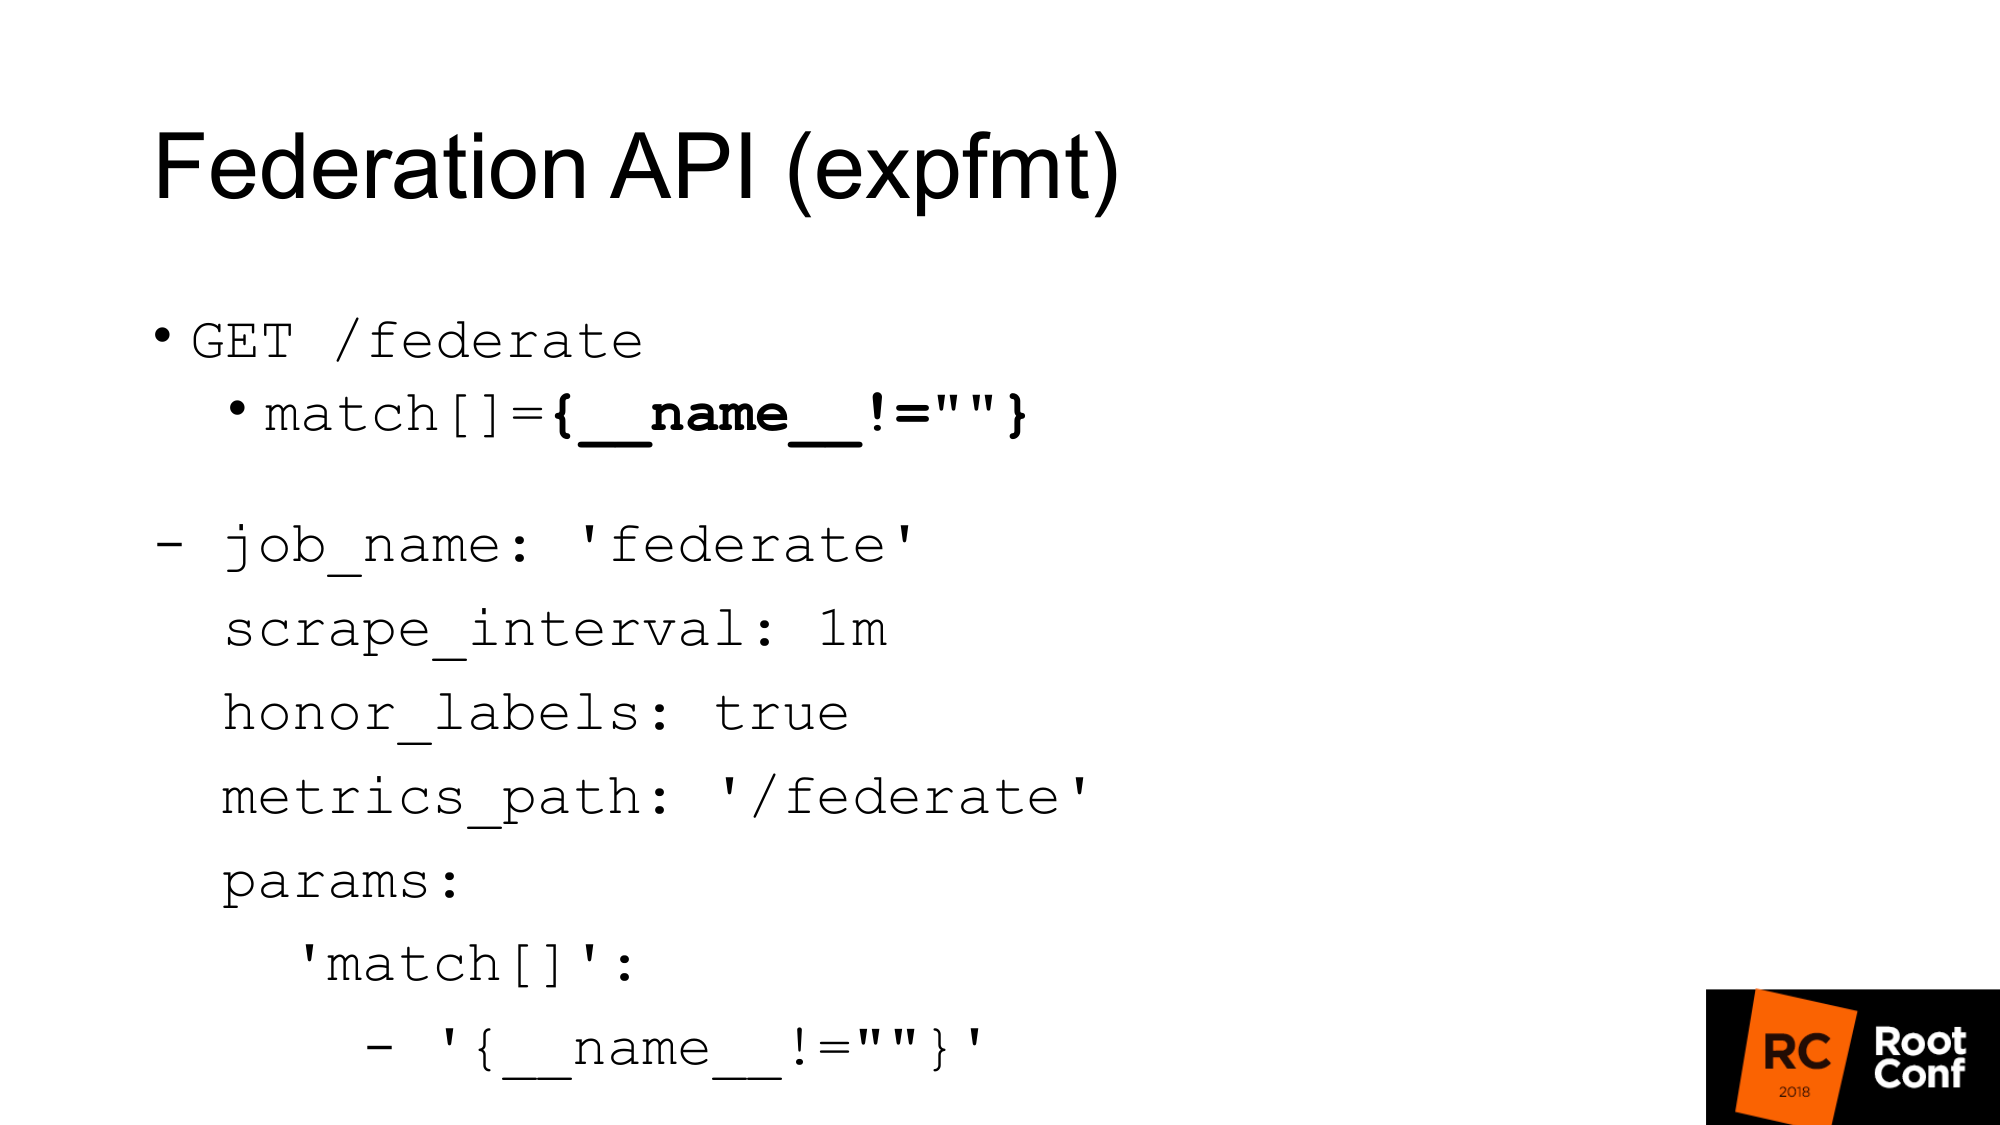
Есть еще один API, который возвращает нам все метрики самого Prometheus в формате, который является нативным для экспортеров. Формат называется expfmt. В самом Prometheus есть Federation API, который вам позволяет сделать такой запрос. Для чего это нужно? Самый простой вариант, если у вас есть какой-то код, который уже работает с expfmt, то вам не нужно его переучивать на то, чтобы работать с каким-то custom JSON API. Этот формат гораздо проще стримится, потому что если у вас JSON где-то на верхнем уровне объекта, чаще всего вам нужно этот объект распарсить целиком. Здесь это можно делать по строчке.
Самое главное это то, что это отдельный API. Он работает именно как настоящий export. Вы можете взять и другим Prometheus его заскрейпить. Это обычный job с обычными параметрами. Вам нужно передать параметр — query url. Если вы сделаете запрос curl, вы получите здесь то же самое. Мы получаем все метрики для текущего значения времени. Единственный нюанс: необходимо установить honor_labels для того, чтобы Prometheus, который будет скрейпить другой Prometheus через этот API, не перетирал значение job и instance label. Используя этот Federation API, вы можете загрузить все данные из одного Prometheus в другой.
Как это можно использовать?
Во-первых, надо самое главное сказать, что так делать не надо. TSDB оптимизирован для другого режимы работы. Если у вас есть Prometheus, которой скрейпит много данных, то он делает большое количество ввода-вывода. Если вы используете Federation API, то количество ввода вывода увеличивется примерно в 2 раза. Есть нюансы. В зависимости от того, как часто вы делаете скрейпинг на federate и как часто вы скрейпите таргеты. Если время не меняли, то это действительно увеличивает нагрузку в два раза. Поэтому если вы хотите заскейлить ваш Prometheus и включить федерейшн, то вы его убьёте. Нагрузка увеличится два раза.
Второй момент. Вы будете пропускать данные. Вы получите конфликт данных. Почему так? Этот API, как почти любой API в Prometheus, не атомарный. Если придут новые данные, закончится новый скрейп в тот момент, когда ваш federate запрос еще идет, вы можете получить для одной time series одни данные, для другой — уже новые. Если это не связанные time series, то это в целом не страшно. Но если у вас summary или гистограмма, которые на уровне expfmt представляется нескольким базовым метриками, то между ними будет несогласованность.

Как мы можем решить эту проблему атомарности? В Prometheus есть recording rules, который позволяет создать новую time series из существующей time series. Это можно делать реже. Это один из способов сделать downsampling. Например, скрейпите target каждую секунду, но дальше мы хотим сделать агрегацию node_cpu за одну минуту. Группировка в Prometheus 2.0 позволяет вам делать эти агрегации последовательно. Правила, которые находятся в одной группе, выполняется строго последовательно. В этот момент нет проблемы атомарности, нет проблемы, что данные поменяются в процессе. Но это не решает проблему того, что это допустим какие-то другие данные, которые связаны логически с этими, но не связаны с точки зрения модели данных. Чистой атомарности пока нет. Есть открытый issue на эту тему. Можно делать снапшоты. Можно сделать запрос PromQL к базе данных TSDB и из полученных значений отбросить все сэмплы, которые меньше какого-то значения времени, в которое началось в evaluation. Это был бы самый простой способ, но пока его не сделали.
Важно понимать что recording rules нужно делать на нижнем Prometheus, а не на том, который делает federation. Иначе вы будете пропускать пики, у вас неправильно будет работать мониторинг.
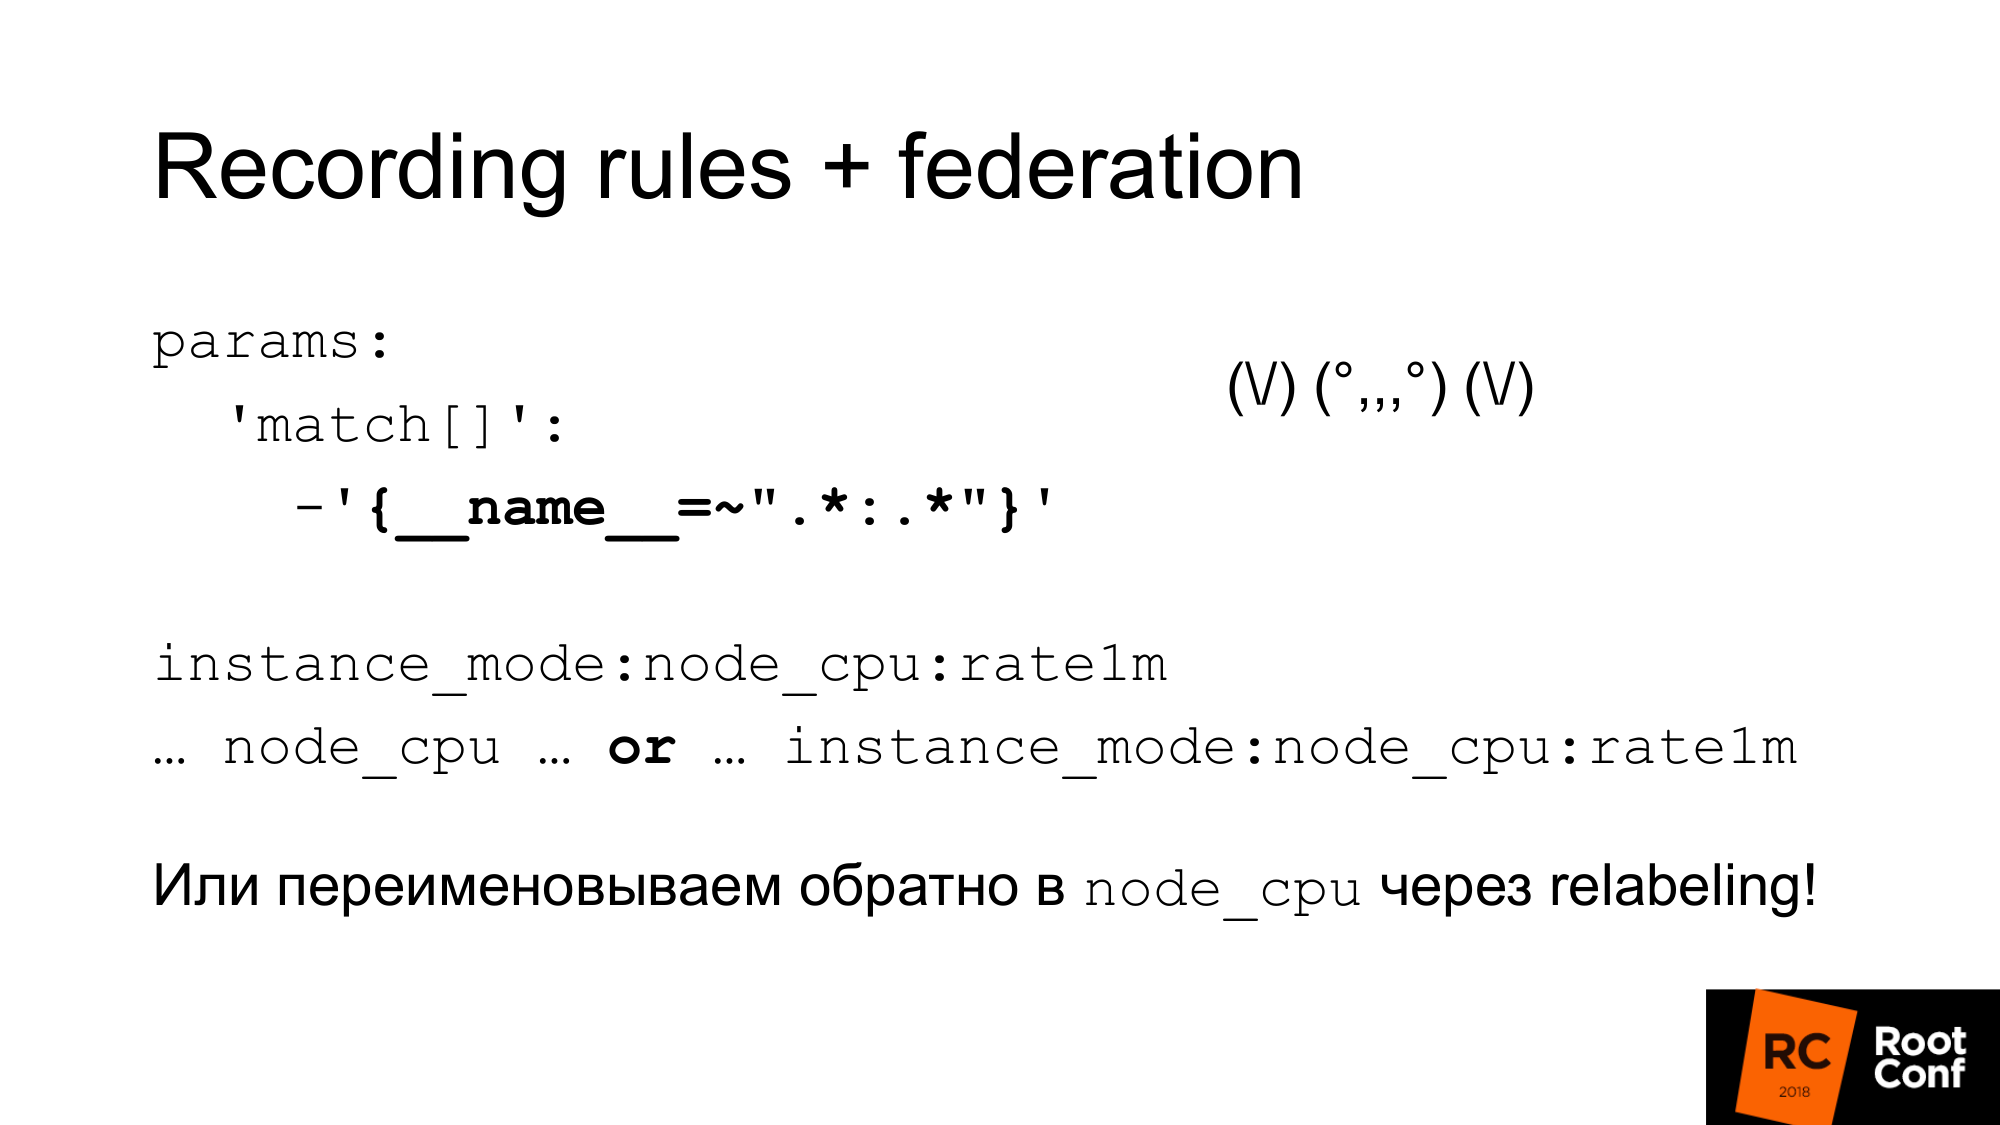
Как мы можем использовать эту комбинацию этих вещей для того чтобы сделать downsampling и долговременное хранение.
Первое. Мы просто ставим federation и загружаем все данные с того Prometheus. Это странное регулярное выражение похожее на зойдберга — это на самом деле просто двоеточие. Слева и справа от двоеточия звездочка. Мы используем стандартное название для recording rules, которое добавляет двоеточие в середину. При делении оригинального имени слева будет уровень агрегации, а справа функция. У нормальной метрики двоеточия нет. Если есть двоеточие, то это признак того, что это агрегация. После этого мы используем это название метрики в нашем графике. Если мы хотим, чтобы наш график, наш дашборд в grafana работал и c главным Prometheus, и c тем кто стоит выше, мы можем использовать выражение or. Мы берем либо одну метрику, либо другую, в зависимости от того которая есть. Мы можем схитрить и при помощи relabeling переименовать новую в метрику в старое имя. Это довольно опасный подход. Можно неправильно написать регулярные вложения и у вас будет конфликт time series. Prometheus будет писать много warnings в лог. Вы это увидите, но найти причину может быть довольно сложно. Но если сделать аккуратно, например сгенерировать эти регулярные выражения программно, то это будет работать. Дальше у вас будет обычный дашборд, где используется только node_cpu. В зависимости от того, какой Prometheus используется, вы будете получать либо исходные данные либо же агрегированные.
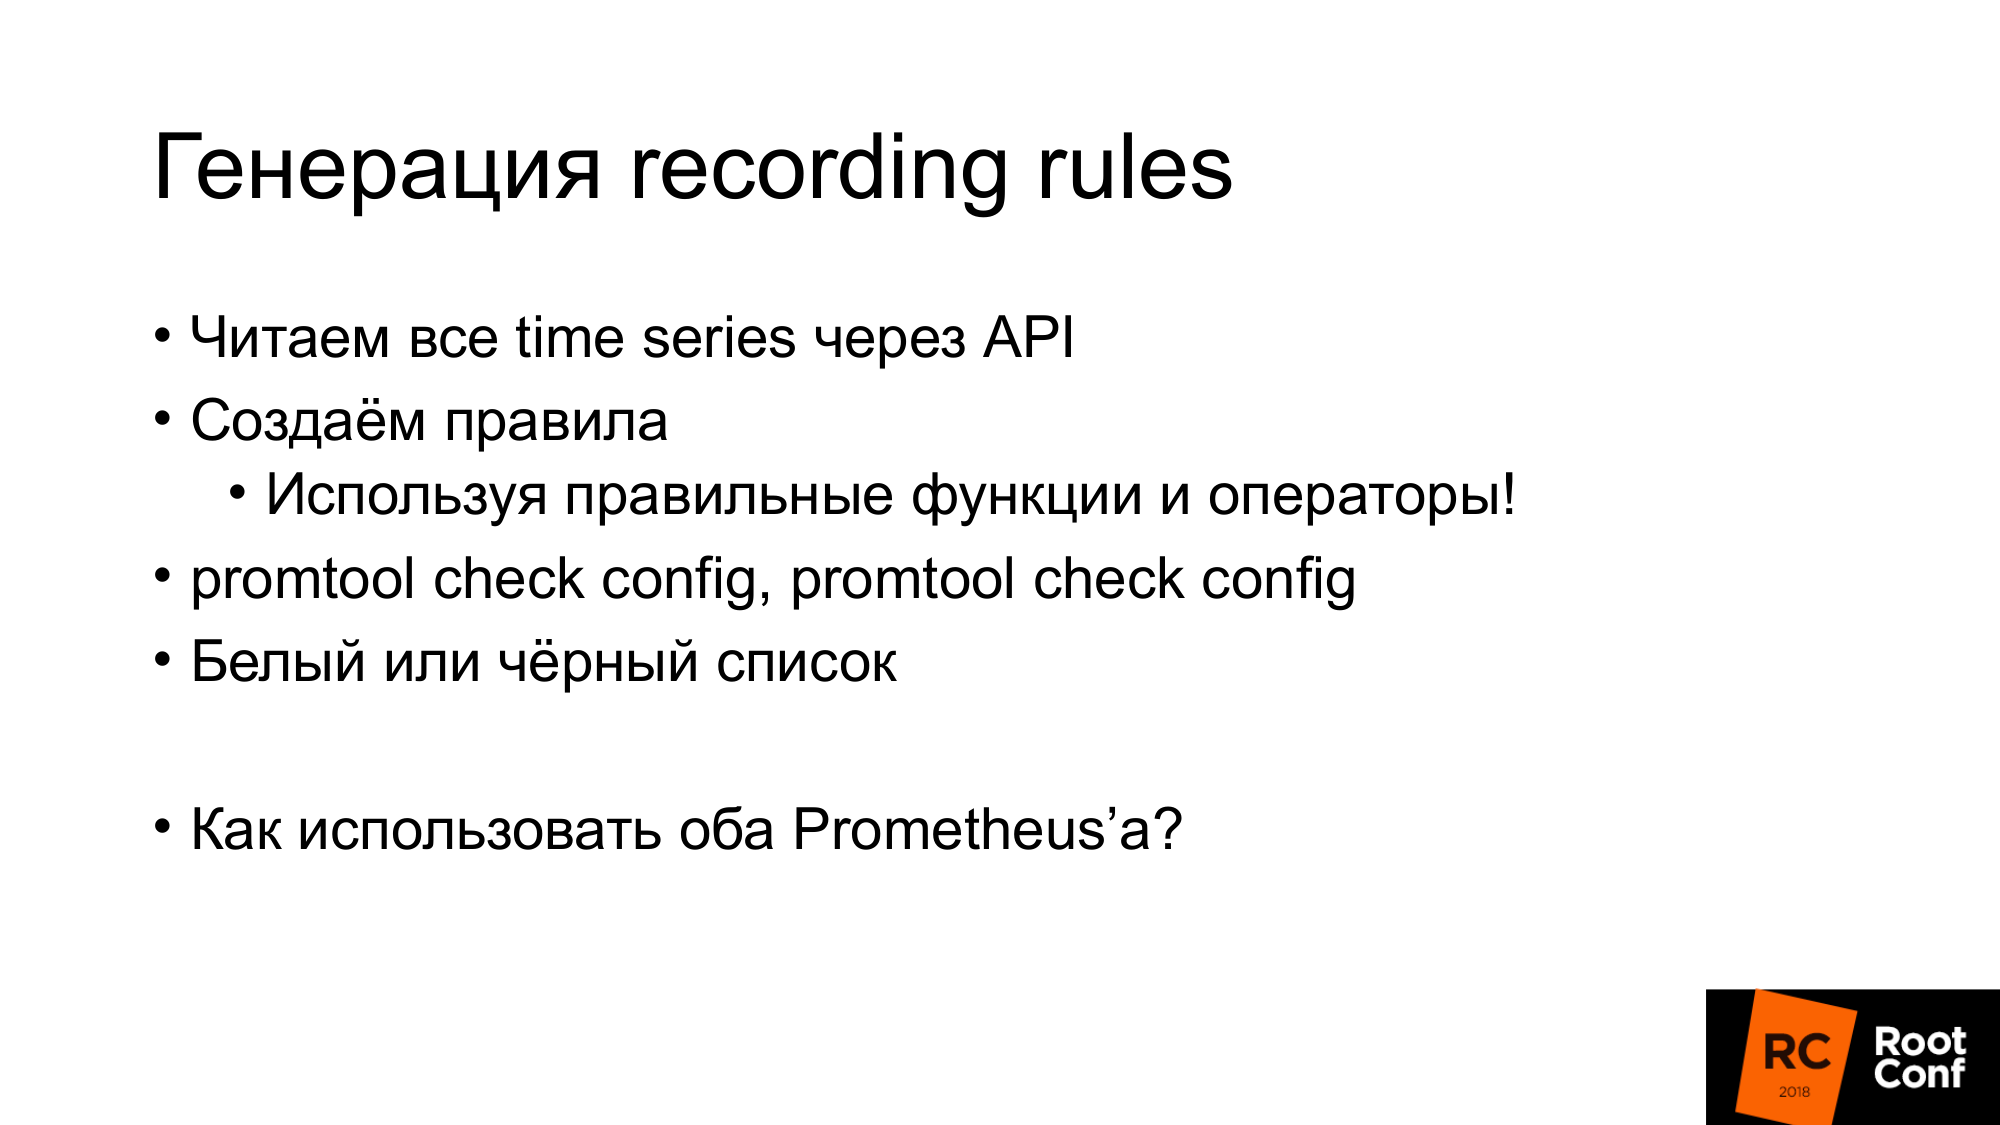
Как я уже сказал, recording rules можно генерировать довольно просто. Мы просто получаем все time series через api, которые я уже показывал. Мы создаем правила и эти правила должны использовать правильные функции и операторы. Не нужно использовать там rate с gauge. Это будет неправильно работать. Нужно использовали только с count. На том уровне, где вы работаете, у вас может не быть информации о типах данных. Например, если вы используете expfmt. Там информация о типах есть. Если JSON API, там этого нет. Как следствие, выражение, которые вы автоматом сгенерируете, может не иметь никакого физического смысла. Поэтому, можно использовать там либо белый список либо черный список. В зависимости от этого генерировать либо нужное вам правило, либо выкидывать те правила, которые не имеют смысла. Есть инструмент promtool, который позволяет вам проверить, что те правила, которые вы сгенерировали, тот конфиг, который вы сгенерировали, он имеет смысл. Он имеет корректный синтаксис.
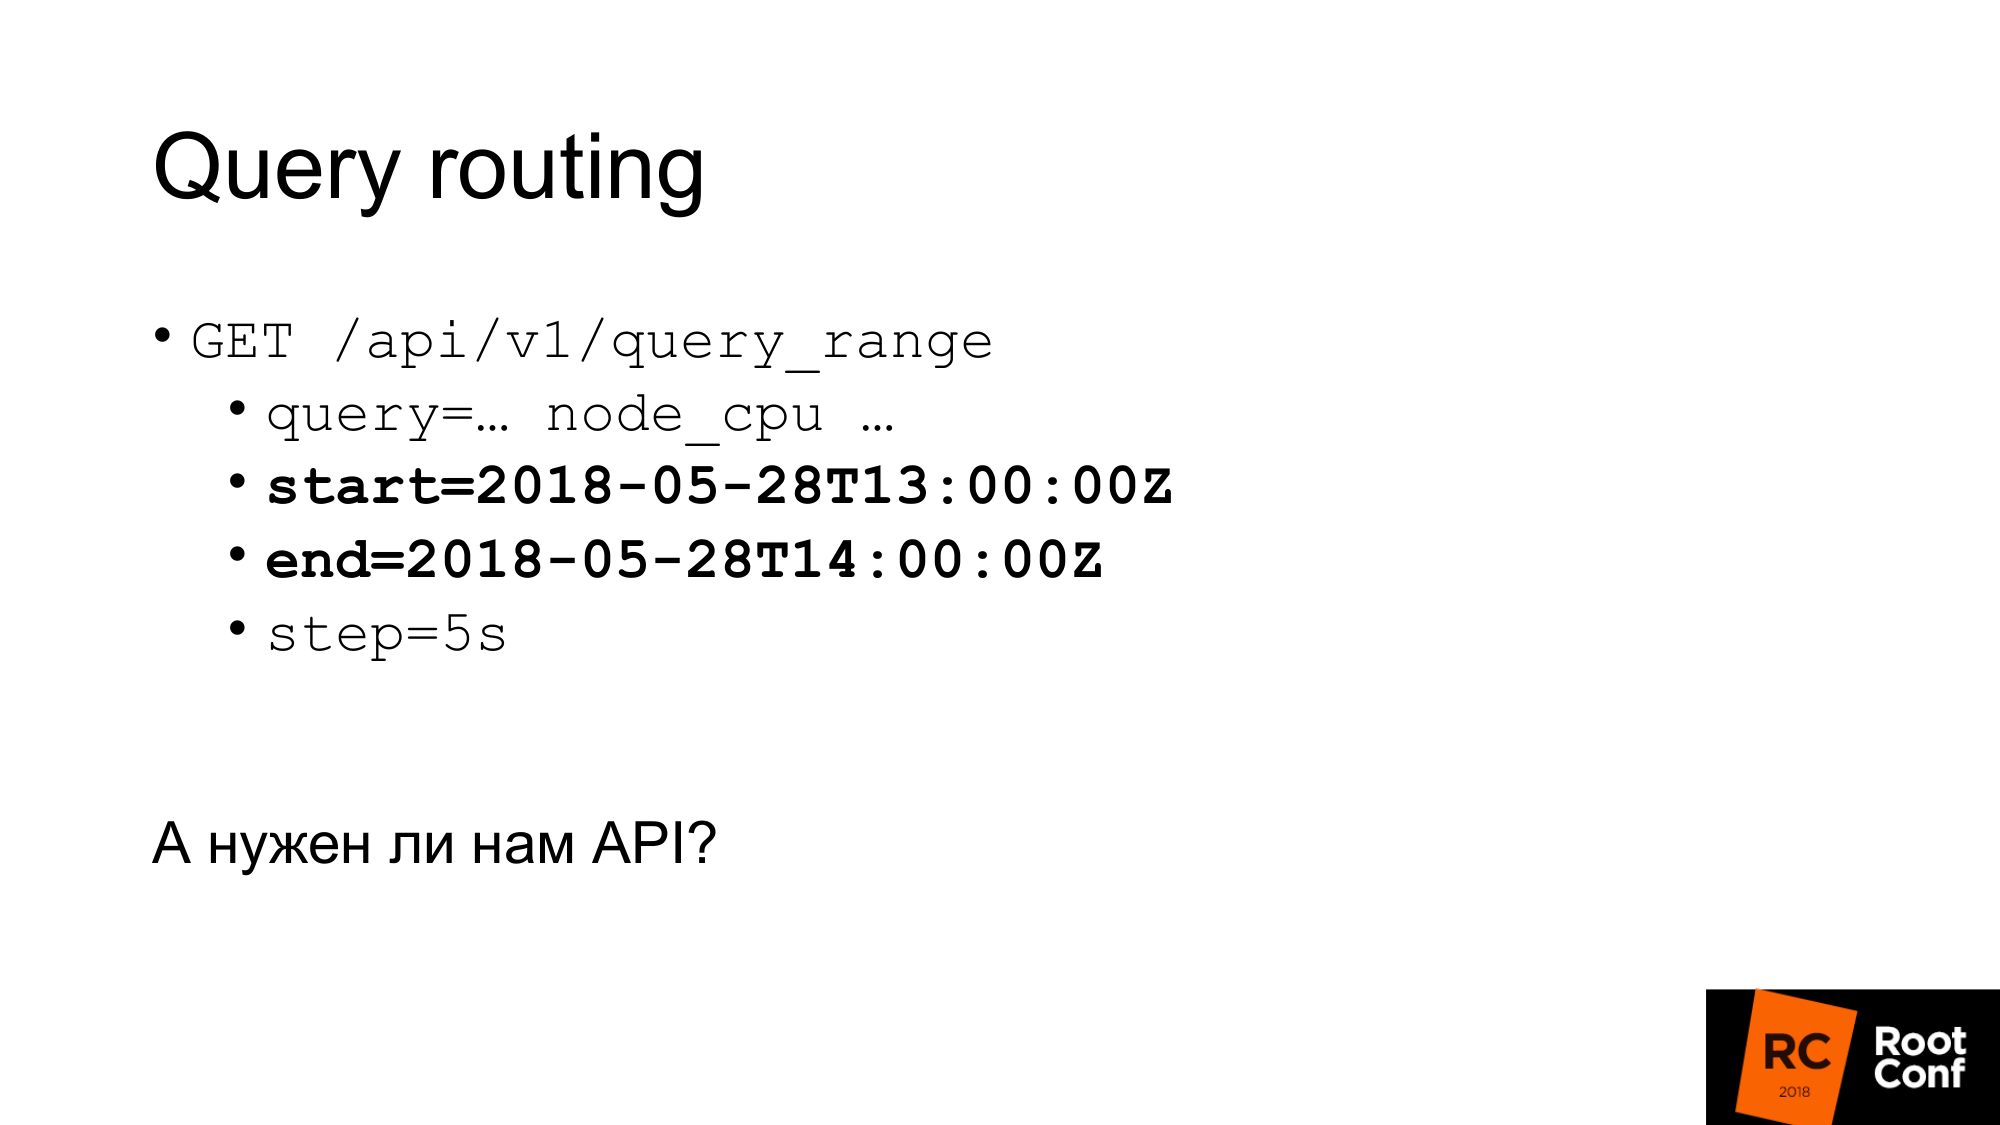
Если у нас есть Grafana и там несколько Prometheus, нам нужно знать, на какой Prometheus отсылать запрос. Как бы нам это сделать?
Один из способов — это поставить специальный прокси, который будет смотреть на время в запросе, и в зависимости от этого выбирать Prometheus. В запросах есть время начала и время конца. В зависимости от этого можно руками делать роутинг. Можно было бы написать какую-то программу, которая это делает. На практике это делается nginx с модулем lua или небольшой программой.
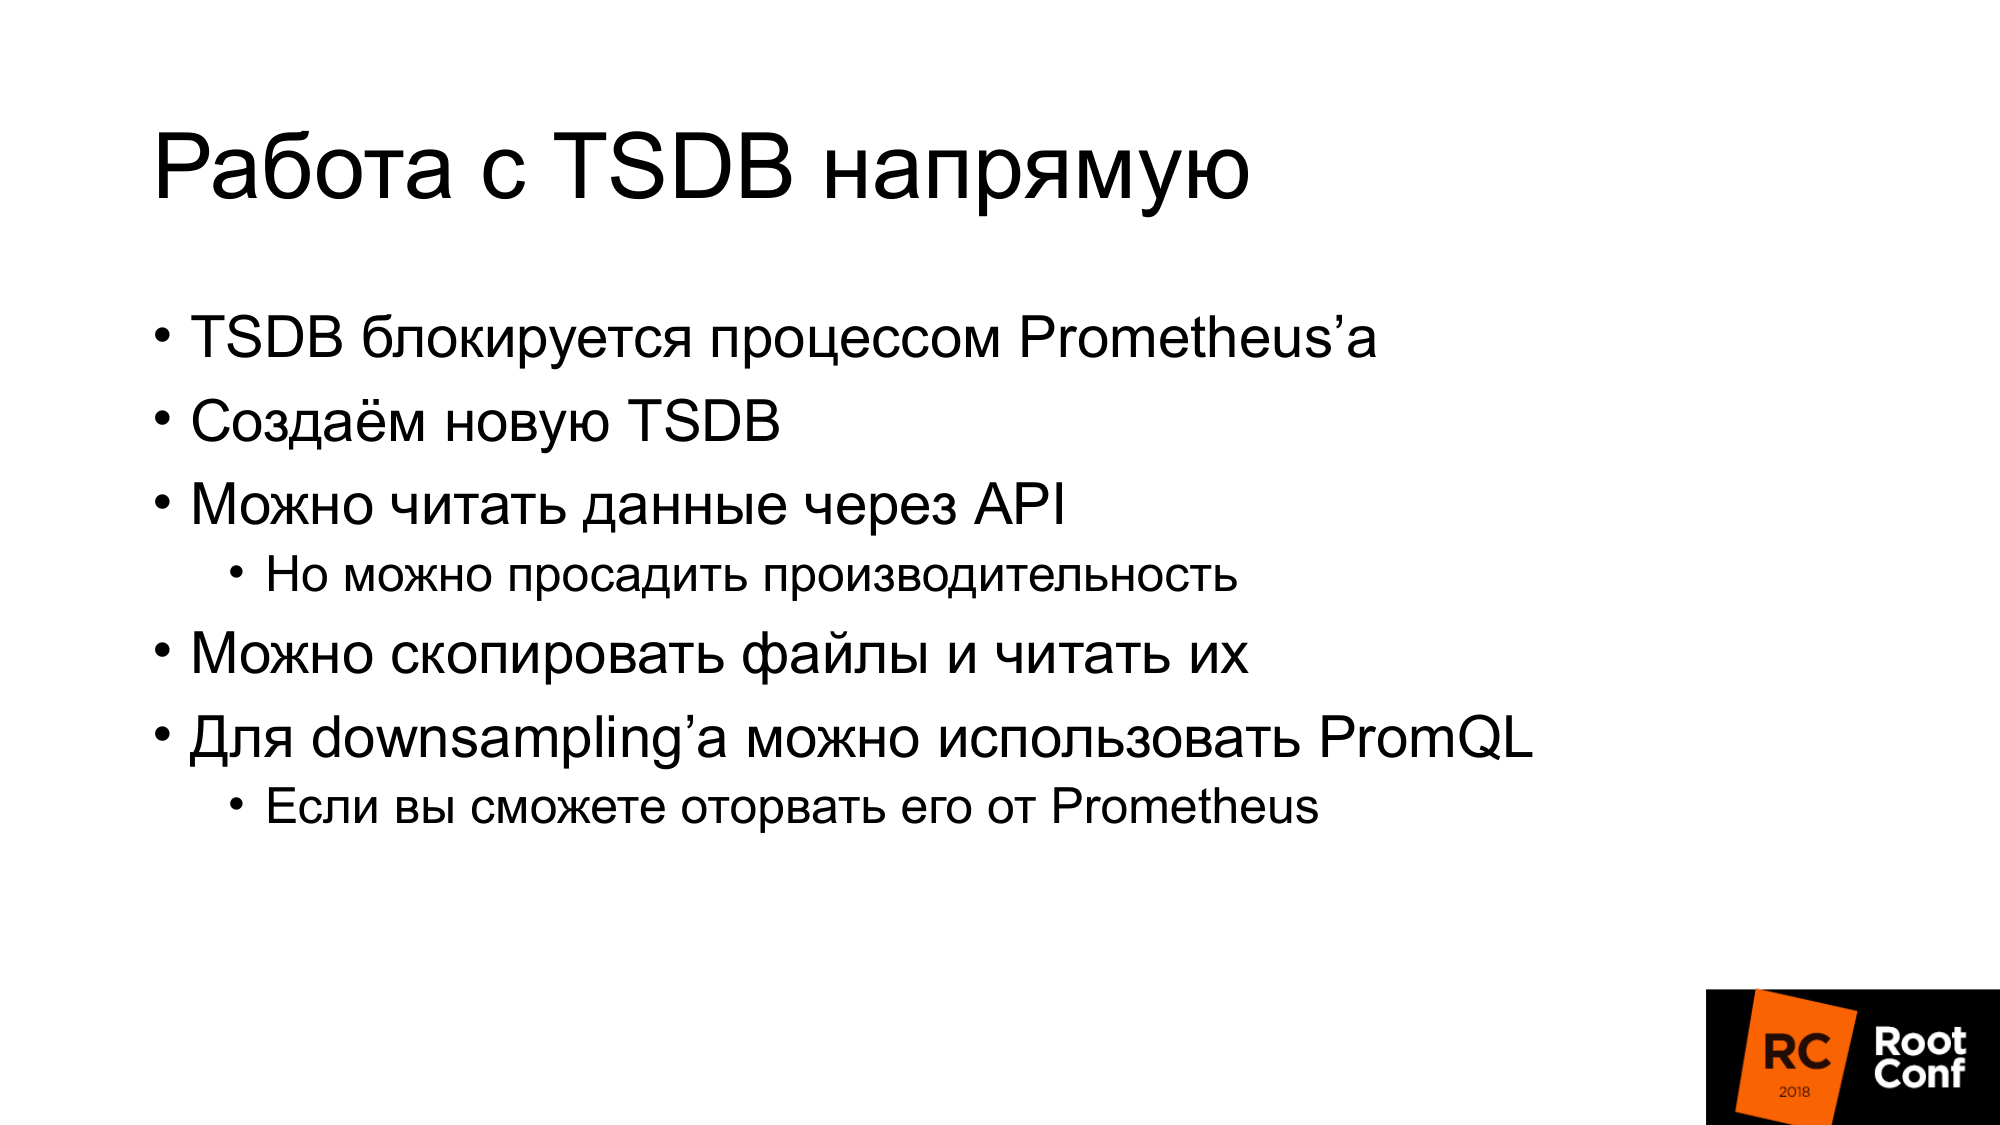
А нужен ли нам вообще API? Можем ли мы работать с TSDB напрямую? Есть нюанс. Во-первых, если мы пытаемся использовать TSDB, который используется Prometheus сейчас, мы этого сделать не сможем. Там есть специальный lock-файл, который предотвращает это. Если мы напишем код, который будет игнорировать это и будем пытаться читать или писать данные, мы гарантированно их повредим. При этом даже чтением. Что можно сделать? Можем читать данные через API и создавать TSDB рядом. Дальше Prometheus остановить и его TSDB подменить. Но при этом мы можем просадить производительность, если будем читать все данные через API. Я об этом немного позже скажу.
Второй вариант. Можно скопировать (сделать hot backup) этих файлов, то есть скопировать как есть. Да, они будут поврежденные. Когда вы откроете, у вас будет warning о том, что данные повреждены. Их нужно починить. Вы можете потерять новые данные. Но нам это не важно. Мы хотим downsampling старых данных. Downsampling можно сделать используя PromQL. Но есть нюанс. Его оторвать от Prometheus гораздо сложнее, чем TSDB. Если вы немного знакомы с Go и c управлением зависимостями, то вендоринг (vendor) PromQL это большая боль. Я бы вам не советовал. По возможности избегайте этого.

Переходим к Remote Storage. Кто-нибудь работал с Remote Storage в Prometheus? Несколько рук. Remote Storage — это API, которое давно уже существует. Сейчас в версии 2.2 Remote Storage — помечен как экспериментальный. Более того известно, что API Remote Storage точно поменяется.
Remote Storage позволяет вам работать только с сырыми данными. Там нет никакого PromQL ни на входе, ни на выходе. Когда вы читаете, вы не можете использовать всю мощь PromQL. Он по сути выкачивает все данные из Remote Storage, которые соответствуют условию. Дальше PromQL работает уже с ними. Это имеет довольно большой overhead. Вам нужно много данных прокачивать по сети. Поэтому в Prometheus 2.3, который пока не вышел, но уже это вмержили, будут read hint. Мы чуть позже об этом поговорим.
API для metadata пока что отстутствует. Вы не можете сделать API, которое возвращает все time series из Remote Storage. Если вы сделаете запрос в API у Prometheus, то он в Remote Storage не пойдет. Он вернет вам time series, которые есть в его локальной базе данных. Если у вас локальная база данных отключена, он вернет вам 0. Что может быть немного неожиданно. Сейчас этот API использует ProtoBuf и точно его поменяют на gRPC в будущем. Cейчас это пока что не сделали, потому что gRPC требует HTTP2. А у них на практике с ним были проблемы.
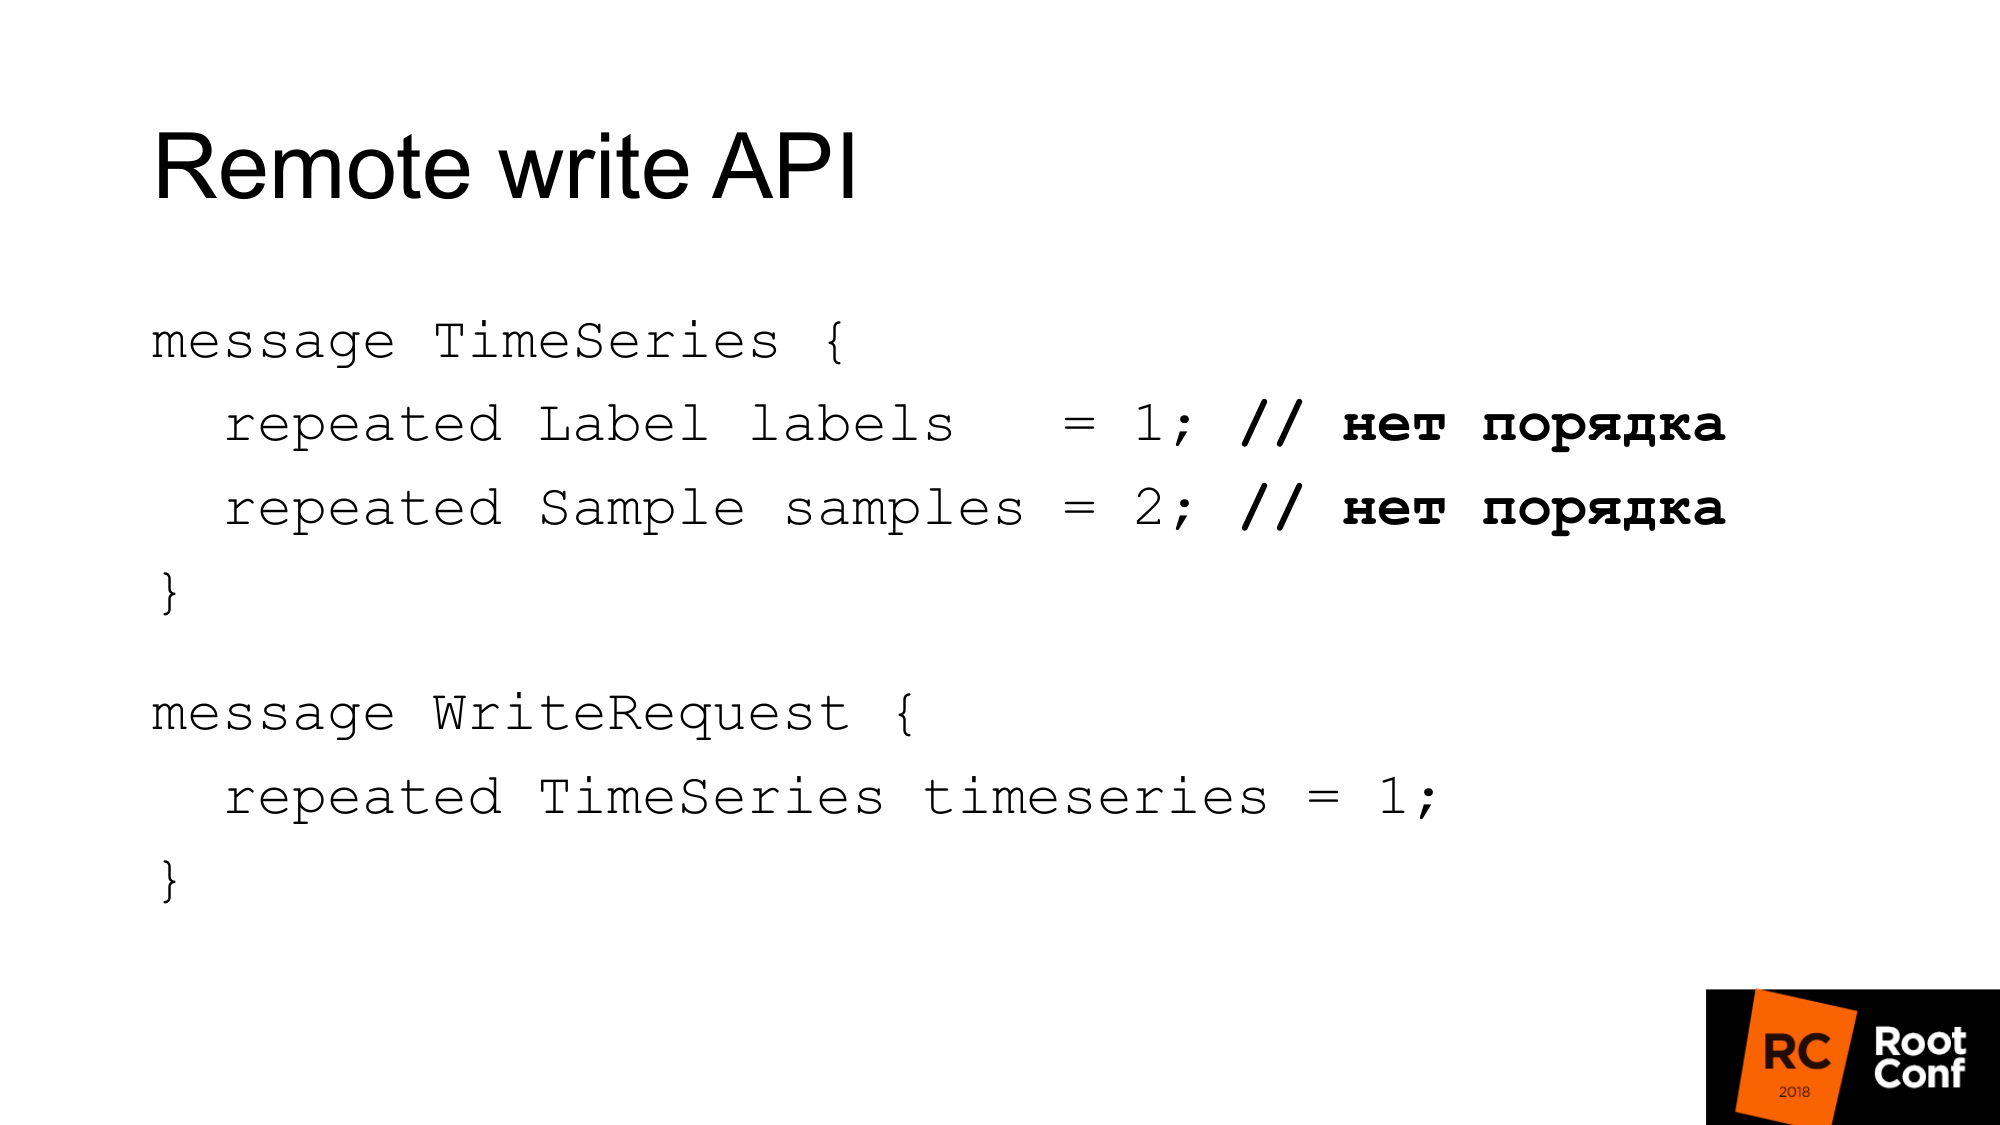
API для записи выглядит вот так. В запросе есть набор лейблов. Набор лейблов как раз уникально индентифицирует time series. __name__ — это на самом деле просто лейбл со специальным именем. А сэмплы — это набор времени и значения — int64 и float64. При записи порядок неважен. Предполагается, что база данных, которая это пишет в себя, сама все сделает правильно. Prometheus может сделать некоторую оптимизацию и не сортировать это лишний раз. Соответственно запрос на запись — это просто несколько time series.
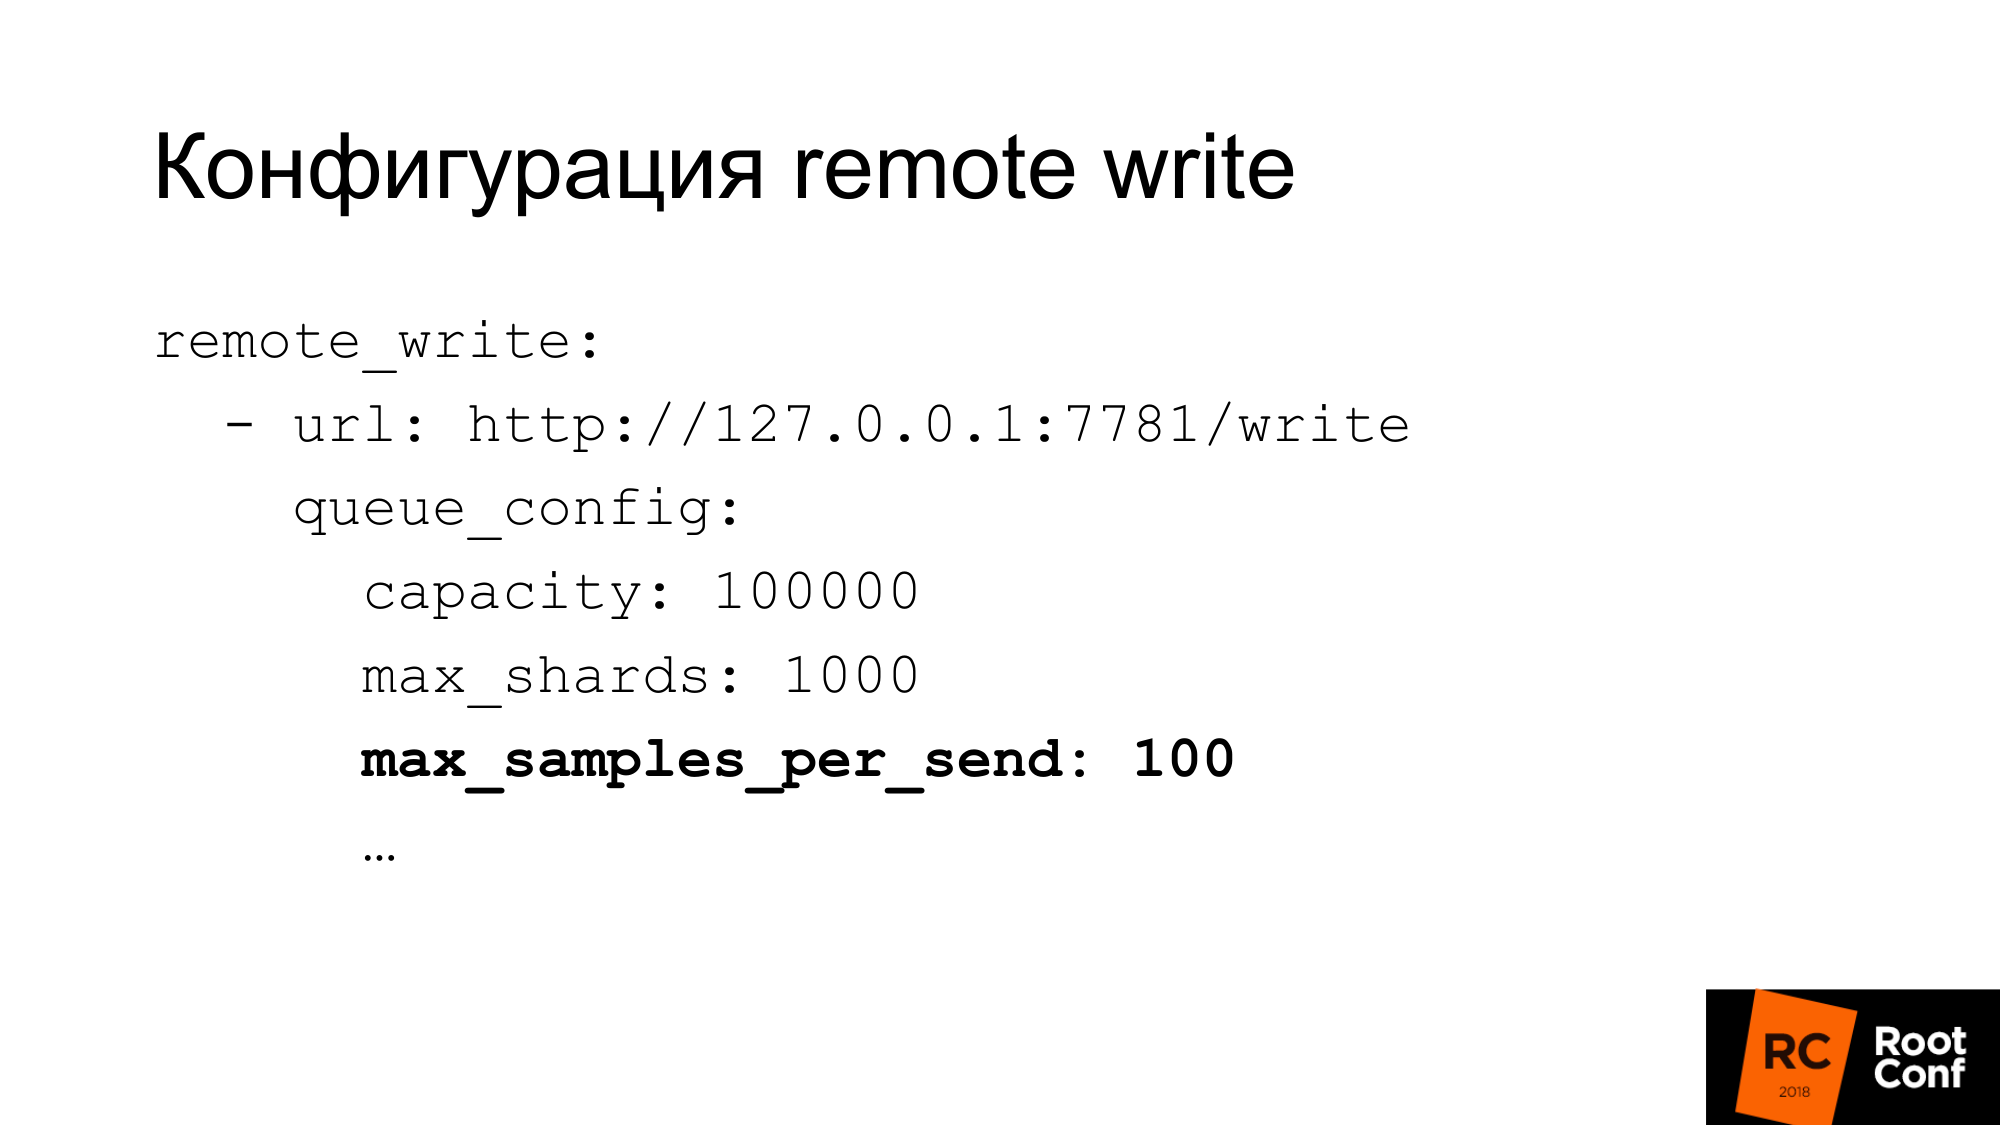
У конфигурации на запись довольно гибкая настройка. Там много параметров для конфигурации параллелизма записи. То что Prometheus называет шардами — это по сути конкурентные запросы. Можно ограничить максимальное количество сэмплов в одном запросе, максимум параллельных запросов, timeout, как повторять, какой backoff. Для многих баз данных 100 сэмплов за раз — это может быть очень мало. Если вы используете ClickHouse, как это делаем мы, то конечно значение надо сильно увеличивать. Иначе это будет очень неэфективно.
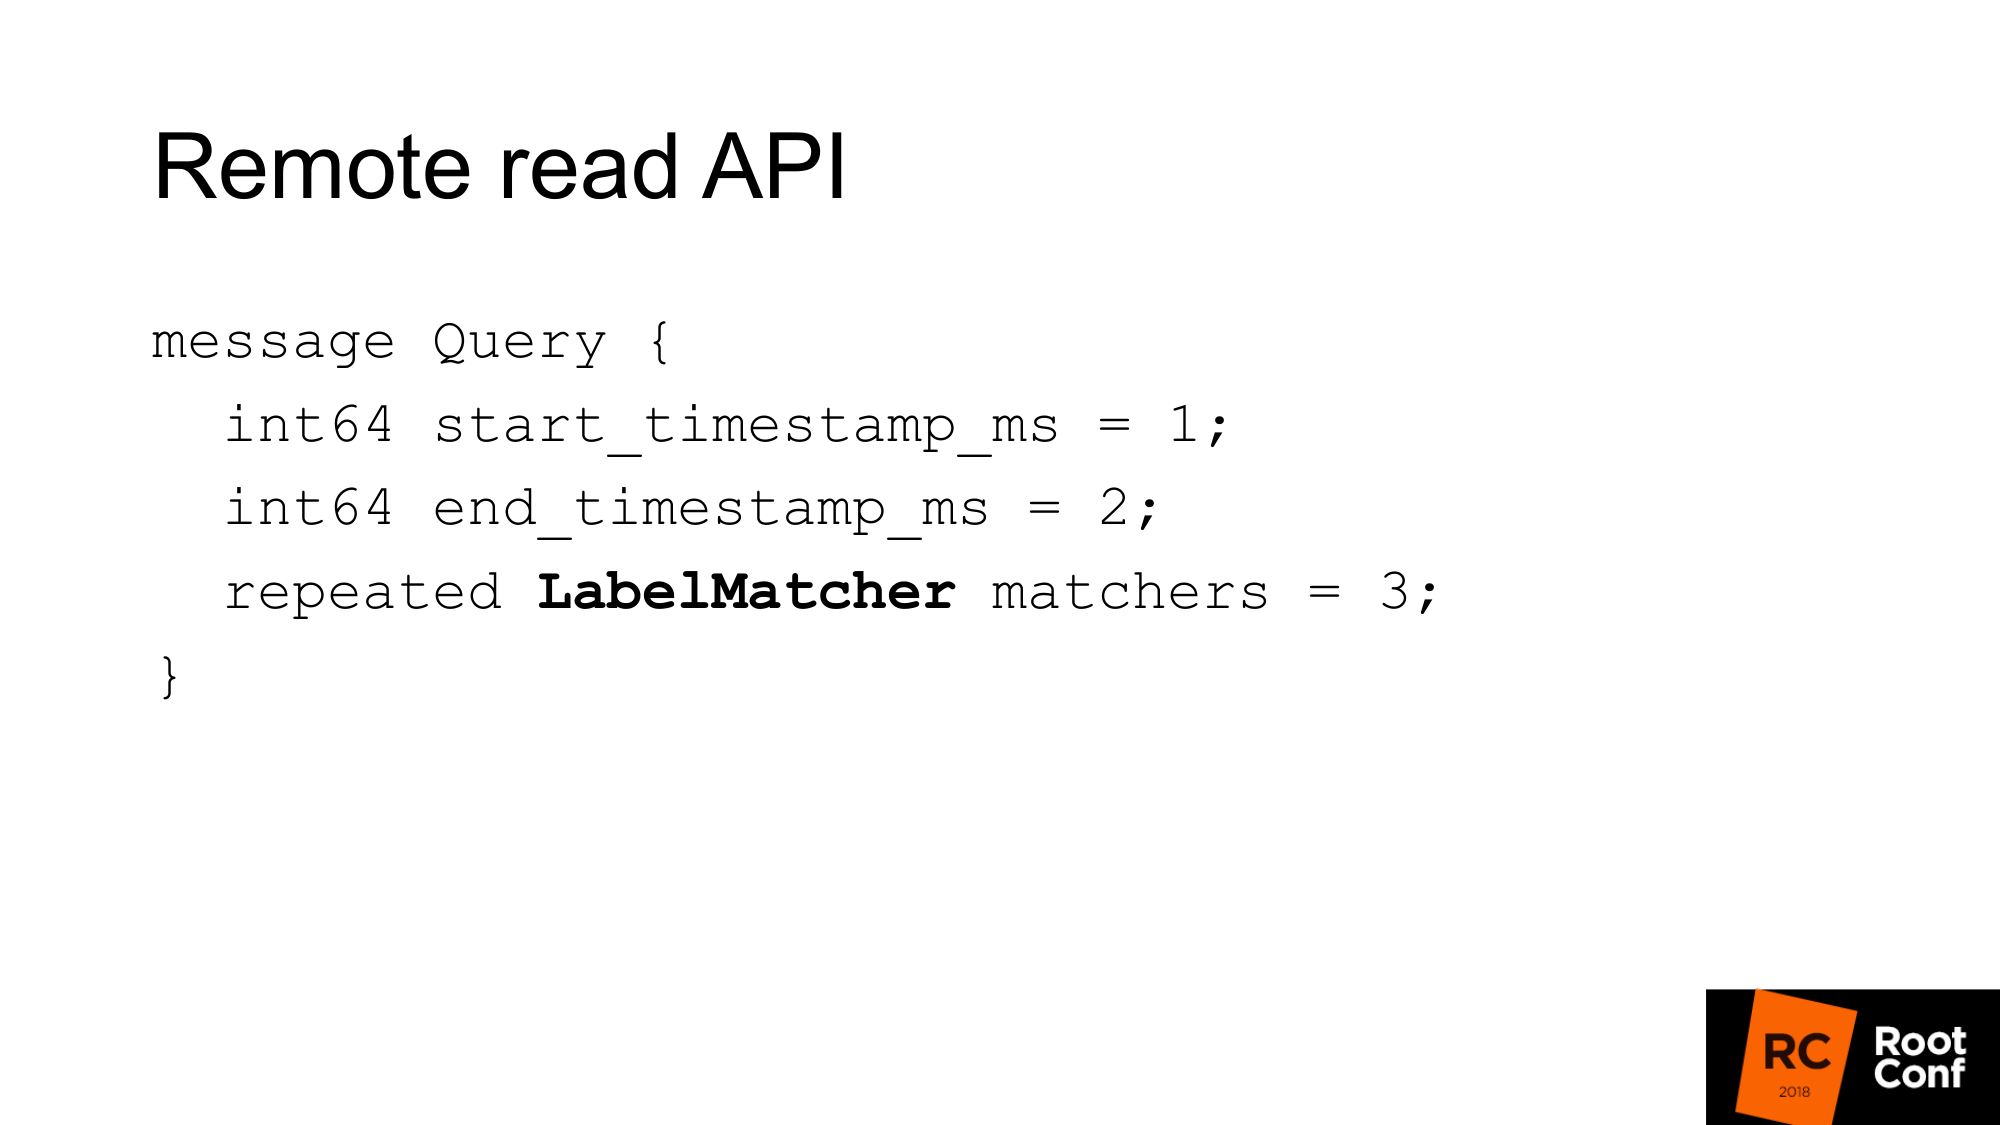
Remote read API выглядит вот так. Это просто диапазон по времени от начала до конца и набор match.
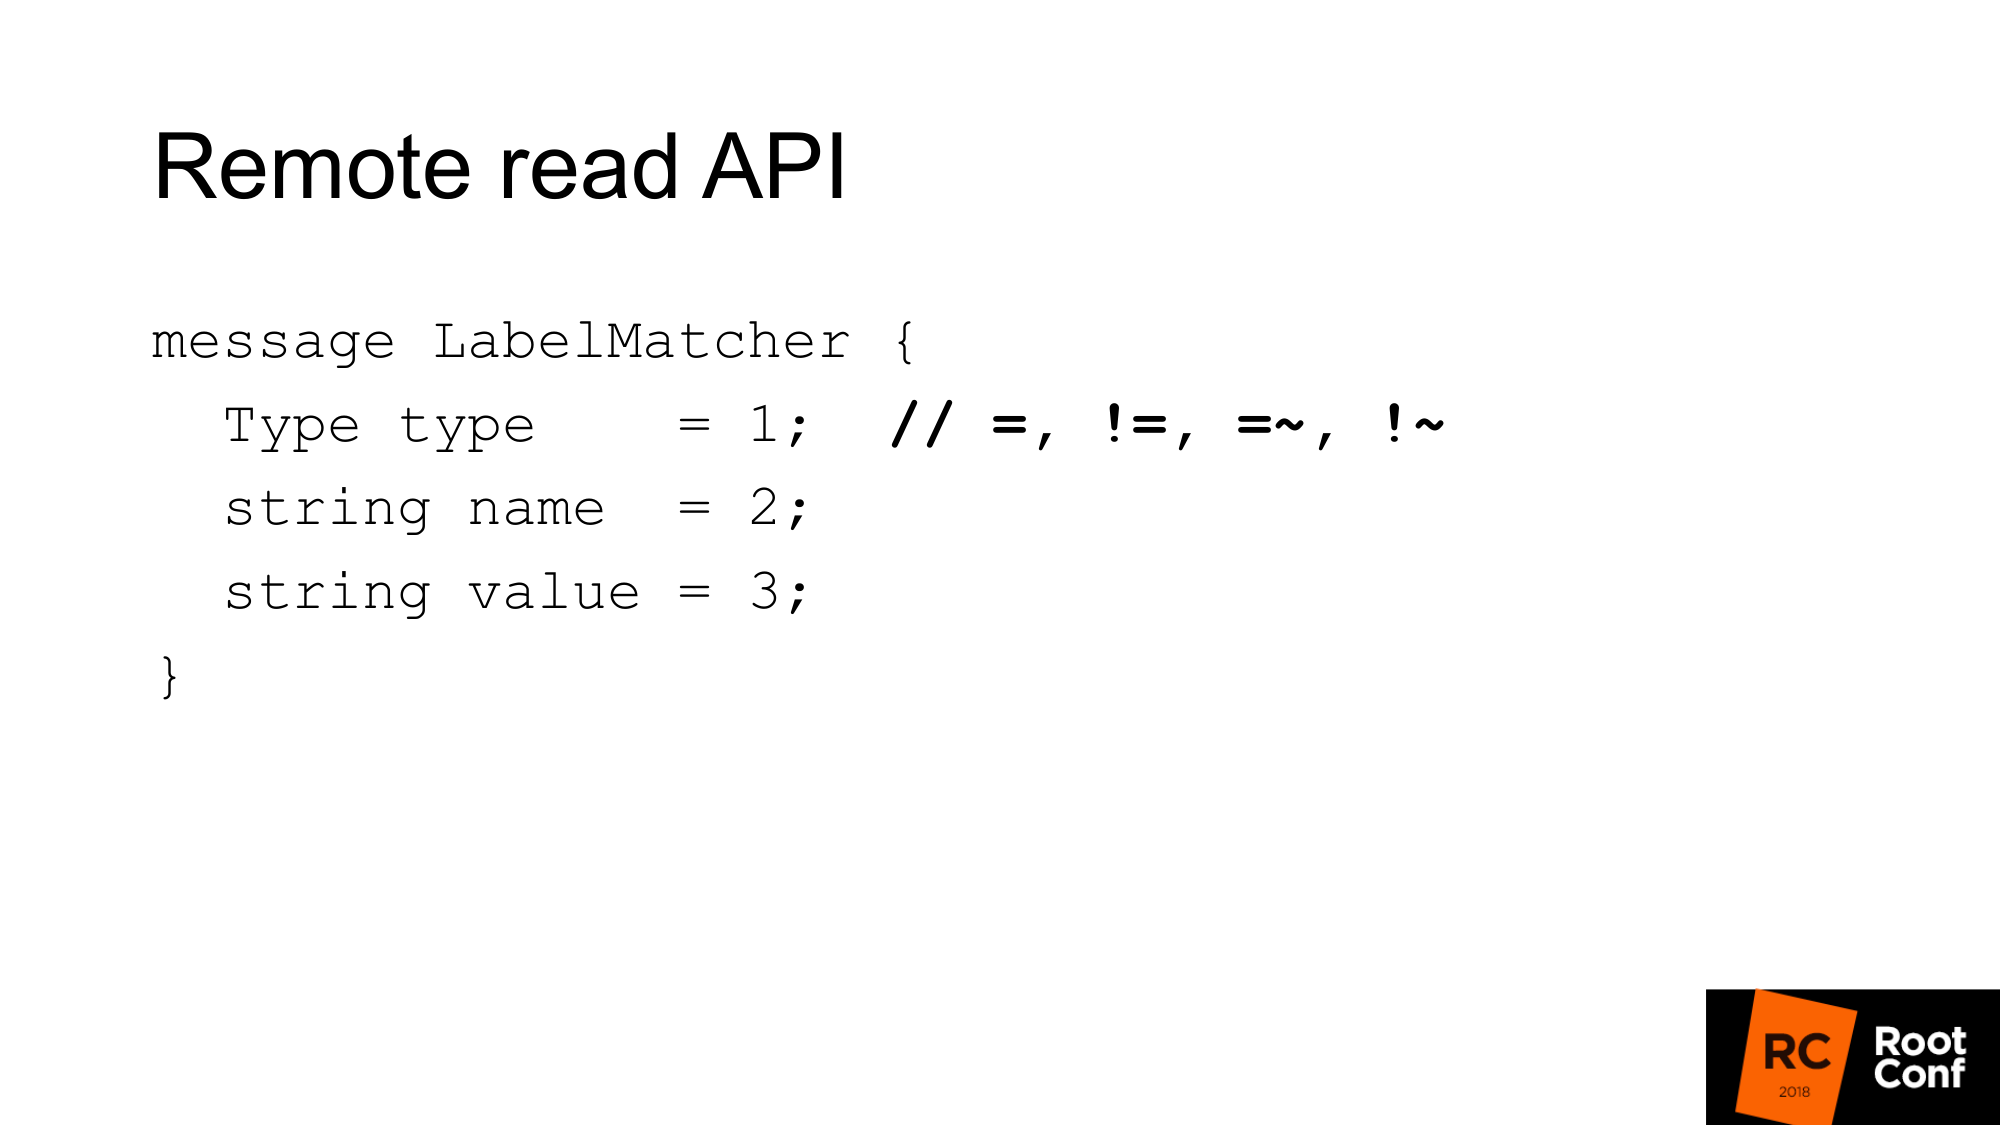
Match — это по сути набор пар name и value — обычный лейбл и тип условия. В сравнении есть равенства, неравенства или регулярное выражение. Это обычный time series selector, который вы видите в PromQL. Никаких функций здесь нет.
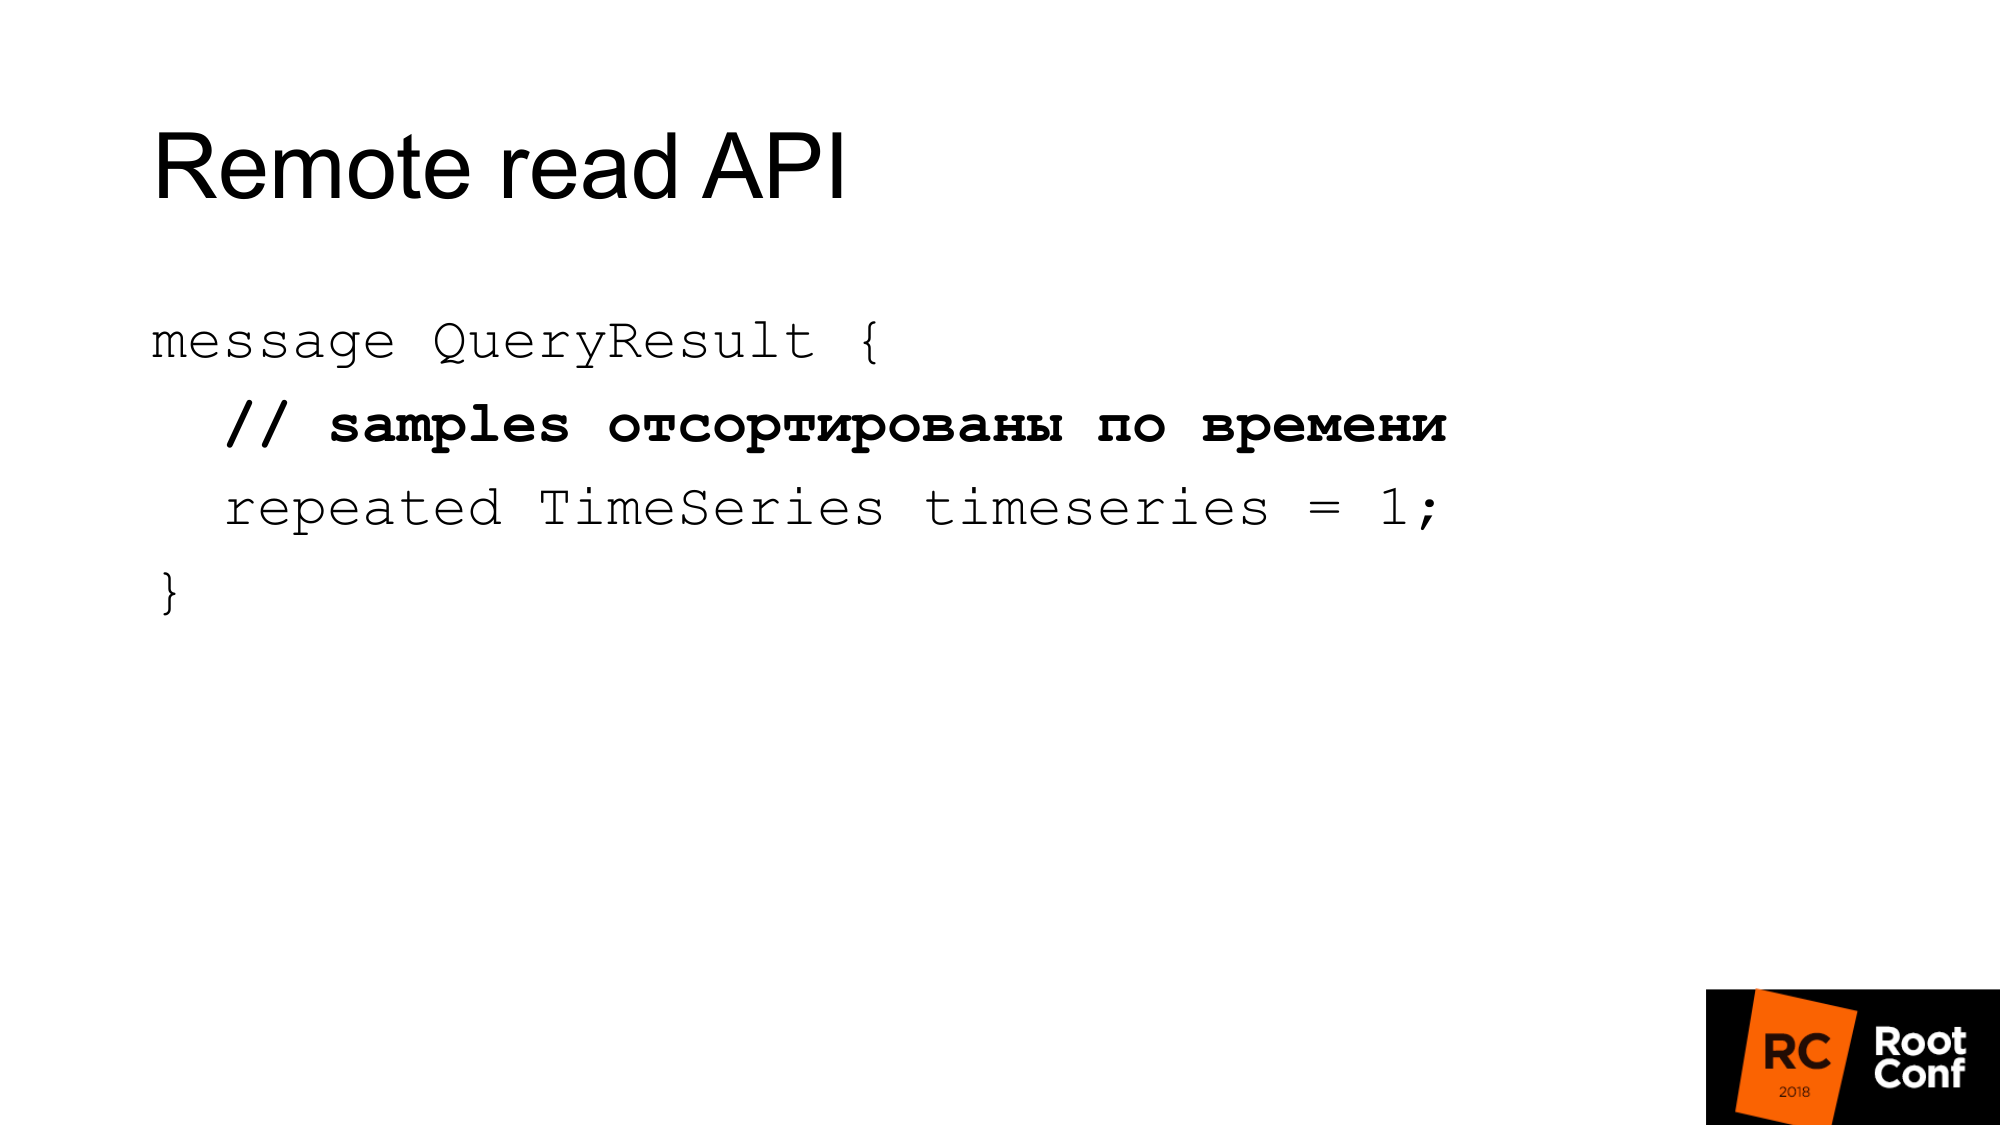
Ответ — это несколько time series, которые соответствуют этому запросу. Здесь сэмплы должны быть отсортированы по времени. опять же это помогает Prometheus немного сэкономить cpu — не нужно сортировать. Но предполагается, что ваша база данных должна это делать. В большинстве случаев так и будет, потому что, скорее всего, там будет индекс по времени.
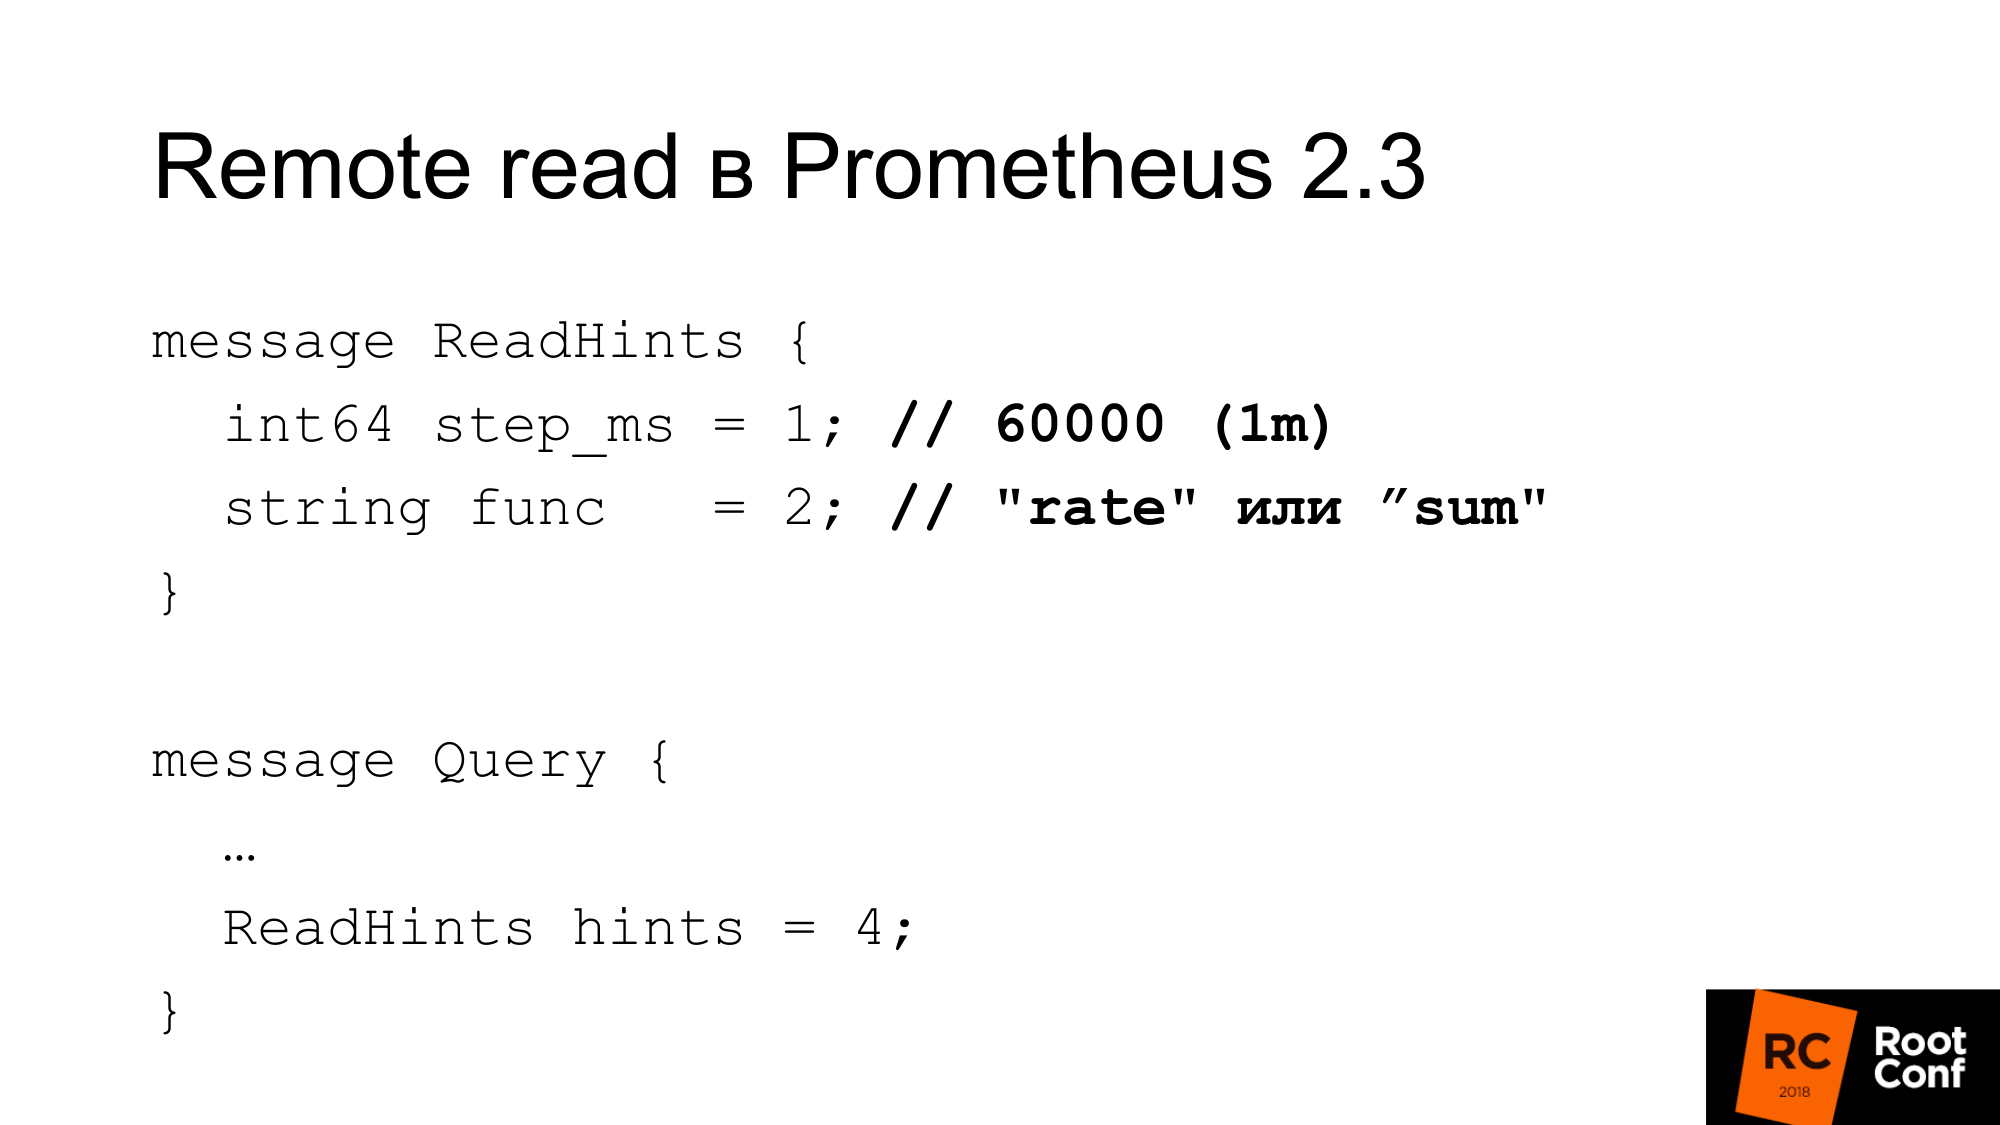
В Prometheus 2.3 появились read hint. Что это такое? Это возможность подсказать Prometheus, какая внутренняя функция, которая работает с time series, которая запрашивается, будет применена. Это может быть либо функция, либо оператор агрегации. Это может быть rate. То есть это назыается func, но на самом деле это может быть sum, который с точки зрения PromQL на самом деле совсем не функция. Это оператор. И шаг. На предыдущем примере там был rate 1 минута. Здесь rate — это будет функция и одна минута в миллисекундах как шаг. Этот hint может игнорироваться remote базой данных. При этом в ответе нет никакого признака, игнорировался или нет.
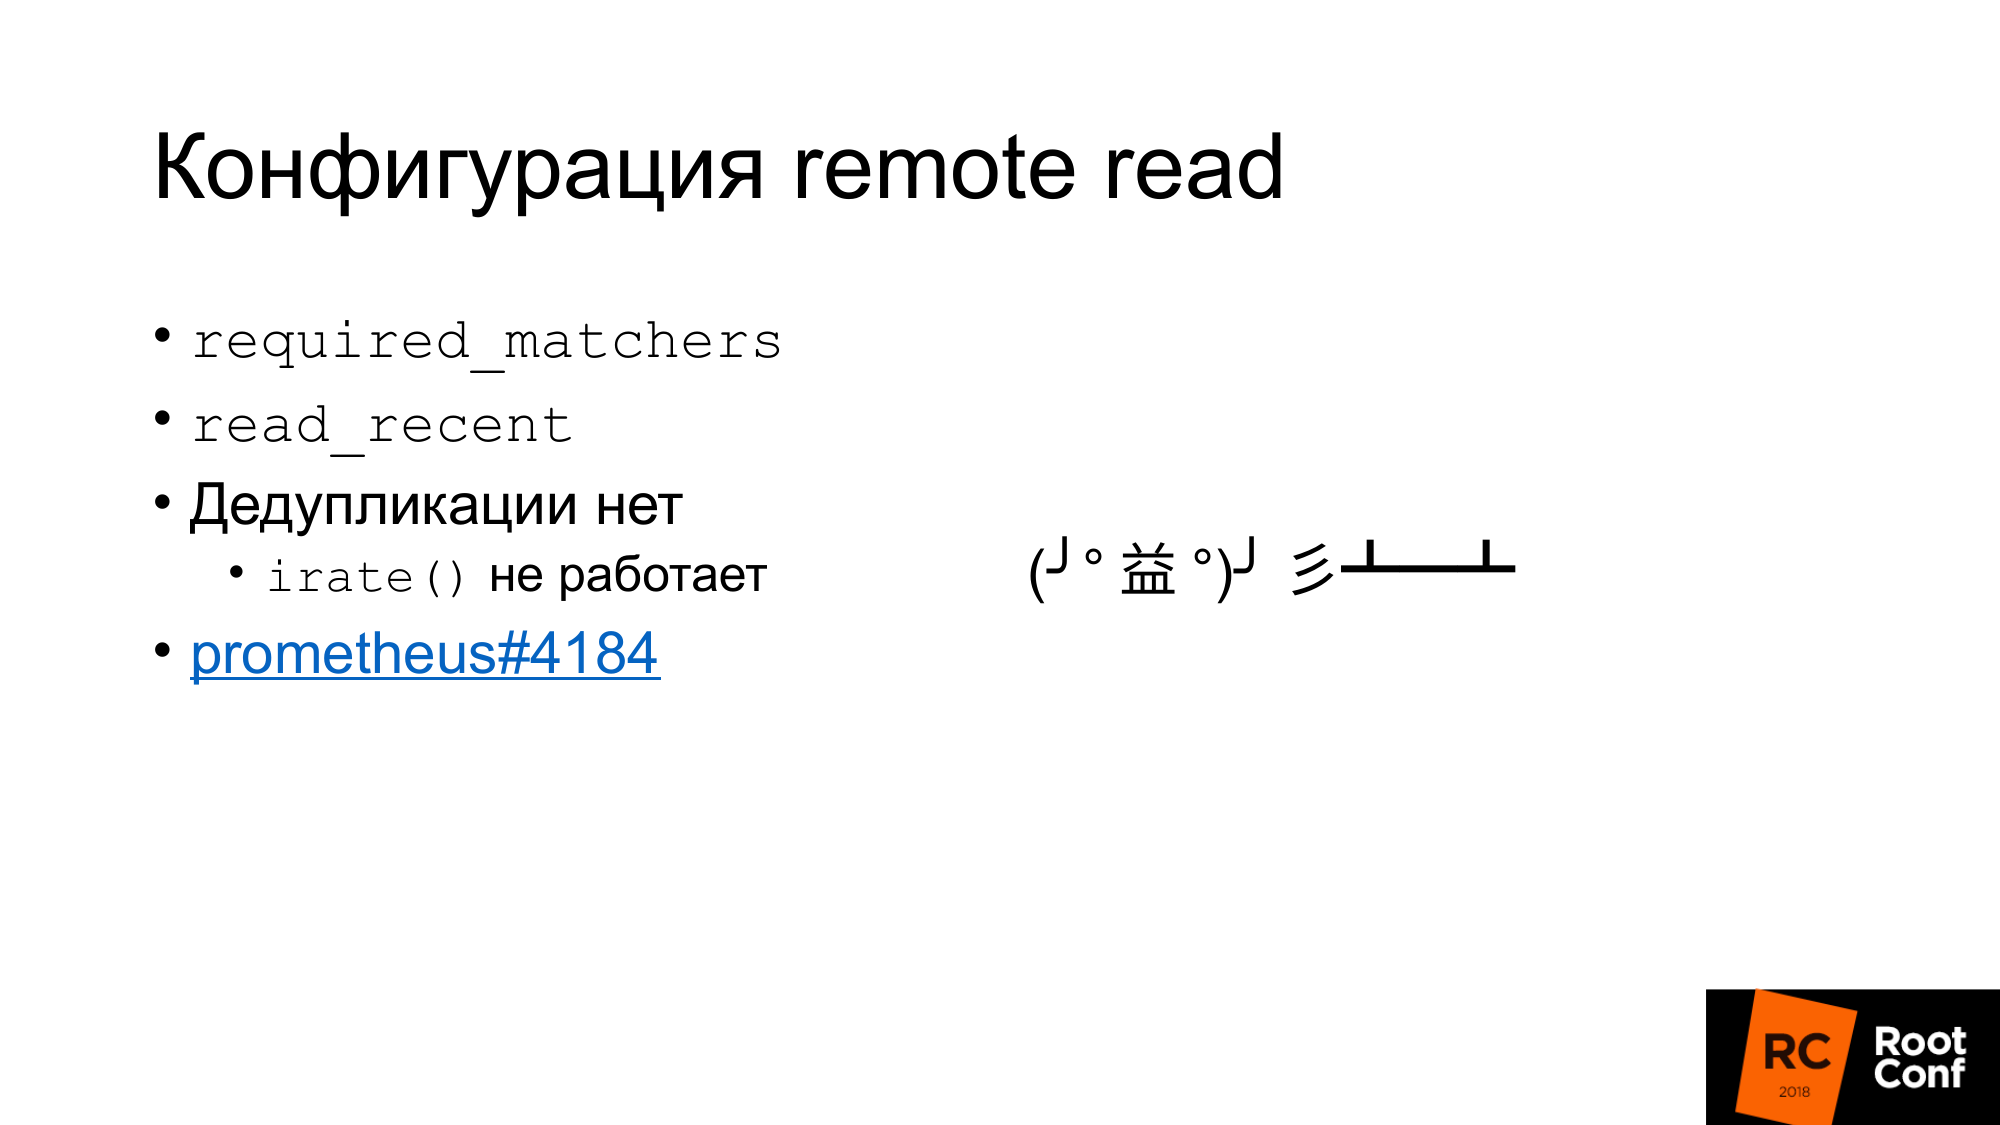
Какая конфигурация у read?
Во-первых, есть такая конфигурация required_matchers. Это позволяет вам отсылать запрос на Remote Storage, которые соответствуют выражению. Чтобы читать агрегированные данные из Remote Storage, необходимо использовать запрос, в составе которого присутстует двоеточие.
Есть опция, которая позволяет вам читать или не читать недавние данные из Remote Storage, которые есть в TSDB. Обычно в стандартной конфигурации есть небольшая локальная TSDB, которая пишется на локальный диск. Она там хранит несколько часов или несколько дней. Данные, которые используете сейчас, которые используется для оповещения, которые используются для построения dashboard, читаются только из локального TSDB. Он быстрый, но не позволяет нам хранить очень много данных.
Старые исторические данные будут читаться из Remote Storage. Это дает понять, как Local Storage и Remote Storage между собой связываются. Отсутствует какая-либо дедупликация.
По сути что происходит. Данные берутся из локального Storage, данные берутся из Remote Storage, если read_recent включен. Они просто сливаются вместе. Казалось бы — это не проблема. Если предполагается, что мы недавние данные никак не downsample’ли, это точно те же данные, они полностью совпадают с локальными данными, у нас будет в два раза больше семплов, на никакие функции не должны влиять. На самом деле нет. Есть функция irate() и парная ей для gauge, которая возвращает нам разницу между двумя последними значениями. Она заглядывает на указанный диапазон времени назад, но при этом использует только два последних значения. Если у нас два последних значения имеют одинаковое время, то разница будет ноль. Это баг и практически невозможно найти его. Это починили буквально четыре дня назад. Bот ticket кому интересно.
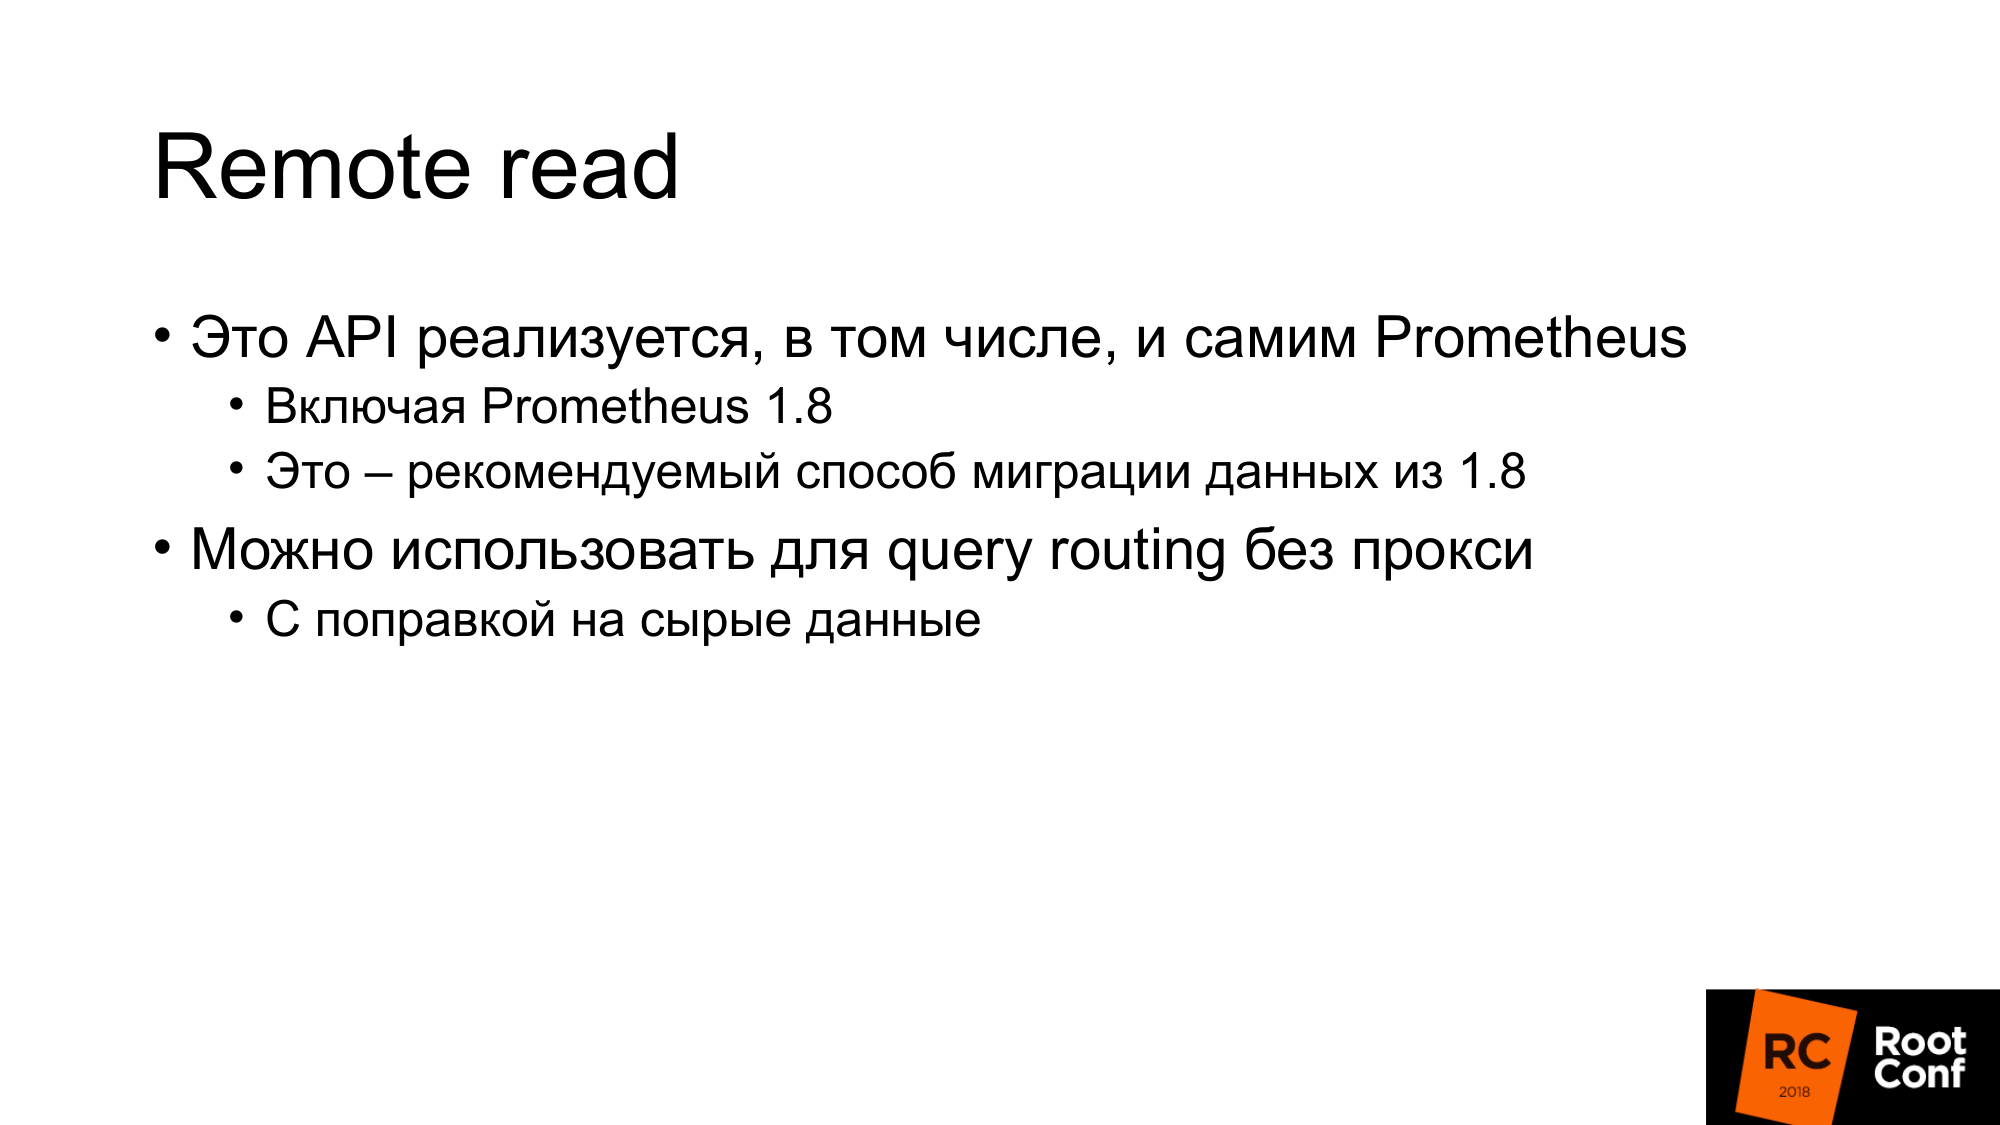
Интересно, что remote read реализуется самим Prometheus начиная с версии 1.8. Именно тот способ, который позволяет вычитывать данные старого Prometheus, когда вы делаете миграцию на версию 2.x. Официальный способ советует подключать его как remote read. Данные будут вычитываться по мере необходимости.
Remote read можно использовать для того, чтобы делать query роутинг без прокси. На одном из предыдущих слайдов я показывал, что в зависимости от времени, мы можем делать роутинг на один Prometheus или другой. Точно так же можем этого избежать. Просто подключаем тот Prometheus, который стоит ниже, как remote read — и данные будут читаться оттуда. Но есть поправка на то, что конечно много данных будет перекачиваться. Особенно если вы не используете query hint.
Для нашего исследовательского решения мы выбрали ClickHouse, потому что мы на него уже давно смотрели. У нас есть люди, которые постоянно занимаются перфомансом баз данных, постоянно проверяют новые базы данных. Наша компания занимается opensource базами данных.
Нам очень нравится его сырая производительность. Его мощность в пересчете на CPU, время и так далее, очень хорошая. Большинство подобных систем говорят про бесконечную маштабируемость, но мало говорят про эффективность для одного сервера. Многие наши клиенты хранят метрики на паре серверов.
Встроенная репликация, шардирование.
GraphiteMergeTree — это специальный движок для хранения данных графита. Нас он вначале очень сильно заинтересовал.
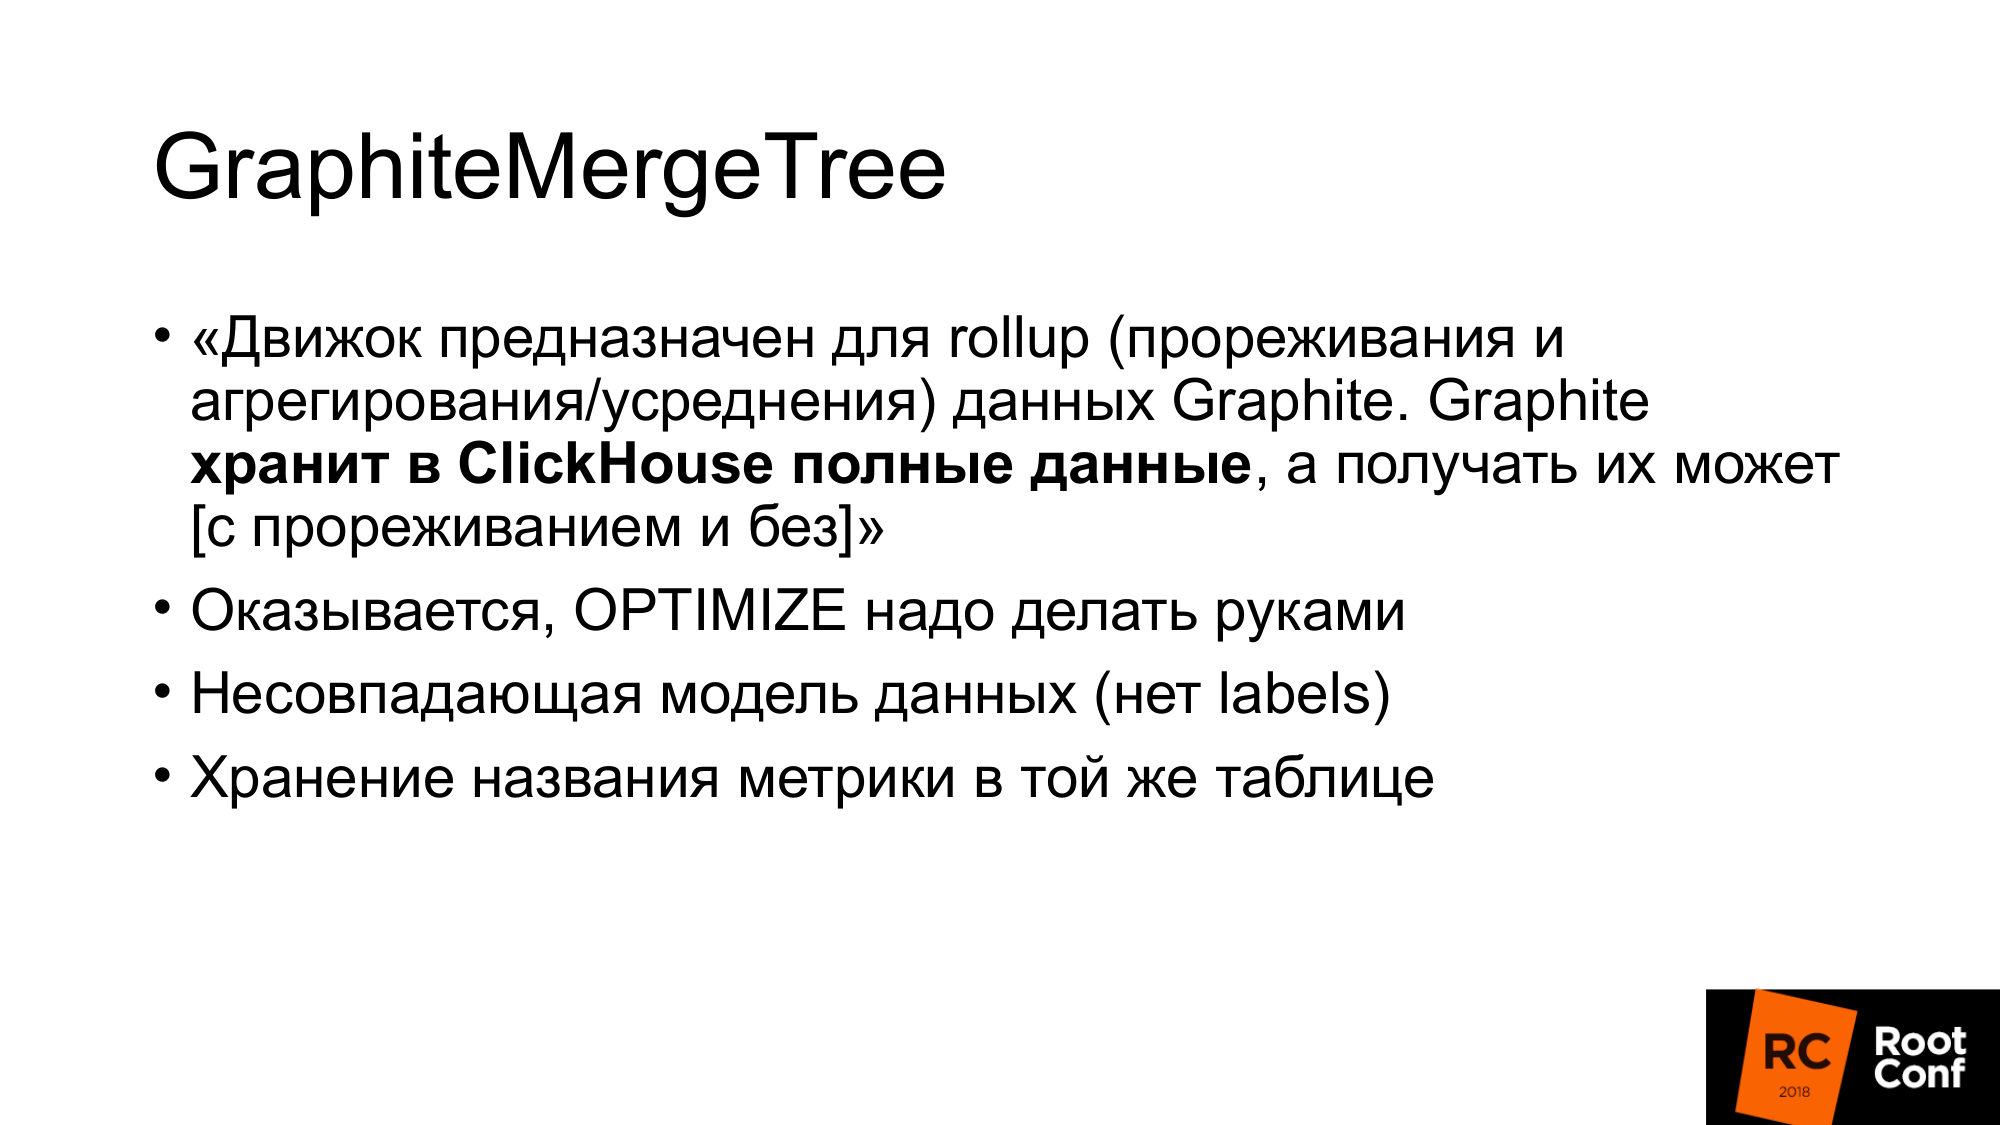
Движок предназначен для rollup (прореживания и агрегирования/усреднения) данных Graphite.
Graphite хранит в ClickHouse полные данные, а получать их может, и дальше там написано, что с прореживанием используется GraphiteMergeTree, без прореживания используеться MergeTree. Ощущение такое, что данные хранятся всегда полные, они не переписываются, это просто оптимизация чтения. Но в целом это неплохо. Когда мы делаем чтение, мы не выкачиваем данные, они автоматически агрегируются, мы получаем мало данных — это хорошо. Минус для нас, что данные хранятся все.
Я готовился в начале месяца к докладу. Кто-то заходит телеграмм чат и спрашивает — «GraphiteMergeTree данные downsample’нные»? Я уже пишу «нет». В документации написано, что нет. Но другой человек из чата отвечает «да, нужно вызвать optimize». Запускаю, проверяю — да правда. В документации по сути баг. Потом прочитал исходный код, проверил, оказывется там есть optimize, optimize final. Optimize final как раз изначально создавался именно для GraphiteMergeTree. На самом деле downsampling он делает. Но его надо вызвать руками.
У GraphiteMergeTree другая модель данных. Нет у него лейблов. Эффективно записать это все в названии метрик не очень хорошо получается.
Название метрик хранятся в одной таблице. Название метрик имеет разную длину. Это приводит к тому что, если мы делаем поиск index по названию метрики, из-за того что длина разная, этот индекс не будет так эффективен как, если бы этот индекс имел значение фиксированной длины. Потому что вам нужно делать поиск по файлу. Нельзя точно указать, куда нужно приземлиться для того, чтобы бинарный поиск делать.
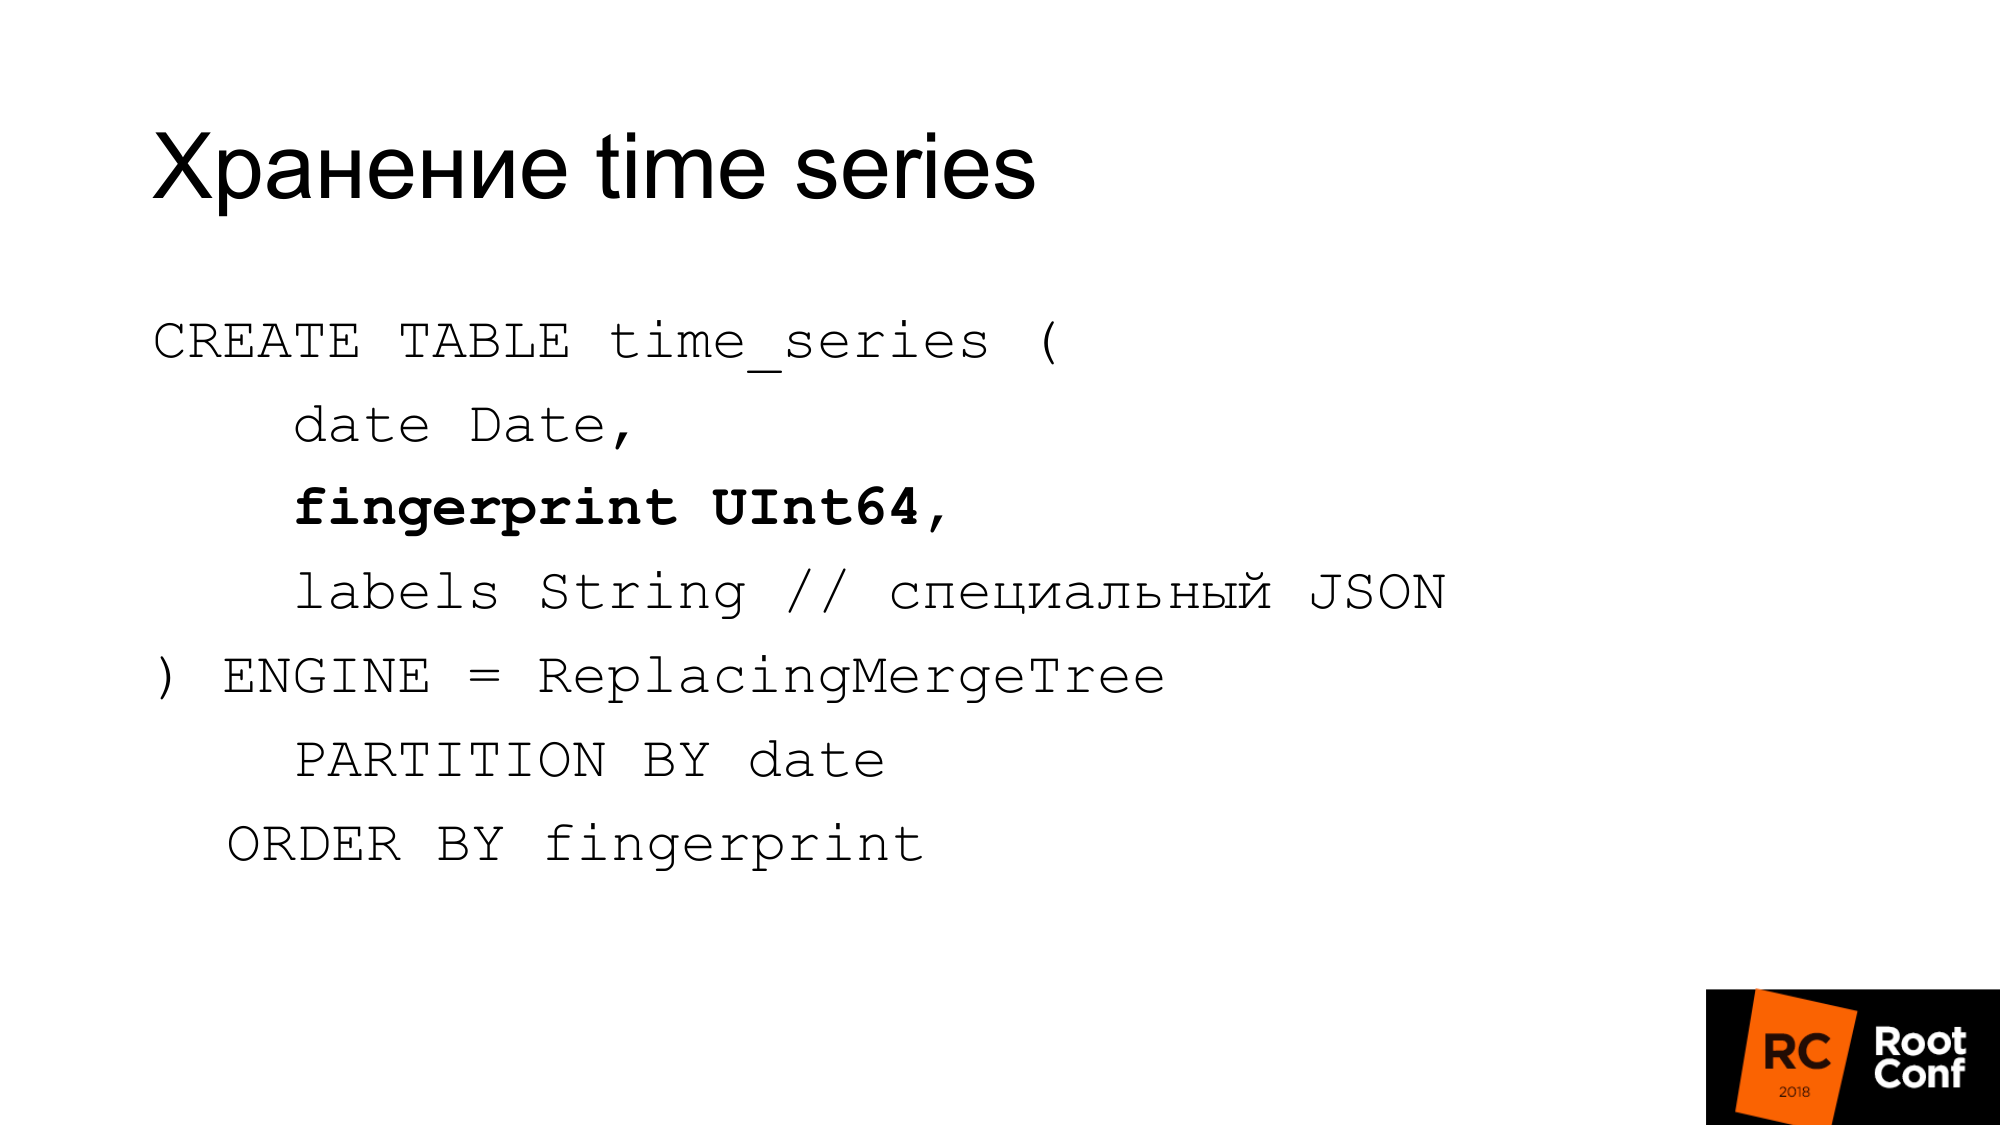
Поэтому сделали свою собственную схему. На слайде показывается, как у нас хранятся time series в базе данных. Date, который нужен ClickHouse — это fingerprint. Если вы смотрели исходники Prometheus или TSDB, то вы знаете, что fingerprint по сути короткая быстрая checksum полного названия time series. Fingerprint — комбинация всех лейблов, ключей и значений. Имя — это обычный лейбл. Мы использует тот же самый алгоритм для совместимости. Если что-то дебажить, то это может быть удобно. Fingerprint совпадает и его можно проверить в TSDB и в нашем storage что они одинаковые. Лейблы хранятся в специальном JSON, который позволяет ClickHouse работать с ним его стандартными функциями. Это компактный JSON без пробелов, с немного упрощенным неймингом. Эта таблица во время работы не используется. Она всегда хранится в памяти нашего собственно решения, которой называется PromHouse. Она используется только, когда мы запускаем сервер для того, чтобы узнать, какие time series есть. Она вычитывается. По мере того, как новые time series приходят, мы их туда записываем. Все несколько инстансов PromHouse могут читать одну и ту же таблицу. ReplacingMergeTree говорит нам о том, что эти time series — есть несколько разных инстансов — пишут одну и ту же time series. Они смержатся — и никакой проблемы здесь не будет.
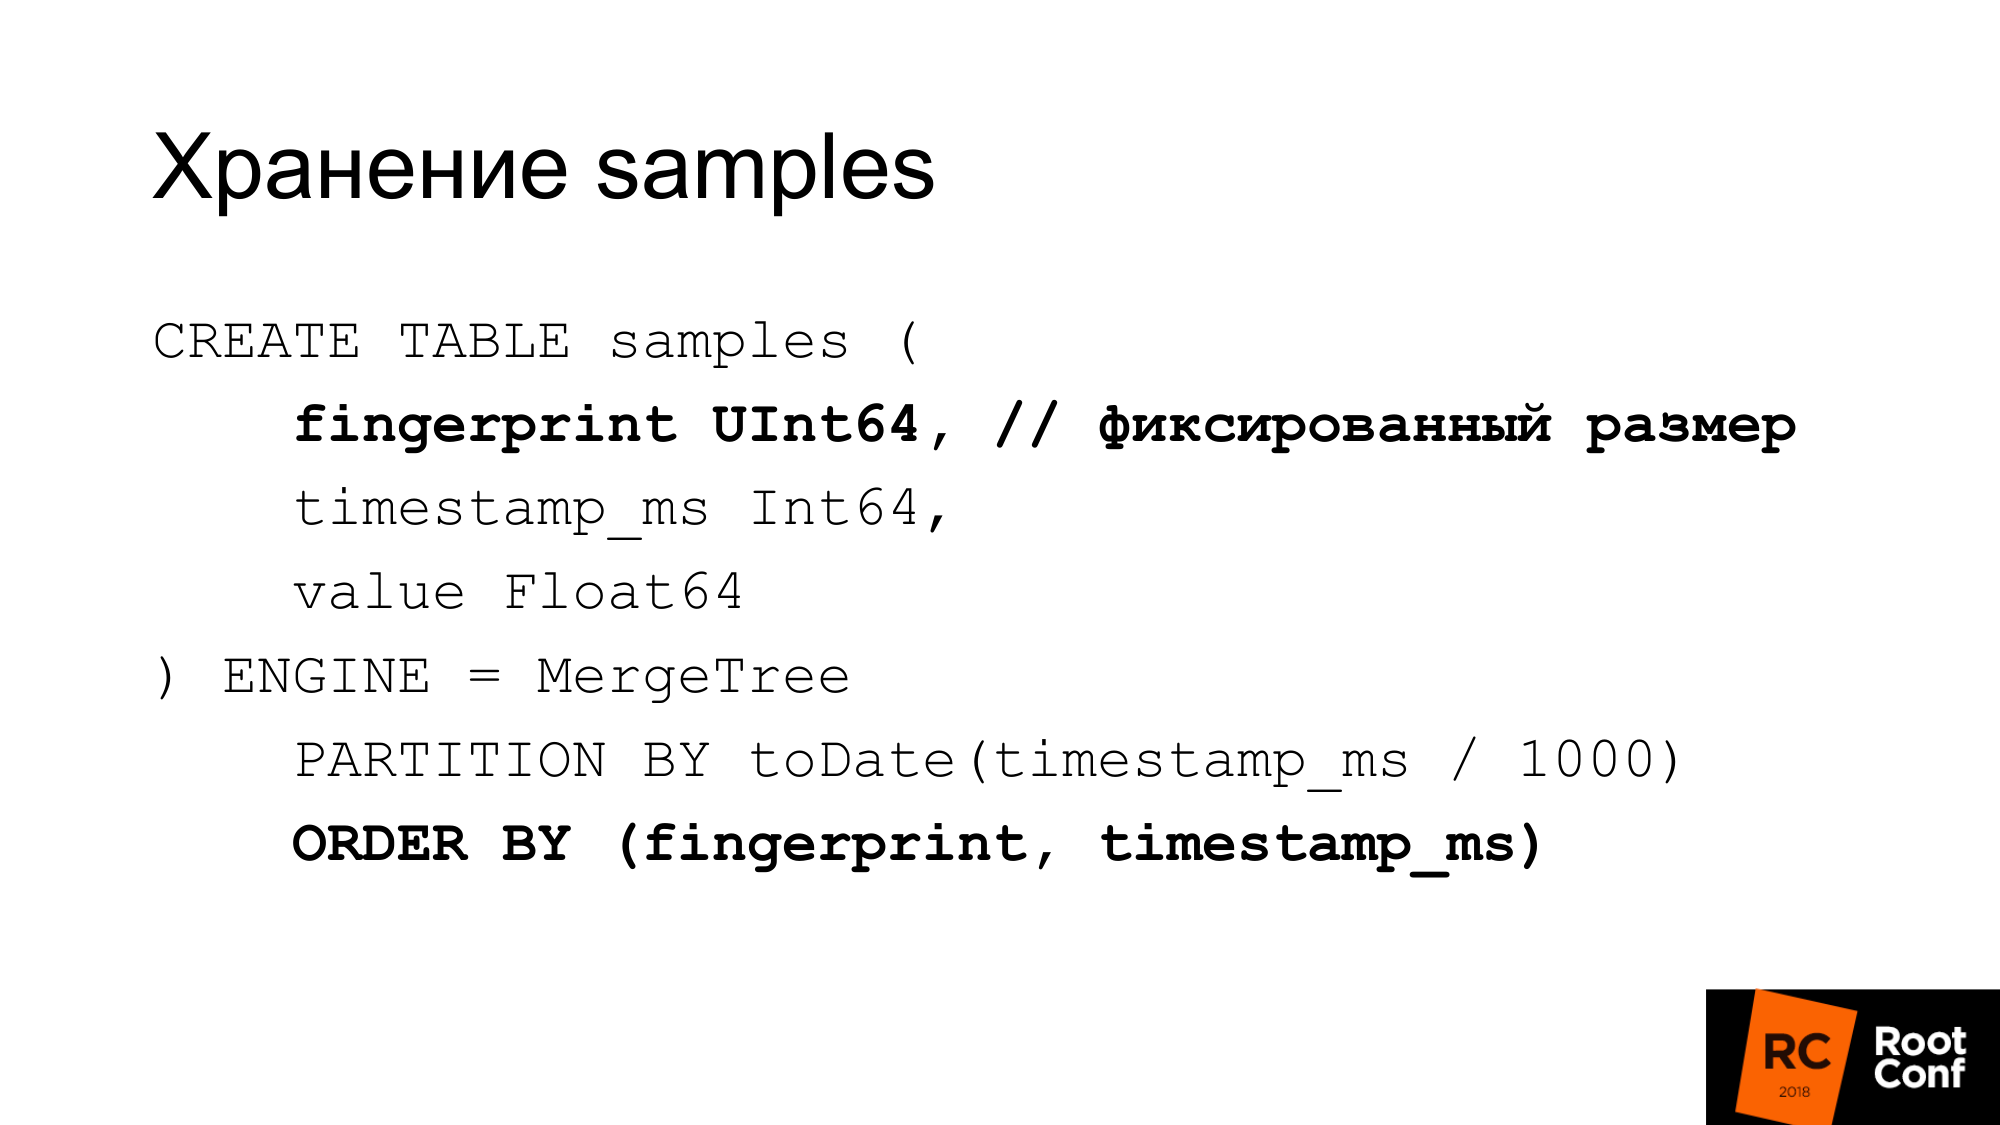
Cэмплы мы храним в отдельной таблице очень эффективно. При значении фиксированной длины этот fingerprint тот же самый, время и значения. У нас получается 24 байта на sample. Оно имеет строго фиксирую длину. Каждая колонка хранится отдельно. Поиск по fingerprint эффективен, потому что мы знаем, что размер фиксированный. Нет такой проблемы как с GraphitmergeTree, когда это строка. Мы используем кастомный(custom) partitioning. Первичный индекс fingerprint и по времени.
24 байта — это в упрощенном варианте. На самом деле он хорошо сжимается. По факту использует меньше места. В наших последних тестах степень компрессии примерно 1 к 42.

Как можем сделать ручной downsampling, если у нас GraphiteMergeTree есть, но не такой, как хотелось бы. По сути мы можем сделать это руками. Как раньше делали шардирование, партицирование, когда ничего встроенного не было. Делаем руками новую таблицу. Когда к нам приходит сэмпл по времени, определяем, в какую таблицу пишем.
Выбираем по времени из запроса, из какой таблицы читать. Если чтение происходит на границе, читаем несколько таблиц. Дальше мержим эти данные. Можно было бы использовать view для этого. Например, сделать view для несколько таблиц, который позволяет это читать одним запросом. Но в ClickHouse есть баг: предикат из view не подставляется в запросы. Поэтому если вы делаете запрос в view, то он идет на все таблицы. View мы не можем использовать.
Как мы делаем downsampling? Мы создаем временную таблицу. Копируем из нее данные insert into select, используя правильные функции.
Делаем rename, который атомарный под глобальным локом. Мы переименовываем существующую таблицу в старую. Новую в существующую. Дропаем старую таблицу. У нас данные за 148 день уже downsampling. Какая здесь проблема? Insert into красиво выглядит. На самом деле нам нужно применить правильные функции, правильную агрегацию сделать. На практике это не получается сделать одним большим запросом. Даже несколькими большими запросами не получается сделать. Это приходится делать из кода. Код посылает большое количество небольших запросов. Мы по-максимуму старались это сделать большими запросами, но это не очень эффективно получается. Downsampling данных одного дня пока что занимает меньше дня. В зависимости от количества данных может занимать долгое время.
В ClickHouse будут update/delete. Delete уже первую версию вмержили. Если будут работать update/delete, то наша схема downsampling данных может упроститься.
Во-вторых, в ClickHouse есть задача сделать кастомное сжатие (дельта, дельта в дельта). Это то, что делает TSDB. Это хорошо подходит для time series данных. Это особенно полезно, если мы будем иметь возможность выбирать тип компрессии в зависимости от типов данных. Например, counter, который только растет — для этого подходит дельта-дельта компрессия. Gauge, который колеблется вокруг величины, поэтому дельта хорошо работает.
Есть другие storage, которые работают. Есть InfluxDB, который работает из коробки. Его принято ругать за скорость, но то, что работает из коробки и вам ничего не нужно делать — это хорошо.
Есть OpenTSDB и Graphite, который только на запись. Стандартный адаптер из Prometheus не особо работает.
Есть CrateDB. Есть TimescaleDB, который fork PostgreSQL для time series баз данных. Говорят работает неплохо, но сами мы не пробовали.
Есть Cortex, который также был известен как проект франкенштейн. Это очень хорошо его описывает. Это ребята пытаются сделать решение на основе федерации Prometheus. Они хранят данные в S3.
- У него очень интересная архитектура. Есть Prometheus, который использует локальный TSDB. Между ними создается кластер. Рядом с каждым Prometheus ставится специальный side-car, который по remote read и remote write API принимает запросы. Эти запросы он перенаправляет в Prometheus. Prometheus может использовать его remote read и remote write API. Все side-car соединенные между собой и между кастомным API мастера через gRPC, доступна репликация, есть перешардирование.
- Сложная архитектура.
- Оно довольно сыровато. Пару месяцев назад оно разваливалась с полпинка, когда запускалось.
Используя Pull-модель, много данных не записать. Нужно ждать целый год для заполения годичных данных. Мы же пытаемся как-то их туда записать.
В Prometheus отсутствует remote write, поэтому в локальный TSDB записать много данных не получится.
Вторая проблема. Если мы генерируем данные для нагрузочного тестирования, то они часто хорошо жмутся. Например, если мы берем существующие данные и генерируем 100 инстансов, и это одинаковые данные, то там коэффициент сжатия будет такой прекрасный, что в реальности не случаются.
Мы написали fake экспортер, который выглядит как обычный экспортер, который Prometheus может скрепить:
- Когда приходит скрейп, он идет на какой-то апстримовский экспортер. Берет с него данные.
- Генерирует много инстансов. Допустим скрейпит 1, а на выходе получаем 100.
- Немного меняет данные: плюс минус 10 % для counter и gauge.
- Не меняет простые значения 0 или 1. Потому что если есть метрика UP, которая ответчает показывает запущен ли сервис: да — 1 или нет — 0. И не очень понятно что означает 098 UP.
- Не меняем целые числа на вещественные и наоборот.
- Просто отдает данные в обычном формате expfmt.
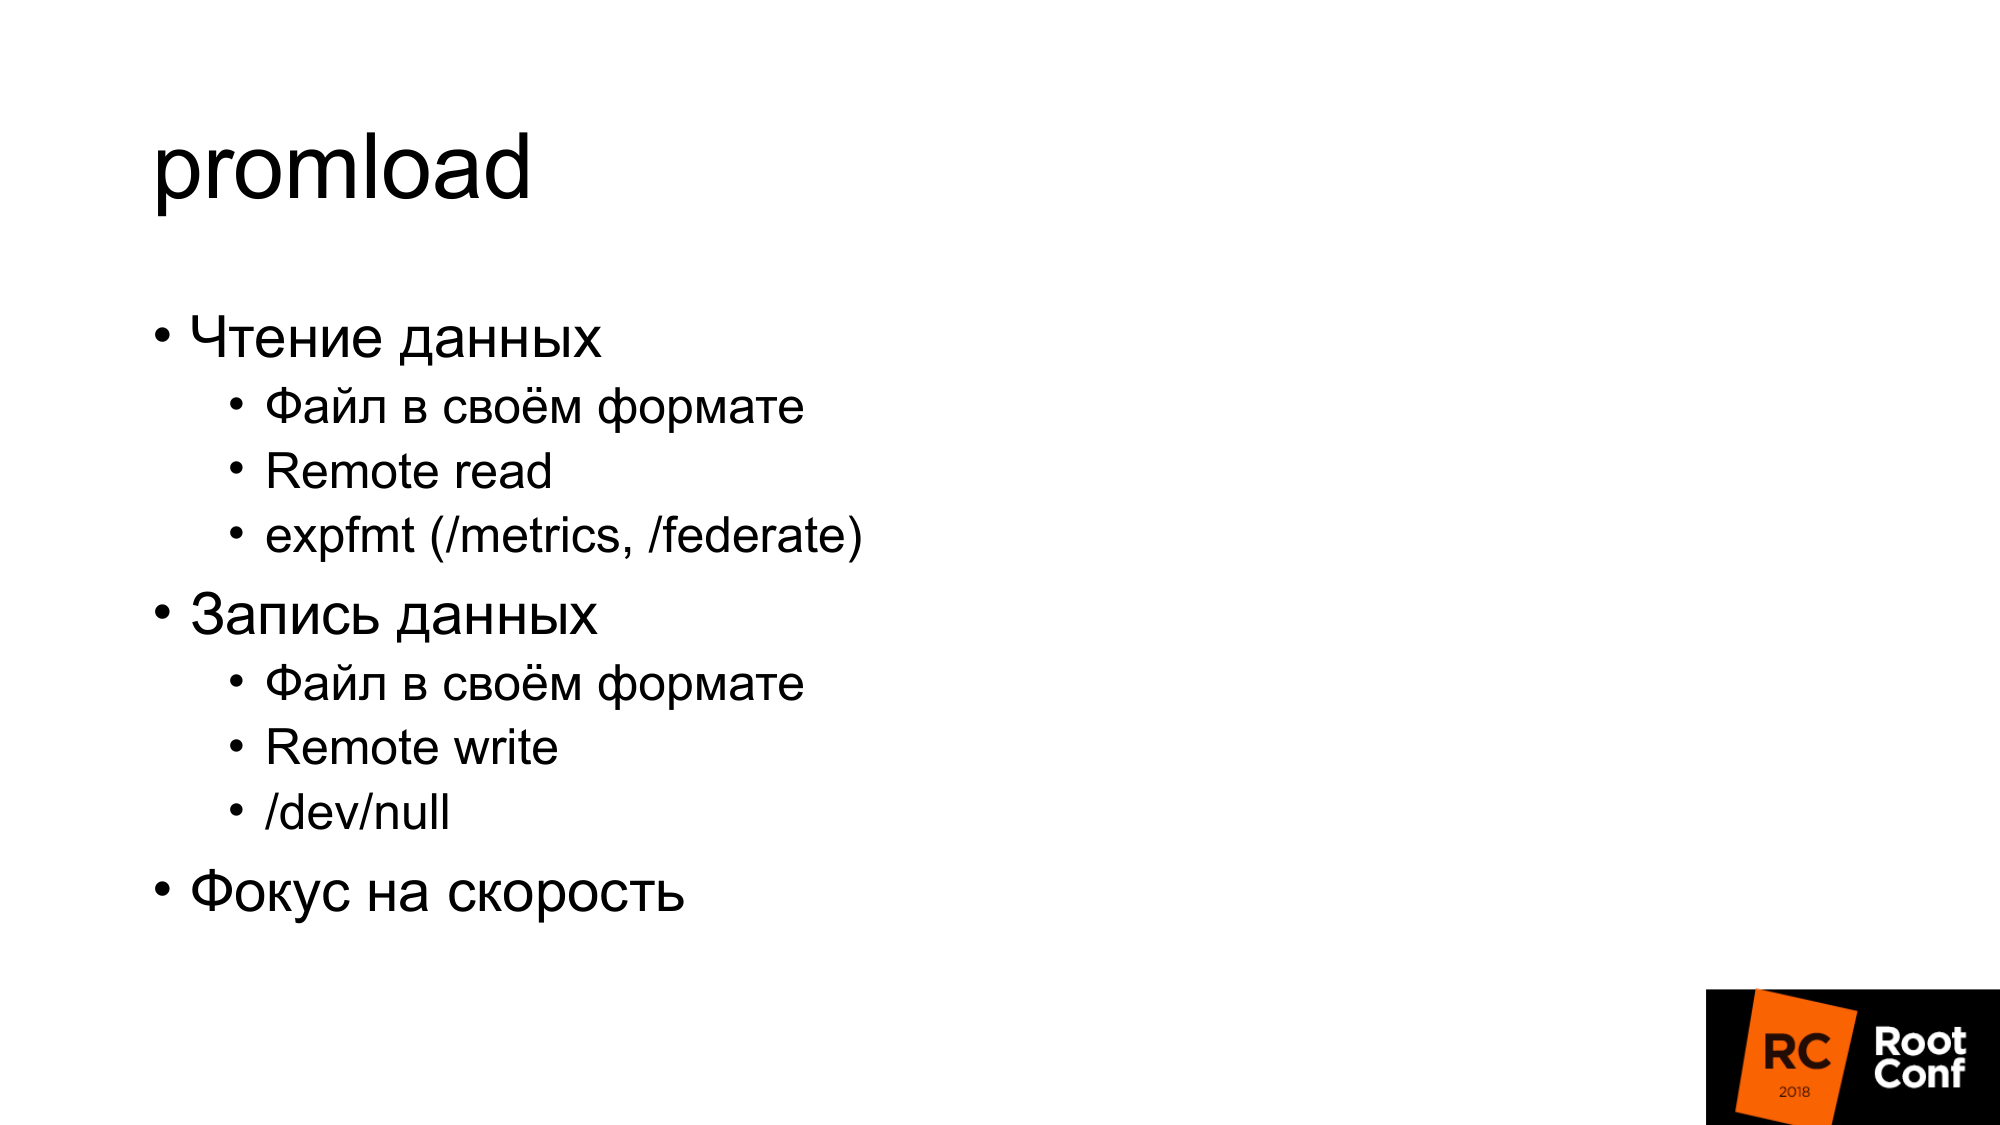
Инструмент promload, который грузит данные. Чтение данных:
- Может читать из файлов в своем формате
- Может из remote read
- Может из какого-то экспортера читать
Пишет в разные форматы. В том числе в /dev/null, если мы хотим протестировать именно как чтение быстро работает.
Сейчас это инструмент нагрузочного тестирования не только для PromHouse, но и для любого решения, который использует remote read или Prometheus.
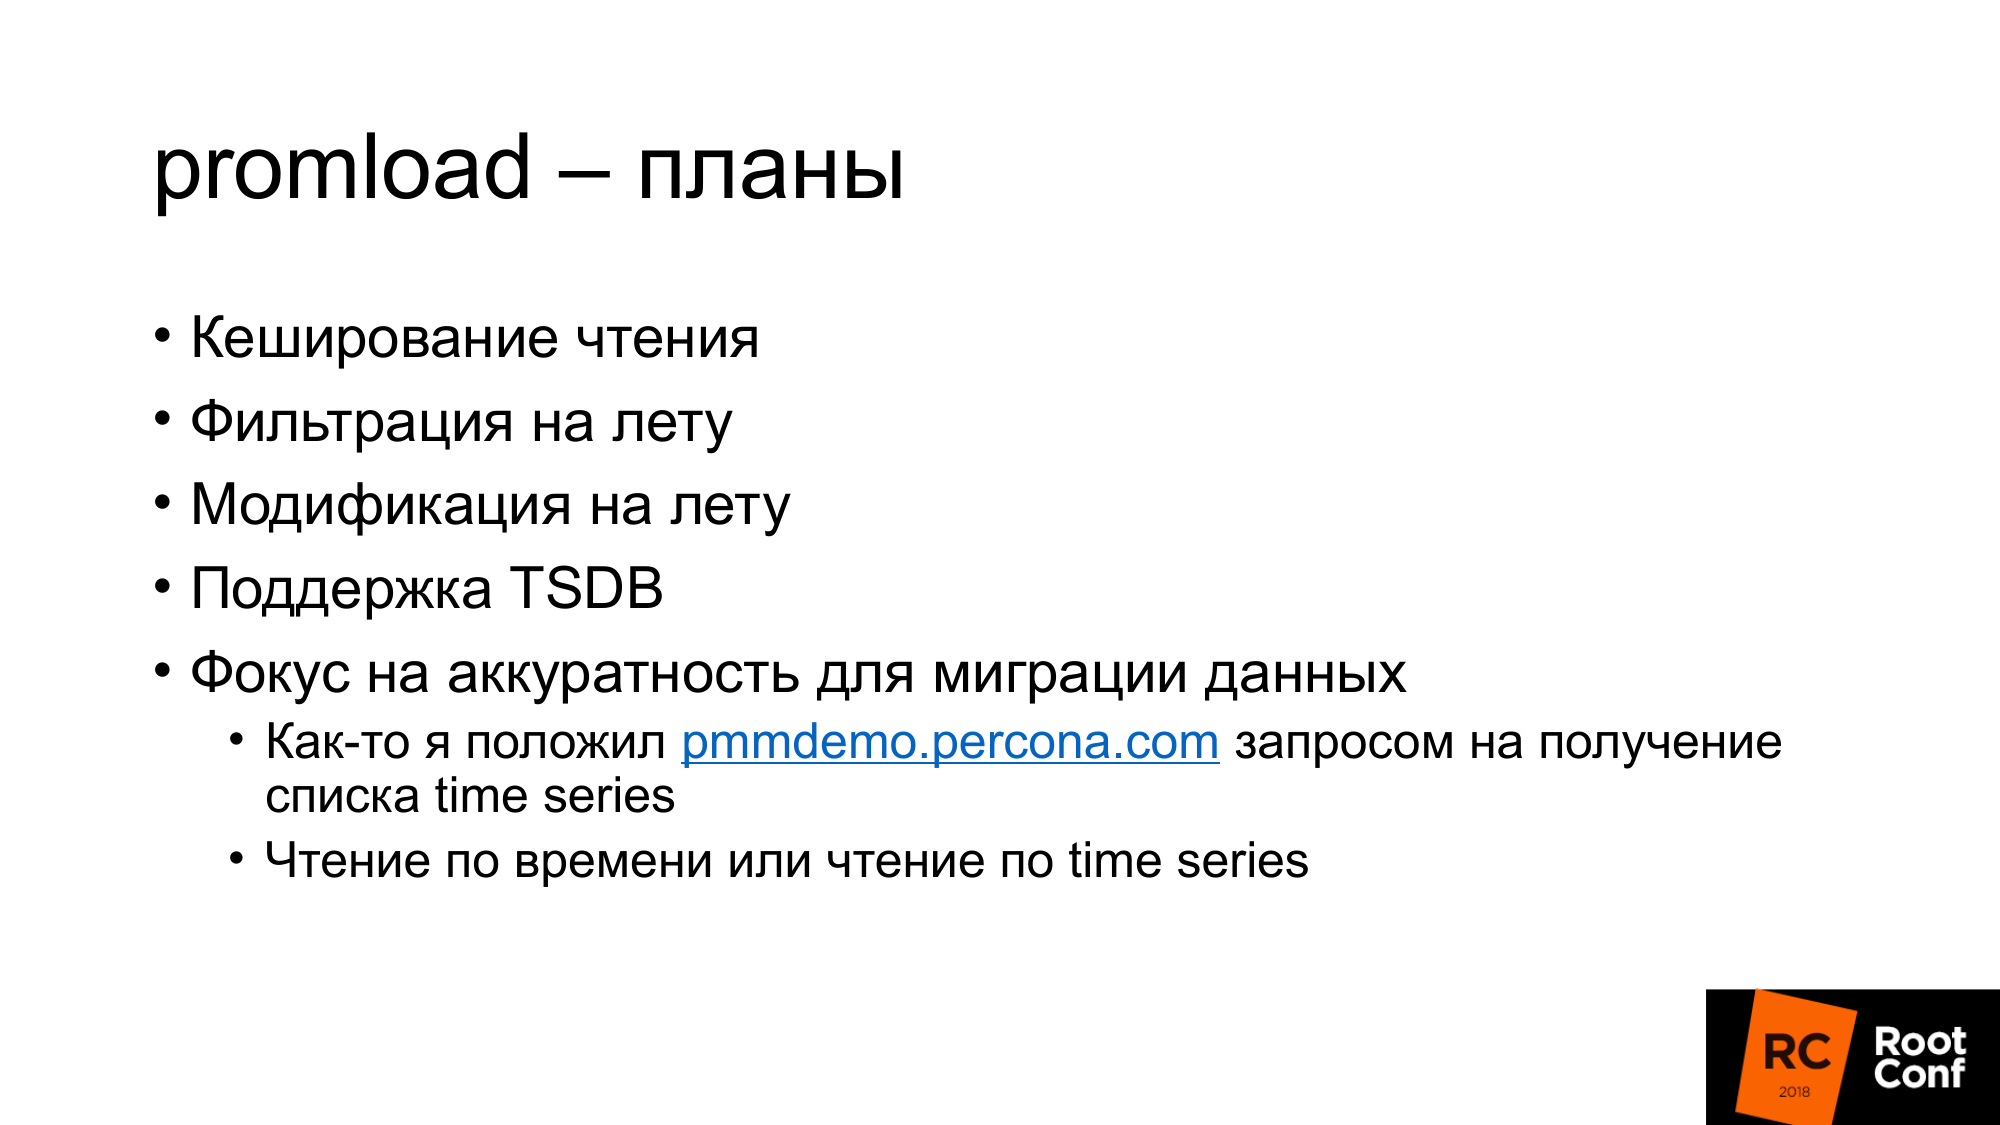
Мы хотим добавить кеширование чтения, потому что в наших тестах часто узким местом был именно fake экспортер, который долго генерировал данные. Мы могли бы их кэшировать. Пусть они будут нереально хорошие. Зато мы не будем тормозить. Нам не нужно было днями ждать нагрузочного тестирования.
Какая-то фильтрация на лету, какая-то модификация на лету.
Нативная поддержка TSDB. Для того чтобы именно работать с базой данных на диске, а не через API.
Фокус на аккуратность для миграции. Я один раз pmmdemo.percona.com положил: подключился, получил все метрики. Если вы делаете это нативным способом, то Prometheus открывает TSDB, поднимает все time series с диска, поднимает индексы, дальше лезет в chunk файлы, понимает что они реально есть. В этот момент все может просто лечь.
Наивный подход — это взять все time series и читать начиная со старых данных до новых. В этот момент он ляжет. Вам нужно сделать наоборот. Нужно сначала получить список time series несколькими запросами с регулярными выражениями. Например, time series, которые начинаются на A. Потом дай мне time series, которые начинаются на B. Дальше грузить их именно по метрикам, а не по времени. Это нелогично, но так это работает. Это нюанс, если вы будете делать что-то такое подобно. Если увидите, что там OOM Killer случился, то вы будете знать, что это из-за вас.
Результаты нагрузочного тестирования, графиков не будет. Нагрузочное тестирование занимает много времени и, к сожалению, из-за ошибки конфигурации все закрешилось. Поэтому результаты не получились.
В блоге Percona мы напишем, когда сделаем нагрузочное тестирование.
Могу сказать результаты без графиков. Запись была линейна. Чтение скакало и было не очень быстро. Нам не очень важно чтение текущих данных. Их можно через read hints ускорить. Можно включить read_recent для улучшения чтения. А для старых данных это нормально работает.
Люди хотят долговременные хранилища. Такой спрос есть. Мы делали доклад про PromHouse на PromCon. Там это была очень горячая тема. Thanos активно развивается.
Это уже возможно сейчас. Есть для этого решения. Есть API. Есть какие-то интеграции. Но все это нужно дорабатывать напильником. Нет production ready решений.
Ссылки где посмотреть. Первая ссылка — репозиторий PromHouse. Вторая ссылка — это куда он скорее всего переедет. Сейчас в одном репозиторий несколько разных вещей? не очень тесно связанных между собой. Поэтому нужно будет их переносить.
В нашем блоге будет информация про performance и какие-то новости.
Вопрос: Не проверяли ли вы слухи про InfluxDB?
Ответ: Он был не очень хороший. Он сильно лучше стал. Все эти байки про то что InfluxDB медленный, разваливается — они про старую версию. Текущая версия работает стабильно. Я бы не сказал? что она быстро работает. Но она работает стабильно. Плюсы InfluxDB на мой взгляд:
- Во-первых, не нужно делать что-то рядом, потому что InfluxDB работает из коробки.
- Во-вторых, в ClickHouse, как в других решениях на основе базы данных, но не TSDB, вы можете использовать язык запросов, который вам более знаком. Язык запросов InfluxDB похож на SQL. На нем можно делать аналитику, которую на PromQL делать сложно. Если вы использете TimeScaleDB — там настоящий SQL.
Вопрос: движок GraphiteMergeTree только на запись получается? Если мы хотим графики показывать, Grafana необходимо настраивать на Graphite, чтобы показывать долговременное хранилище?
Ответ: Да. Интеграция, которая есть в самом Prometheus, работает только на запись. Он только пишет данные. Поэтому из Grafana вы ходите в Graphite.
Вопрос: И он теряет лейблы когда пишет?
Ответ: Там есть конфигурация, которая говорит, что с ними делать, как их вставлять, куда вставлять.
Информация из зала: Avito рассказывал, что они пишут свое решение для записей из Prometheus в Graphite.
Вопрос: там был вывод, что с записью все хорошо на сервер долговременного хранения.
Идет поток миллион метрик (5-минутки или 15-минутки). Хватит ли raid 6 sata дисков для хранения данных за год?
Ответ: В PMM у нас основной интервал скрейпинга — это секунда. При этом downsampling мы делаем начиная c 14 дня до 1 минуты. Второй шаг, мы пока ещё ни разу не делали. Мы не агрегируем эти данные по одной минуте еще меньше. Это занимало сотни гигабайт. Не было колебания скорости записи.
Вопрос: Данных по IOPS там нет?
Ответ: Нижняя часть нагрузочного тестирования псевдонаучная.
Вопрос: Поэтому и спрашиваю вашего опыта
Ответ: Наш опыт пока ничего плохого и не заметил. Но конечно, нам бы хотелось довести нормальное тестирование до конца. Описать метологию, результаты, сделать графики.
Вопрос: Если мы пишем в InfluxDB, то мы можем запрашивать долговременных данные из InfluxDB?
Ответ: Это зависит от read_recent. Это точно так же, как и с любым другим remote storage. Ничего уникального для InfluxDB нет. В зависимости от настройки. Если read_recent включен, то будем читать.
Вопрос: Например, для оперативных данных используем Prometheus. Долговременные данные пишем в InfluxDB. Grafana настраиваем на Prometheus. Prometheus может по PromQL вытаскивать оперативные данные и то, что записано в InfluxDB?
Вопрос: Prometheus уже будет ходить в InfluxDB и вытаскивать и рисовать в Grafana?
Ответ: Да. При этом у Prometheus версии 2.2 не будет дедупликации и у вас будет проблема, о которой я говорил.
Prometheus TSDB internals
Prometheus has local and remote storage. At the beginning, it creates a local storage, a remote storage, and a fanout storage. A fanout storage is like a wrapper storage that wraps a primary storage and multiple secondary storages, which proxies reads and writes through to the underlying.
Internally, Prometheus uses a type of struct called Head to maintain a series of data, and to persist the in-memory data to the disk.
When opening a local db by tsdb.Open() , it loads data from the write ahead log and prepares the head for writes. It then starts a goroutine to compact two-hour blocks per minute (with exponential backoff on error).
Memory series
In Prometheus, a series is a struct of type memSeries , which contains an ID (also called ref ), a label set, and other fields.
A series holds a slice of memory chunks that each of them is of type memChunk , which is used to store timestamp and value pairs (samples). Samples are appended (encoded) into a memory chunk. When some condition matches, a chunk is marked as complete (it will be compacted) and a new chunk is created (analogous to cut ). The headChunk field always points to the current chunk to append.
What’s the condition that a new chuck should be created? nextAt is a field that indicates that. If the sample’s timestamp is greater than or equal to nextAt , a new chunk should be created. nextAt is initialized by chunkRange field (by default it’s 2 hours), but is changed by its increasing velocity when it’s 25% full of 120 samples. The number 120 is based on Gorilla white papers, which offers near-optimal compression ratio.
Tip: For more information about Gorilla white papers, please visit here.
Internally, memChunk is a wrapper around chunkenc.XORChunk . chunkenc.XORChunk and its appender implements Gorilla. Each XORChunk has a bits stream, samples are encoded and compressed into that stream. When compacting the chunk, it checks if the remainder capacity of the bits stream is over a threshold (32). If so, it will decrease the capacity by copying it to a new slice of bytes.
Head handles reads and writes of time series data within a time window. It holds a lastSeriesID filed of type uint64 , which starts at 1 for the first series and increases by 1 every time.
Stripe series
Head holds a series field which is of type stripeSeries . When creating a stripeSeries , the size by default is 2^14.
The stripeSeries is like a list of buckets. Each bucket has a map[uint64]*memSeries , seriesHashmap and a stripeLock . map[uint64]*memSeries is a map of series ID and series value. seriesHashmap is a map of hash value of series label set and a slice of *memSeries . Why this? Because the hash value of series label set may not be unique, so it needs to use a slice to store series values.
So by using such a struct, it not only can quickly find a series by its ID, but also by a label set. Given an ID, it finds the bucket by id & size — 1 . Given a label set hash, it finds the bucket by hash & size — 1 .
Head appender
In every scrape, Head returns a new headAppender which the scraper uses to add samples.
For adding, it has two methods: Add and AddFast . Add first checks if the series identified by the passed label set already exists in stripeSeries . If not, it creates one, adds it to stripeSeries and postings . For each label, it collects possible values for the label name into values , and adds its name and value as keys of a symbols map. Note that stripeSeries , postings , values and symbols are all fields of the head. Finally, it adds the created series to series field of headAppender (used when writing WAL) and calls AddFast to do remainder work.
As it name suggests, AddFast runs faster because it doesn’t need to create a series. It should only be called when a series has already been created in the head. It finds the created series by ID from the head, and then adds the sample and series to samples slice and sampleSeries slice respectively (the two slices are one-to-one).
When all samples for a scrape are added in headAppender , the scraper calls headAppender.Commit() to complete. It checks if there are newly created series ( series is not empty), if so, it writes them to ahead log. Then it checks if samples is empty, if not, it writes them to ahead log. Finally, it iterates samples , add appends each sample to its series. It’s at this time that all samples for a scrape are truly added to series.
Compact
The compactor first checks whether the head is compactable. If yes, it compacts head. Finally, it compacts blocks. When the head time range is 1.5 times the chunk range, the head will be compacted.
Compact head
For this operation, it mainly calls Compactor.Write . It allocates a new ULID , and initializes a BlockMeta with min/max time range and compaction information. It then creates a new temporary directory with <ULID>.tmp as name. It populates a block, and writes BlockMeta to a meta.json file in the block root directory. After that, it creates an empty tombstones file by passing in an empty in-memory tombstone reader. Finally, it replaces the temporary directory name with ULID .
The relevant code location is shown in below snippet.
Compact data if possible. After successful compaction blocks are reloaded which will also trigger blocks to be deleted that fall out of the retention window. If no blocks are compacted, the retention window state doesn’t change. Thus, this is sufficient to reliably delete old data. Old blocks are only deleted on reload based on the new block’s parent information. See DB.reload documentation for further information.
Postings
Postings is a struct that stores a map of label name and a map of label value and series id pair pair. That’s to say, the key of the top level map is the label name from a set of labels, with its value being a map. Furthermore, The key of the second level map is the label value from a set of labels, with its value being a slice of the series ids. So we can quickly get all series ids by a label.
It also provides an empty label which is called allPostingsKey . When adding a new series id for a set of labels, the series id is also added for that empty label. So we can quickly get all series ids in one Postings .
On-disk layout
The directory structure of a Prometheus server’s data directory looks something like this:
Chunks
Each chunks file is composed of the following:
- A header section which contains a magic number, a format version, and some padding bytes.
- Multiple chunk sections that each of them contains a chunk of encoded timestamp/value pairs.
Chunks are segmented into segment files when its file size is over 512MiB. A chunk in a file can be referenced from the index file by uint64. The lower 4 bytes of the reference value is the chunk’s offset in the file, and the higher 4 bytes are the segment sequence number.
Tip: For more information about the chunks file format, please visit here.
Index
The index file format is composed of following sections:
- A header section which contains a magic number and format version.
- A symbol table section which holds a sorted list of deduplicated strings to reduce the total index size, and are referenced by subsequent sections.
- A series section which contains a sequence of series. Each of them contains its label set and chunks. The chunk contains time range information and chunk file’s offset from which the chunk data begins.
- Multiple label index sections which are no longer used.
- Multiple postings sections that each of them contains a list of series which are associated with a given label name and value.
- A label index table section which is no longer used.
- A postings table section which contains a sequence of postings offset entries. Each entry contains a label pair and an offset of the index file from which the postings (that contains a sequence of series) begins.
- A TOC (table of contents) section that contains the offsets to the beginning of the above sections.
Tip: For more information about the index file format, please visit here.
Tombstones
The tombstones file is composed of the following:
- A header section which contains a magic number and format version.
- A tombstones section that contains a sequence of tombstone. Each tombstone contains a ref and a time range.
Tip: For more information about the tombstones file format, please visit here.